L'alternativa a fal.ai
Ogni modello media.
Una chiave API.
1102 modelli per immagini, video, audio, 3D e linguaggio veloci, convenienti e pronti da chiamare. Addebitati per output, mai per tempo GPU. In più, studio nel browser per tutto il tuo team.
Perché gli sviluppatori rilasciano su WaveSpeedAI
Veloce.
Inferenza velocissima su ogni modello. Le tue immagini e i tuoi video arrivano in fretta, nello studio e tramite API.
Conveniente.
Immagini da $0.024, video da $0.02 per esecuzione. Paghi solo ciò che generi, senza abbonamento e senza canone mensile.
- Modelli media
- 1,102+
- Modelli linguistici
- 128+
- Sviluppatori di modelli
- 44
- Ore GPU da pagare
- 0
Paghi gli output, non le GPU
Ogni modello è addebitato in base a ciò che produce, per richiesta, secondo, megapixel o token, al prezzo indicato sulla sua pagina. Niente da distribuire, nessun contatore GPU che gira.
fal.ai: La maggior parte delle API dei modelli è addebitata per output, ma alcuni modelli usano prezzi basati sulla GPU e i deployment personalizzati sono addebitati per ora di GPU.
Tutto il team, un solo account
Designer e marketer hanno generatori nel browser, strumenti di editing in un clic e un editor video IA, con lo stesso account e gli stessi crediti della tua API.
fal.ai: Una piattaforma di media generativi pensata per gli sviluppatori, con playground sulle pagine dei modelli.
LLM con la stessa chiave
Un'API compatibile con OpenAI per i principali modelli di chat e coding, addebitata sullo stesso saldo delle tue chiamate media. Una chiave per tutto il tuo stack di IA.
fal.ai: Posizionata come piattaforma di media generativi per sviluppatori.
Endpoint popolari
Tutti i modelli
Seedance 2.5
Da testo a video
$0.324 / esecuzione
Seedance 2.5
Da immagine a video
$0.324 / esecuzione
Veo 3.1
Da testo a video
$0.40 / esecuzione
Wan 3.0
Da immagine a video
$0.095 / esecuzione
Nano Banana Pro
Modifica immagini
$0.126 / esecuzione
GPT Image 2.5
Da testo a immagine
$0.024 / esecuzione
Seedream 5 Pro
Da testo a immagine
$0.0405 / esecuzione
Tripo P2
Da immagine a 3D
$1.20 / esecuzione
Invia. Interroga. Rilascia.
Invia JSON a qualsiasi endpoint di modello e ricevi subito un id di previsione. Interroga il risultato o passaci un webhook. Lo stesso schema per tutti gli oltre 1.000 modelli.
- REST API per ogni modello
- SDK Python e JavaScript
- Webhook per le previsioni completate
POSThttps://api.wavespeed.ai/api/v3/bytedance/seedream-v5.0-pro
curl -X POST "https://api.wavespeed.ai/api/v3/bytedance/seedream-v5.0-pro" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "prompt": "A glass teapot on a sunlit windowsill, macro product photo",
  "aspect_ratio": "4:3",
  "resolution": "2k"
}'

# → {"data": {"id": "<prediction id>", ...}}
curl "https://api.wavespeed.ai/api/v3/predictions/<prediction id>/result" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY"
import os, time, requests
headers = {"Authorization": f"Bearer {os.environ['WAVESPEED_API_KEY']}"}
task = requests.post("https://api.wavespeed.ai/api/v3/bytedance/seedream-v5.0-pro", headers=headers, json={
"prompt": "A glass teapot on a sunlit windowsill, macro product photo",
"aspect_ratio": "4:3",
"resolution": "2k"
}).json()["data"]
while True:
result = requests.get(f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result", headers=headers).json()["data"]
if result["status"] == "completed":
print(result["outputs"])
break
if result["status"] == "failed":
raise RuntimeError(result.get("error"))
time.sleep(2)const headers = { Authorization: `Bearer ${process.env.WAVESPEED_API_KEY}`, 'Content-Type': 'application/json' }
const { data: task } = await fetch('https://api.wavespeed.ai/api/v3/bytedance/seedream-v5.0-pro', {
method: 'POST',
headers,
body: JSON.stringify({
"prompt": "A glass teapot on a sunlit windowsill, macro product photo",
"aspect_ratio": "4:3",
"resolution": "2k"
}),
}).then((r) => r.json())
while (true) {
const { data: result } = await fetch(`https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`, { headers }).then((r) => r.json())
if (result.status === 'completed') { console.log(result.outputs); break }
if (result.status === 'failed') throw new Error(result.error)
await new Promise((r) => setTimeout(r, 2000))
}Creato con l'API
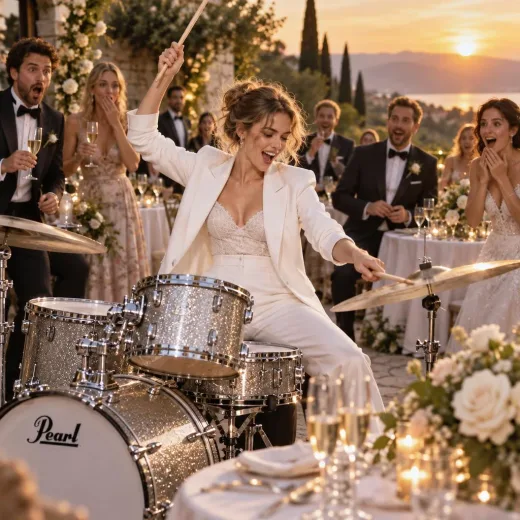
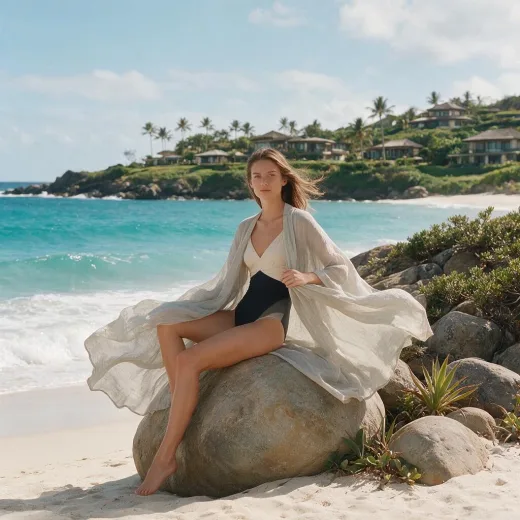
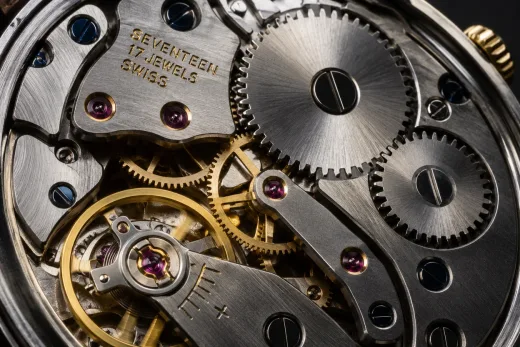
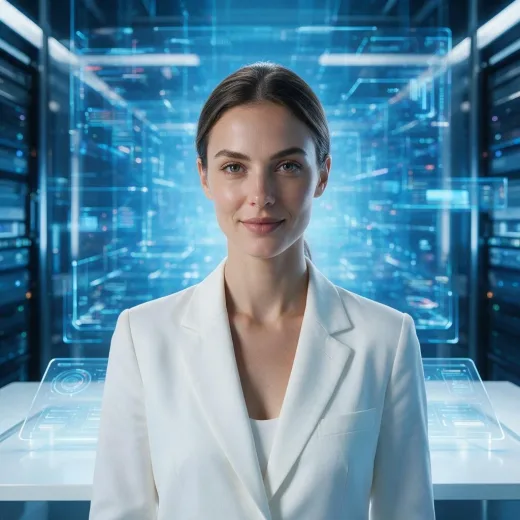
WaveSpeedAI vs fal.ai
| WaveSpeedAI | fal.ai | |
|---|---|---|
| API dei modelli | Endpoint ospitati per immagini, video, audio, 3D e LLM | Endpoint ospitati per modelli di media generativi |
| Fatturazione | Paghi per richiesta al prezzo per esecuzione indicato | Paghi l'utilizzo; la maggior parte delle API dei modelli per unità di output, alcuni modelli in base alla GPU, deployment personalizzati per ora di GPU |
| Modelli personalizzati | Focus su modelli pronti da chiamare, nessuna infrastruttura da gestire | Distribuisci e fai fine-tuning dei tuoi modelli su GPU serverless e cluster |
| Prova nel browser | Generatori, studio, strumenti di editing e un playground per ogni modello, agli stessi prezzi dell'API | Playground sulle pagine dei modelli |
| Risultati | Interroga il risultato o ricevi un webhook | Coda, polling e webhook |
FAQ
WaveSpeedAI è una buona alternativa a fal.ai?
Se chiami modelli ospitati di immagini, video, audio o 3D dalla tua app, sì. Ottieni endpoint pronti da chiamare per oltre 1.000 modelli, una chiave API, prezzi per richiesta e uno studio nel browser per il resto del tuo team.
Come chiamo un modello?
Invia il tuo input in JSON con una POST a https://api.wavespeed.ai/api/v3/<model>. Un id di previsione torna subito. Interroga l'endpoint del risultato, oppure passa un webhook e ti chiamiamo noi quando è pronto.
Ci sono SDK?
Sì. Installa wavespeed da PyPI o npm e sei a poche righe dal tuo primo output. Preferisci l'HTTP puro? Ogni modello funziona anche con semplici richieste.
Quanto costa?
Ogni modello ha un prezzo per esecuzione chiaro, mostrato sulla sua pagina e nelle schede qui sopra. Paghi per richiesta, senza canoni mensili. I nuovi account idonei ricevono $1 di crediti gratuiti, senza carta.
Quali modelli sono disponibili?
I pesi massimi: Seedance 2.5, Kling, Veo, Wan, MiniMax e Grok Imagine per i video; Nano Banana, GPT Image, Seedream e Qwen Image per le immagini; ElevenLabs e altri per l'audio; Tripo, Meshy e Rodin per il 3D; più una LLM API compatibile con OpenAI.
Il tuo primo output è a una POST di distanza.
$1 di crediti gratuiti per i nuovi account idonei. Nessuna carta richiesta.