MOSS Image API
OpenMOSS MOSS Image 是開放權重的文字轉圖片模型,適合長而詳細的提示詞,可在圖片內清晰呈現中文與英文文字,支援 1K、1.5K 或 2K 輸出、從 1:3 到 3:1 的 15 種長寬比,並有最多可載入三個自訂 LoRA 的 LoRA 版本。
本 MOSS Image API 指南介紹 WaveSpeedAI 上兩個已上線的端點:text-to-image 與 text-to-image-lora,涵蓋 1K、1.5K 和 2K 等級、長寬比、輸出格式以及 LoRA 輸入。下方的 Playground、範例、價格與 API 範例程式碼皆使用已上線的 MOSS Image 端點。
概覽
關於 MOSS Image API
MOSS Image 的功能、它在 OpenMOSS 模型陣容中的定位,以及團隊選用它的原因。
MOSS Image 是來自 OpenMOSS 的圖片生成與編輯模型,可透過 WaveSpeedAI REST API 使用。OpenMOSS MOSS Image 是開放權重的文字轉圖片模型,適合長而詳細的提示詞,可在圖片內清晰呈現中文與英文文字,支援 1K、1.5K 或 2K 輸出、從 1:3 到 3:1 的 15 種長寬比,並有最多可載入三個自訂 LoRA 的 LoRA 版本。
本 MOSS Image API 指南介紹 WaveSpeedAI 上兩個已上線的端點:text-to-image 與 text-to-image-lora,涵蓋 1K、1.5K 和 2K 等級、長寬比、輸出格式以及 LoRA 輸入。下方的 Playground、範例、價格與 API 範例程式碼皆使用已上線的 MOSS Image 端點。
WaveSpeedAI 上的 MOSS Image 系列提供 2 個 REST 端點,涵蓋 Text-To-Image 等工作流程。每個變體都有各自的定價、參數選項與範例輸出 — 請挑選符合您輸入模態與生產限制的版本,或使用同一組 API 金鑰呼叫多個變體,組合成多步驟的處理流程。
使用您呼叫其他 1,000+ 個 WaveSpeedAI AI 模型時相同的 API 金鑰、帳單帳戶與速率限制額度來執行 MOSS Image。無需另外設定供應商、無需各家 SDK、無需處理各家不同的速率限制 — 一次整合,涵蓋從文字轉圖片、文字轉影片,到音訊合成、3D 生成、放大與編輯的所有功能。
規格
MOSS Image API 功能與上線狀態
開發者在選擇 API 前會查詢的模型專屬資訊:可用性、預期輸出長度、參考素材支援,以及目前可用的替代方案。
可用性
已上線
MOSS Image 已在 WaveSpeedAI 目錄上線,以兩個端點的形式使用同一套 REST 預測流程:text-to-image 與 text-to-image-lora。
解析度等級
1K、1.5K、2K
resolution 參數決定輸出的總像素:1k 約 1 百萬像素,1.5k 約 2.4 百萬像素,2k 約 4 百萬像素。畫面形狀則由長寬比決定。
長寬比
15 種比例
從 1:3 與 3:1,經 1:1、4:5、3:2、16:9 與 9:16,到偏高的 9:21 與偏寬的 21:9,一個端點即可涵蓋海報、橫幅、手機螢幕與方形貼文。
圖片內文字
中文與英文
提示詞支援長而詳細的描述,並可在圖片內呈現中文與英文文字。
LoRA
最多 3 個
text-to-image-lora 端點接受最多三個 LoRA 的清單,每個包含路徑與 0 到 4 的強度值。
輸出格式
JPEG、PNG、WebP
預設為 JPEG;可透過 output_format 參數選擇 PNG 與 WebP。
端點
所有 MOSS Image API 端點
WaveSpeedAI 目前提供 2 個 MOSS Image 端點 — 請選擇符合您工作流程的變體。
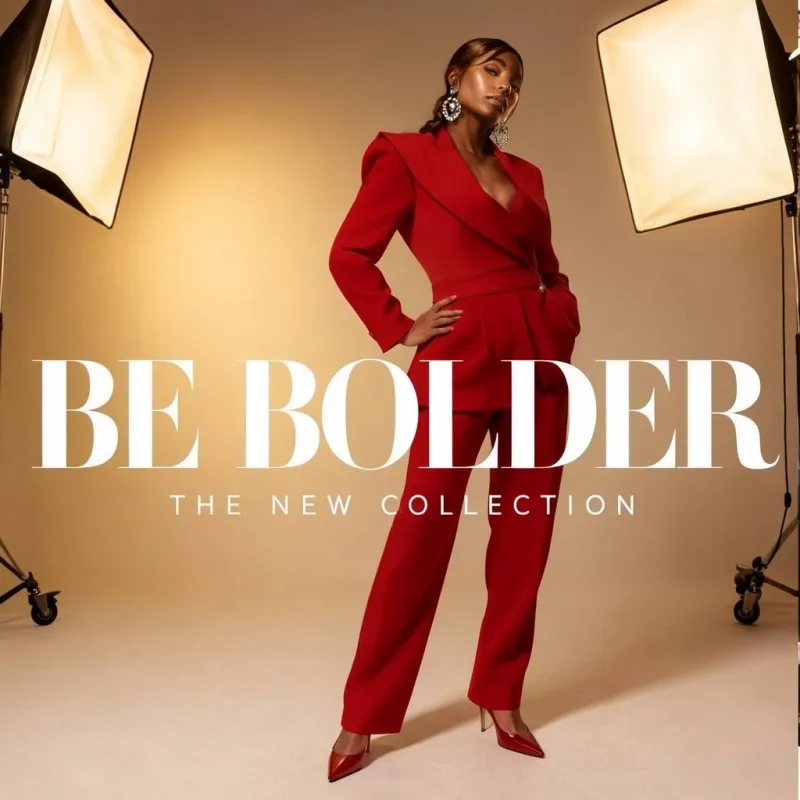
Moss Image Text To Image Lora
MOSS Image Text-to-Image LoRA generates images from long text prompts with up to 3 custom LoRAs, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
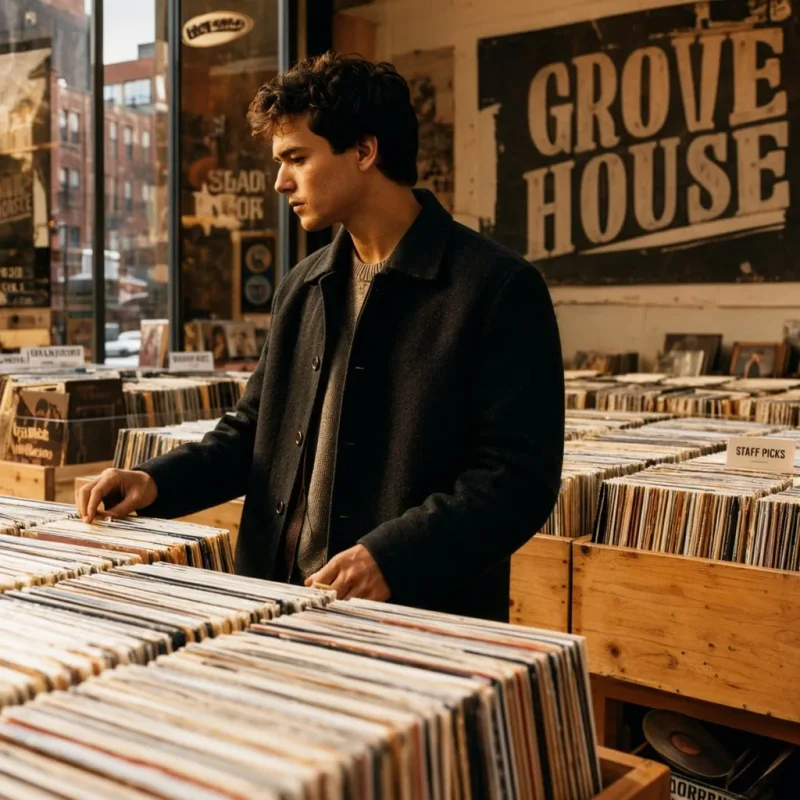
Moss Image Text To Image
MOSS Image Text-to-Image generates images from long text prompts, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
範例
看看 MOSS Image 的實際效果
由 MOSS Image API 生成的真實輸出。將滑鼠移到任一影片上即可預覽,點擊可開啟完整尺寸檢視器。
使用方式
如何使用 MOSS Image API
從註冊到完成生成,只要四個步驟。完整的 Python、Node.js 與 cURL 範例請見下方的 API 區段。
- 01
取得 API 金鑰
註冊 WaveSpeedAI 帳號,並從控制台複製您的 API 金鑰。新帳號會獲贈免費入門點數 — 足以在開始計費前執行數十次 Playground。
- 02
提交 prediction
將您的輸入以 JSON 格式 POST 到 https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image。端點會立即回傳 prediction id — 生成是非同步進行的,因此推論期間您不需要保持連線。
- 03
輪詢完成狀態
GET https://api.wavespeed.ai/api/v3/predictions/{request_id}/result。狀態為 completed 時回傳輸出;狀態為 failed、cancelled、timeout 或 deleted 時停止並回報錯誤;其他狀態則持續輪詢。
- 04
讀取輸出網址
當狀態為 "completed" 時,從 data.outputs[0] 讀取網址。該網址指向 WaveSpeedAI CDN 上您生成的媒體 — 依您呼叫的 MOSS Image 變體,可能是圖片、影片、音訊或 3D 檔案。
應用情境
您可以用 MOSS Image 打造什麼
開發者與創作者使用 MOSS Image API 的常見工作流程。
長而詳細的提示詞
wavespeed-ai/moss-image/text-to-image 專為詳細描述整個場景的提示詞而設計:主體、環境、光線、構圖與風格可寫在同一段中。
帶有中文或英文文字的海報與封面
此模型可在圖片內呈現中文與英文文字,適合海報、書籍與專輯封面、招牌樣機,以及文字本身就是畫面一部分的社群卡片。
以 LoRA 客製風格與角色
wavespeed-ai/moss-image/text-to-image-lora 可同時套用最多三個 LoRA,每個都有各自的強度,適用於品牌風格、固定角色或產品造型。
適用於印刷與大型螢幕的大尺寸圖片
2k 等級一次可生成約 4 百萬像素,1.5k 等級介於 2k 與 1k 之間,能以較低成本取得更大的圖片。
橫幅、手機螢幕與直式版面
十五種長寬比,從 1:3 到 3:1(含 9:21 與 21:9),讓同一個端點不必裁切即可產出網站橫幅、限時動態尺寸圖片與寬幅標題圖。
以 seed 重現結果
只調整提示詞或 LoRA 強度時,設定 seed 即可重現結果;維持 -1 則每次產生新的變化。
技巧
MOSS Image 提示詞技巧
讓 MOSS Image 產出更好結果的實用建議 — 整理自在實際生產流程中,圖片模型通用的有效做法。
- 01
把整個場景寫成一段話
MOSS Image 很適合長提示詞。將主體、環境、光線、構圖與風格寫成一段話,而不是一串關鍵字。
- 02
把確切的文字放在引號內
對於圖片內的文字,請將想要的文字放在引號中,並說明位置,例如頂部的標題或 logo 下方的小字。中文與英文都能呈現。
- 03
先選等級,再選比例
探索時用 1k,多數交付用 1.5k,大幅印刷用 2k,然後再選長寬比。等級決定總像素,比例決定畫面形狀。
- 04
以強度值調整 LoRA
在 text-to-image-lora 端點上,每個 LoRA 先從強度 1 開始,再小幅調整;使用多個 LoRA 時,將每個強度略微調低,避免互相干擾。
定價
MOSS Image API 定價
依輸出計費。最終費用會依您在各變體 Playground 中設定的參數(解析度、時長、輸出數量、參考素材)而調整。
| 端點 | 類型 | 起始價格 |
|---|---|---|
| wavespeed-ai/ | text-to-image | $0.025 |
| wavespeed-ai/ | text-to-image | $0.02 |
API
呼叫 MOSS Image API
請到 wavespeed.ai/accesskey 註冊取得 API 金鑰,然後透過 REST 提交 prediction。Playground 會為任何輸入組合產生可直接貼上的範例。
POSThttps://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "1:1",
    "resolution": "1k",
    "output_format": "jpeg"
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)比較
MOSS Image 與其他選擇比較
在 WaveSpeedAI 上,何時該選擇 MOSS Image 而非類似的模型。
MOSS Image vs Qwen-Image
Qwen-Image 同樣支援中文與英文文字,其系列還提供圖片編輯、多圖編輯與攝影機角度系統。MOSS Image 僅支援文字轉圖片,但有 LoRA 版本以及 1.5K 與 2K 等級。
MOSS Image vs FLUX.2 [klein]
FLUX.2 [klein] 提供支援 LoRA 的 4B 與 9B 生成及編輯模型。MOSS Image 專注於長提示詞與中英文文字渲染,有生成與 LoRA 端點,但沒有編輯端點。
MOSS Image vs Seedream 5
Seedream 5 Pro 加入互動式精準編輯、圖層分離與多圖融合。MOSS Image 不編輯既有圖片,而是依提示詞與選用的 LoRA 生成圖片。
常見問題
MOSS Image API — 常見問題
定價、授權、整合 — 關於在 WaveSpeedAI 上執行 MOSS Image 的常見問題。
MOSS Image 是什麼?
MOSS Image 是 OpenMOSS 推出的開放權重文字轉圖片模型。在 WaveSpeedAI 上,它透過 REST API 以兩個端點提供:text-to-image 與 text-to-image-lora。
MOSS Image 能編輯圖片或接受參考圖嗎?
不能。已上線的端點依文字提示詞生成圖片,LoRA 端點可另外載入最多三個 LoRA。如需編輯,請使用 Seedream 5 或 Qwen-Image 等編輯模型。
如何在 MOSS Image 中使用 LoRA?
向 text-to-image-lora 端點傳送 loras 參數:一個最多三項的清單,每項包含 LoRA 路徑(URL)與 0 到 4 之間的強度值。
MOSS Image 支援哪些解析度與長寬比?
三個解析度等級(1k、1.5k、2k,約 1、2.4 與 4 百萬像素),以及從 1:3 到 3:1 的 15 種長寬比,包括 9:16、16:9、9:21 與 21:9。
什麼是 MOSS Image API?
MOSS Image 是 OpenMOSS 的圖片生成模型,在 WaveSpeedAI 上以 REST API 提供。OpenMOSS MOSS Image 是開放權重的文字轉圖片模型,適合長而詳細的提示詞,可在圖片內清晰呈現中文與英文文字,支援 1K、1.5K 或 2K 輸出、從 1:3 到 3:1 的 15 種長寬比,並有最多可載入三個自訂 LoRA 的 LoRA 版本。您可以透過程式呼叫,也可以在上方連結的 Playground 試用。
如何呼叫 MOSS Image API?
註冊 WaveSpeedAI 帳號,從 /accesskey 複製您的 API 金鑰,然後將您的輸入以 JSON 格式 POST 到 https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image。端點會回傳 prediction id。請從約每 2 秒輪詢一次結果端點開始,長時間任務可拉長間隔,並在任何終止狀態時停止。上方提供適用於生產環境的 Python / Node.js / cURL 範例。
MOSS Image API 的費用是多少?
MOSS Image 每次執行 $0.02 起。實際費用會依您設定的參數(解析度、時長、輸出數量、參考素材)而調整。Playground 中「生成」按鈕旁的即時費用預覽會顯示您目前輸入的確切價格。
有哪些 MOSS Image 變體可用?
WaveSpeedAI 提供 2 個已上線的 MOSS Image 端點:wavespeed-ai/moss-image/text-to-image-lora, wavespeed-ai/moss-image/text-to-image。每個變體都有各自的 Playground 頁面與定價。
MOSS Image 的輸出可以商用嗎?
商業使用權依 OpenMOSS 的模型授權而定。多數 OpenMOSS 模型允許商用輸出;請參閱各模型 Playground 頁面中的授權摘要,以及 WaveSpeedAI 的服務條款了解平台層級的條件。
為什麼要在 WaveSpeedAI 上使用 MOSS Image,而不是直接使用?
一組 API 金鑰、一個帳單帳戶,即可使用 MOSS Image 以及來自其他供應商的 1,000+ 個 AI 模型。無需設定各家 SDK、無需處理各自獨立的速率限制、無需為每個供應商重寫整合程式碼。價格通常與 OpenMOSS 的直接 API 相當或更低。
提供者
關於 OpenMOSS
MOSS Image 背後的團隊,以及 OpenMOSS 在 WaveSpeedAI 上的完整模型陣容。
OpenMOSS 是 MOSS 系列模型背後的開源團隊。MOSS Image 以 Apache-2.0 授權釋出開放權重,可依長提示詞生成圖片,支援中英文文字渲染、最高 2K 輸出與 LoRA。WaveSpeedAI 透過 REST API 提供此模型,包含 text-to-image 與 text-to-image-lora 兩個端點。
在 WaveSpeedAI 上開始使用 MOSS Image 打造應用
註冊即贈免費入門點數。一組 API 金鑰,涵蓋來自 OpenMOSS 與所有其他供應商的 1,000+ 個 AI 模型。