MOSS Image API
OpenMOSS MOSS Image——开放权重的文生图模型,适合长而详细的提示词,可在图像内清晰渲染中文和英文文字,支持 1K、1.5K 或 2K 输出、从 1:3 到 3:1 的 15 种画幅比例,并有最多可加载三个自定义 LoRA 的 LoRA 变体。
本 MOSS Image API 指南介绍 WaveSpeedAI 上两个已上线的端点:text-to-image 和 text-to-image-lora,涵盖 1K、1.5K 和 2K 档位、画幅比例、输出格式以及 LoRA 输入。下方的 Playground、示例、价格和 API 代码示例均使用已上线的 MOSS Image 端点。
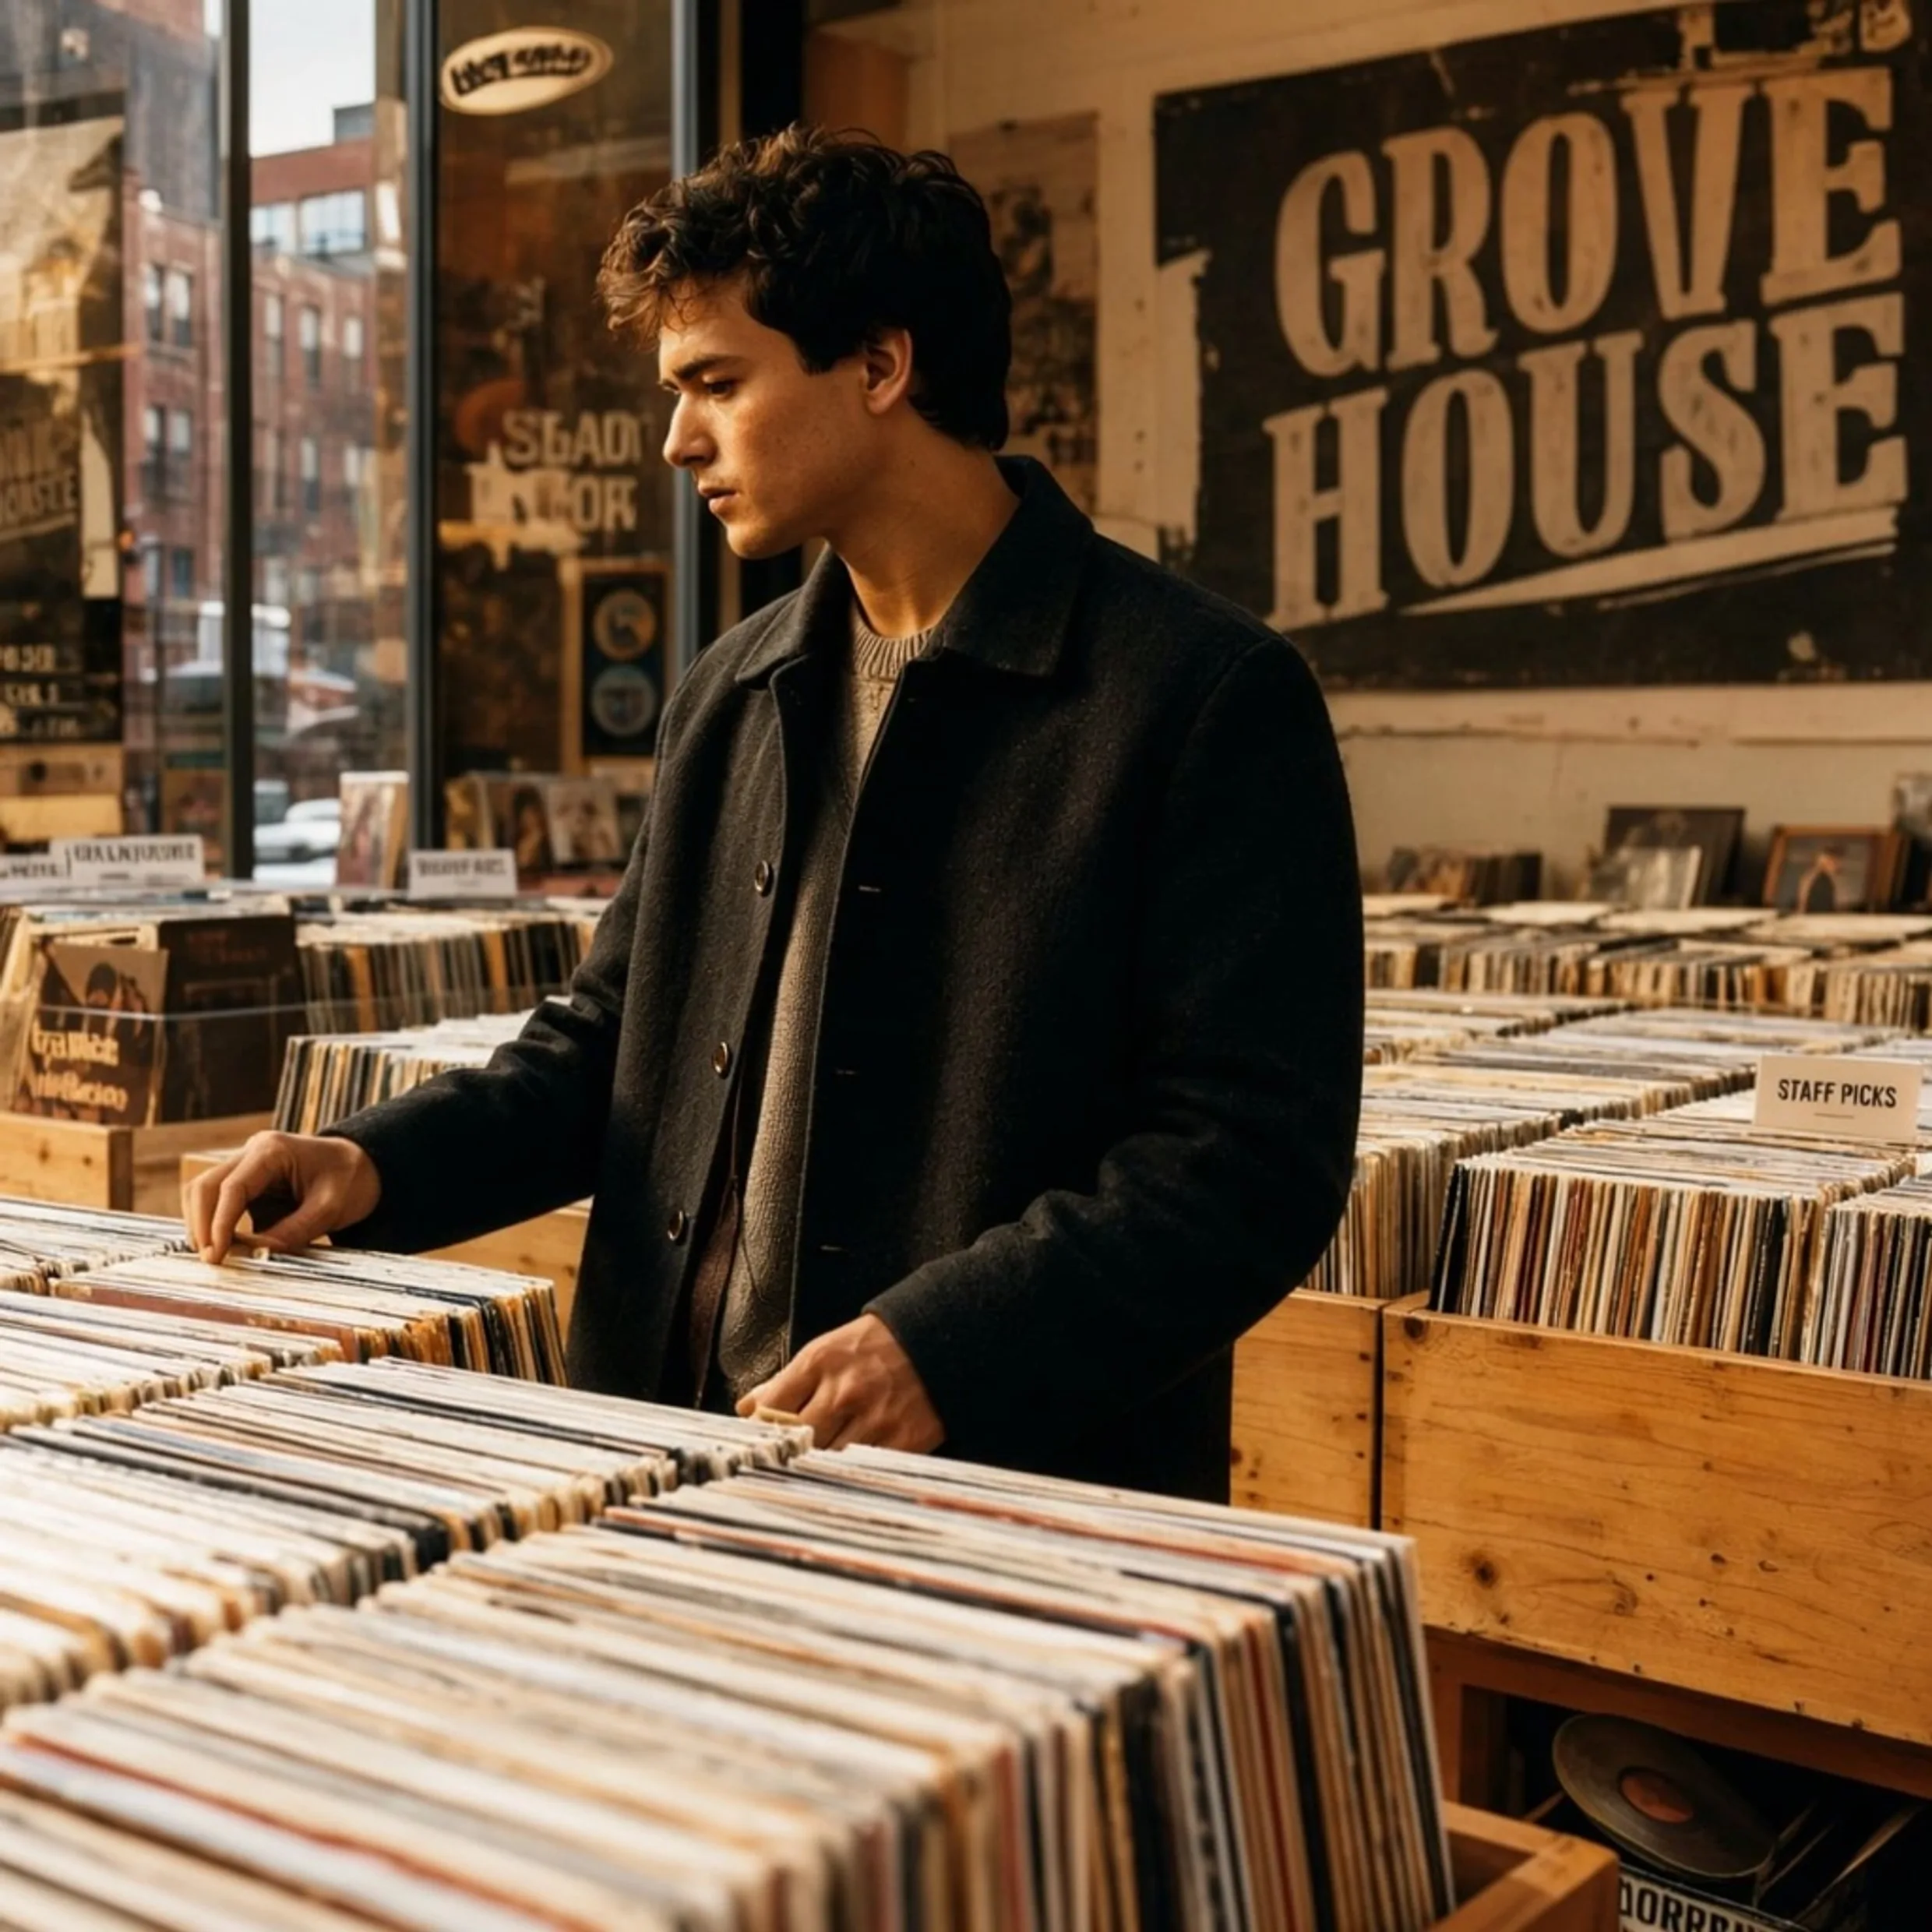
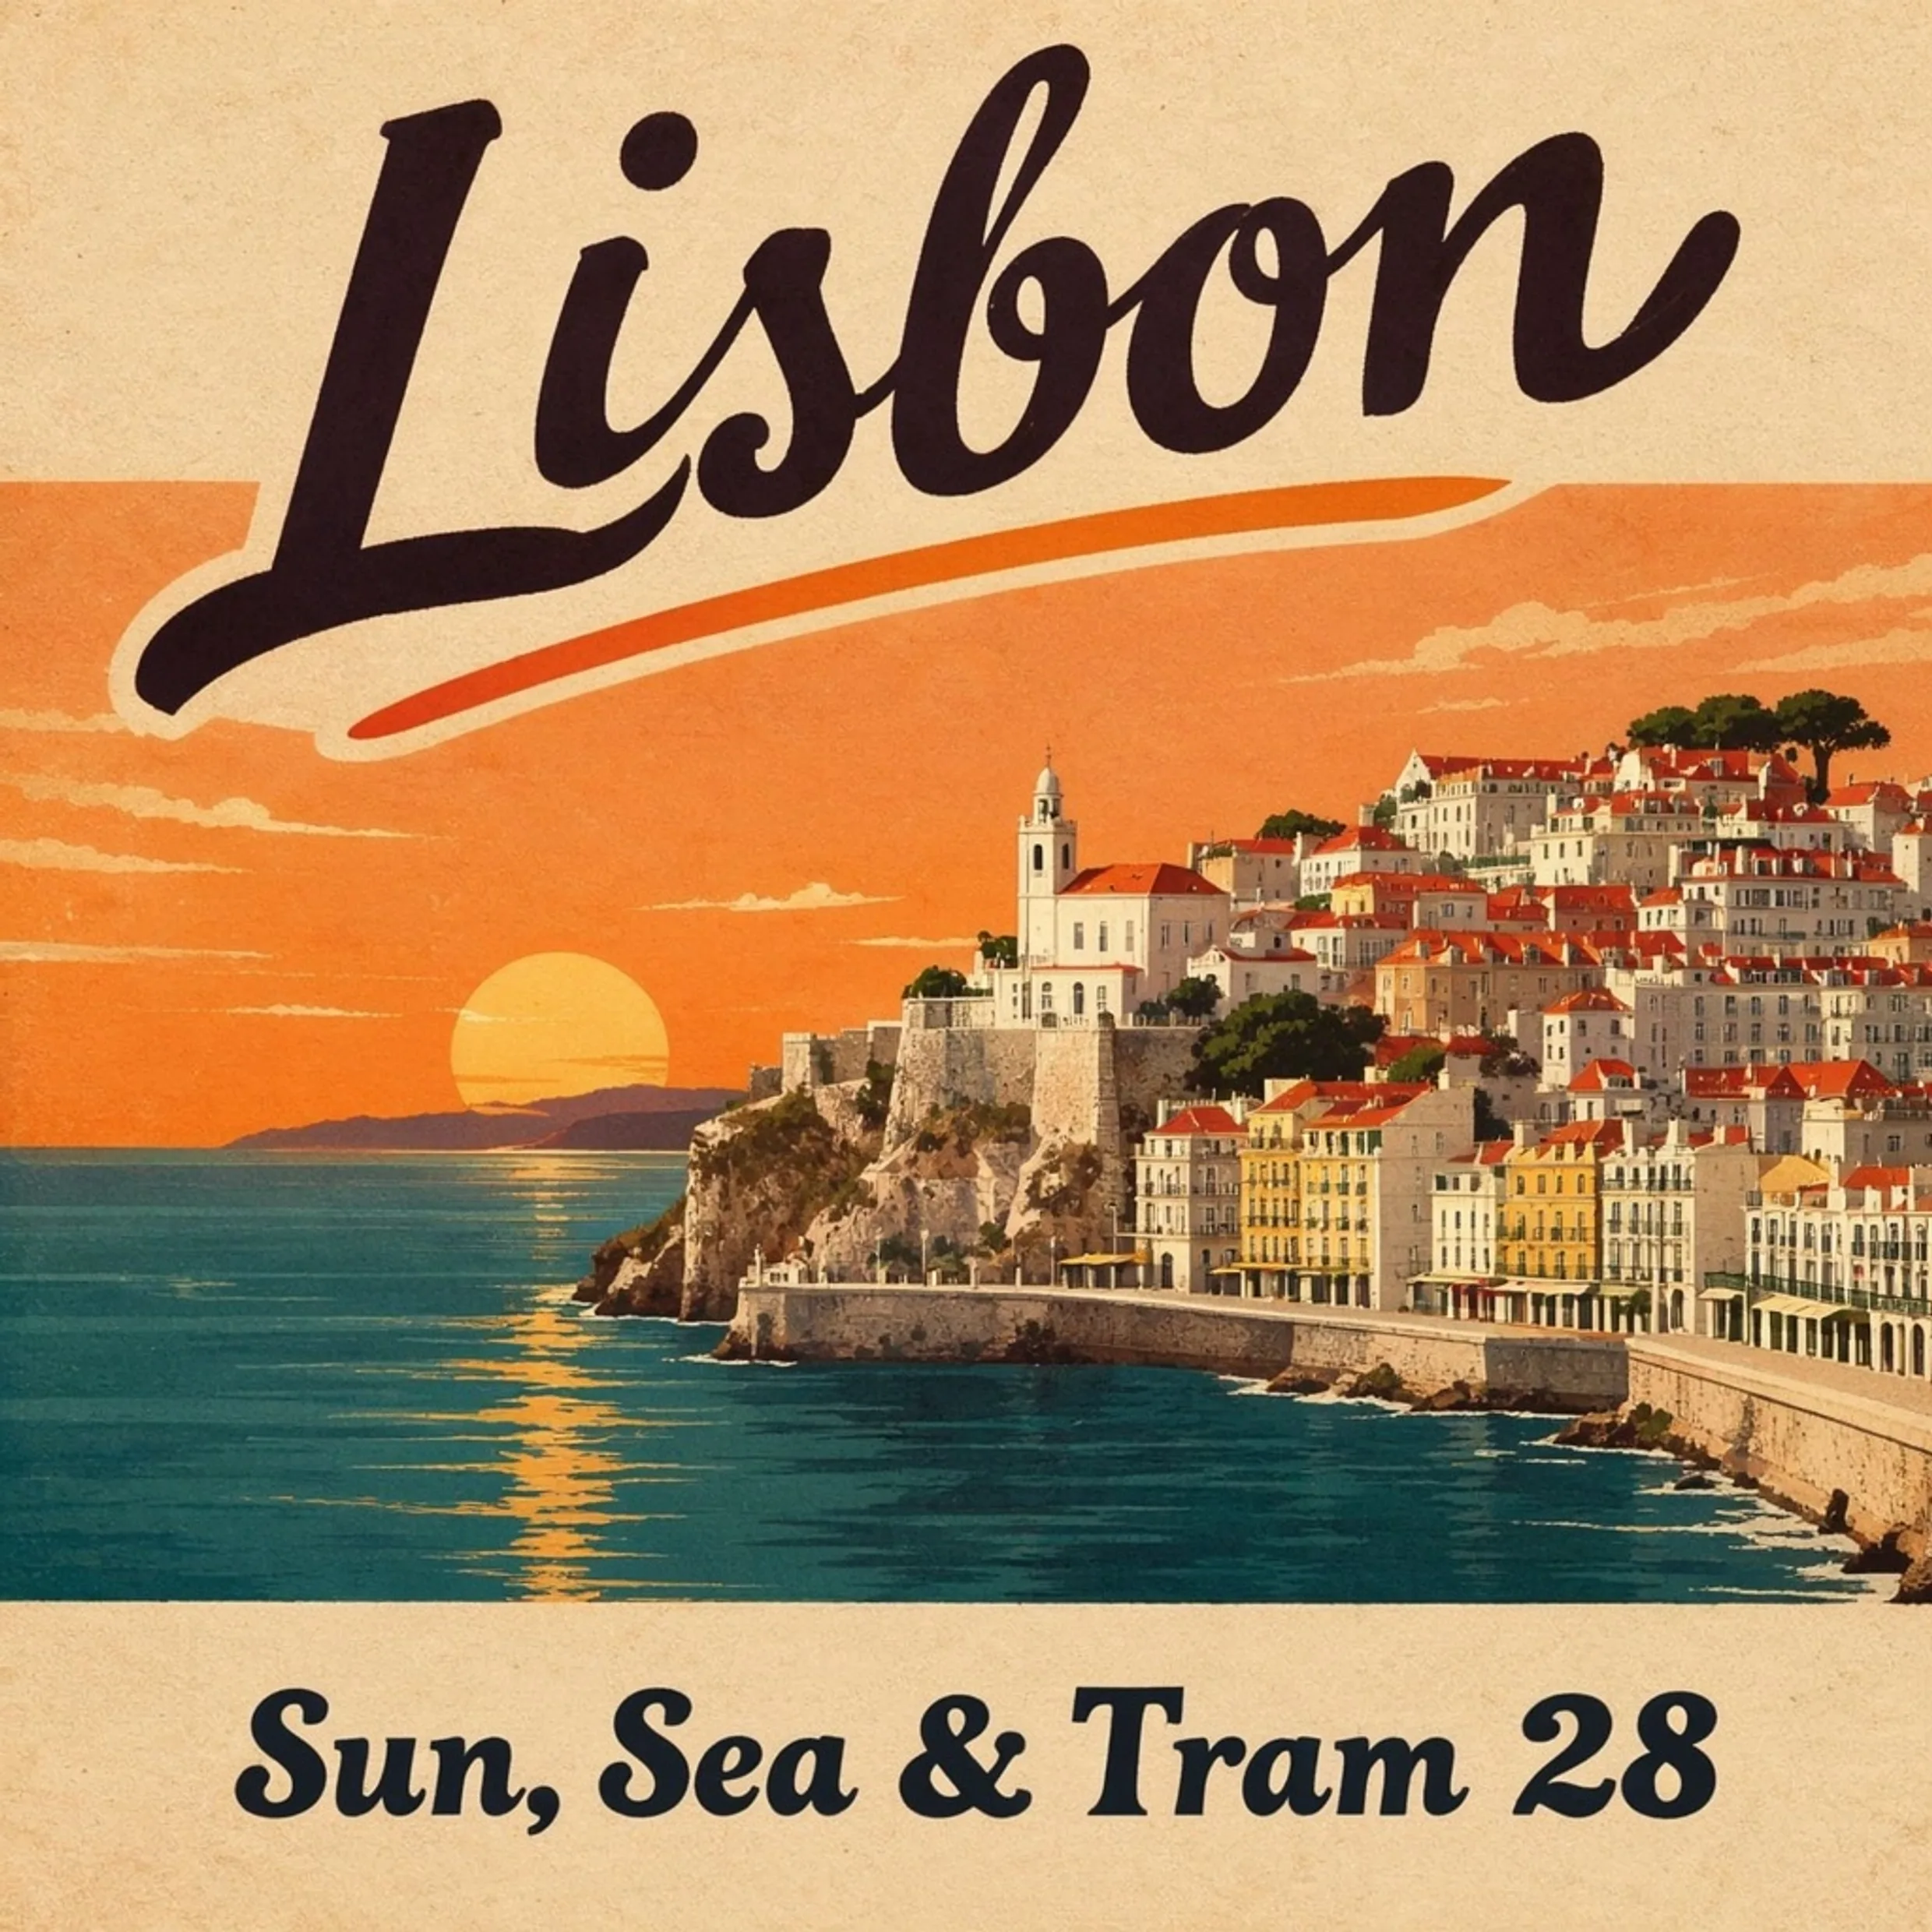
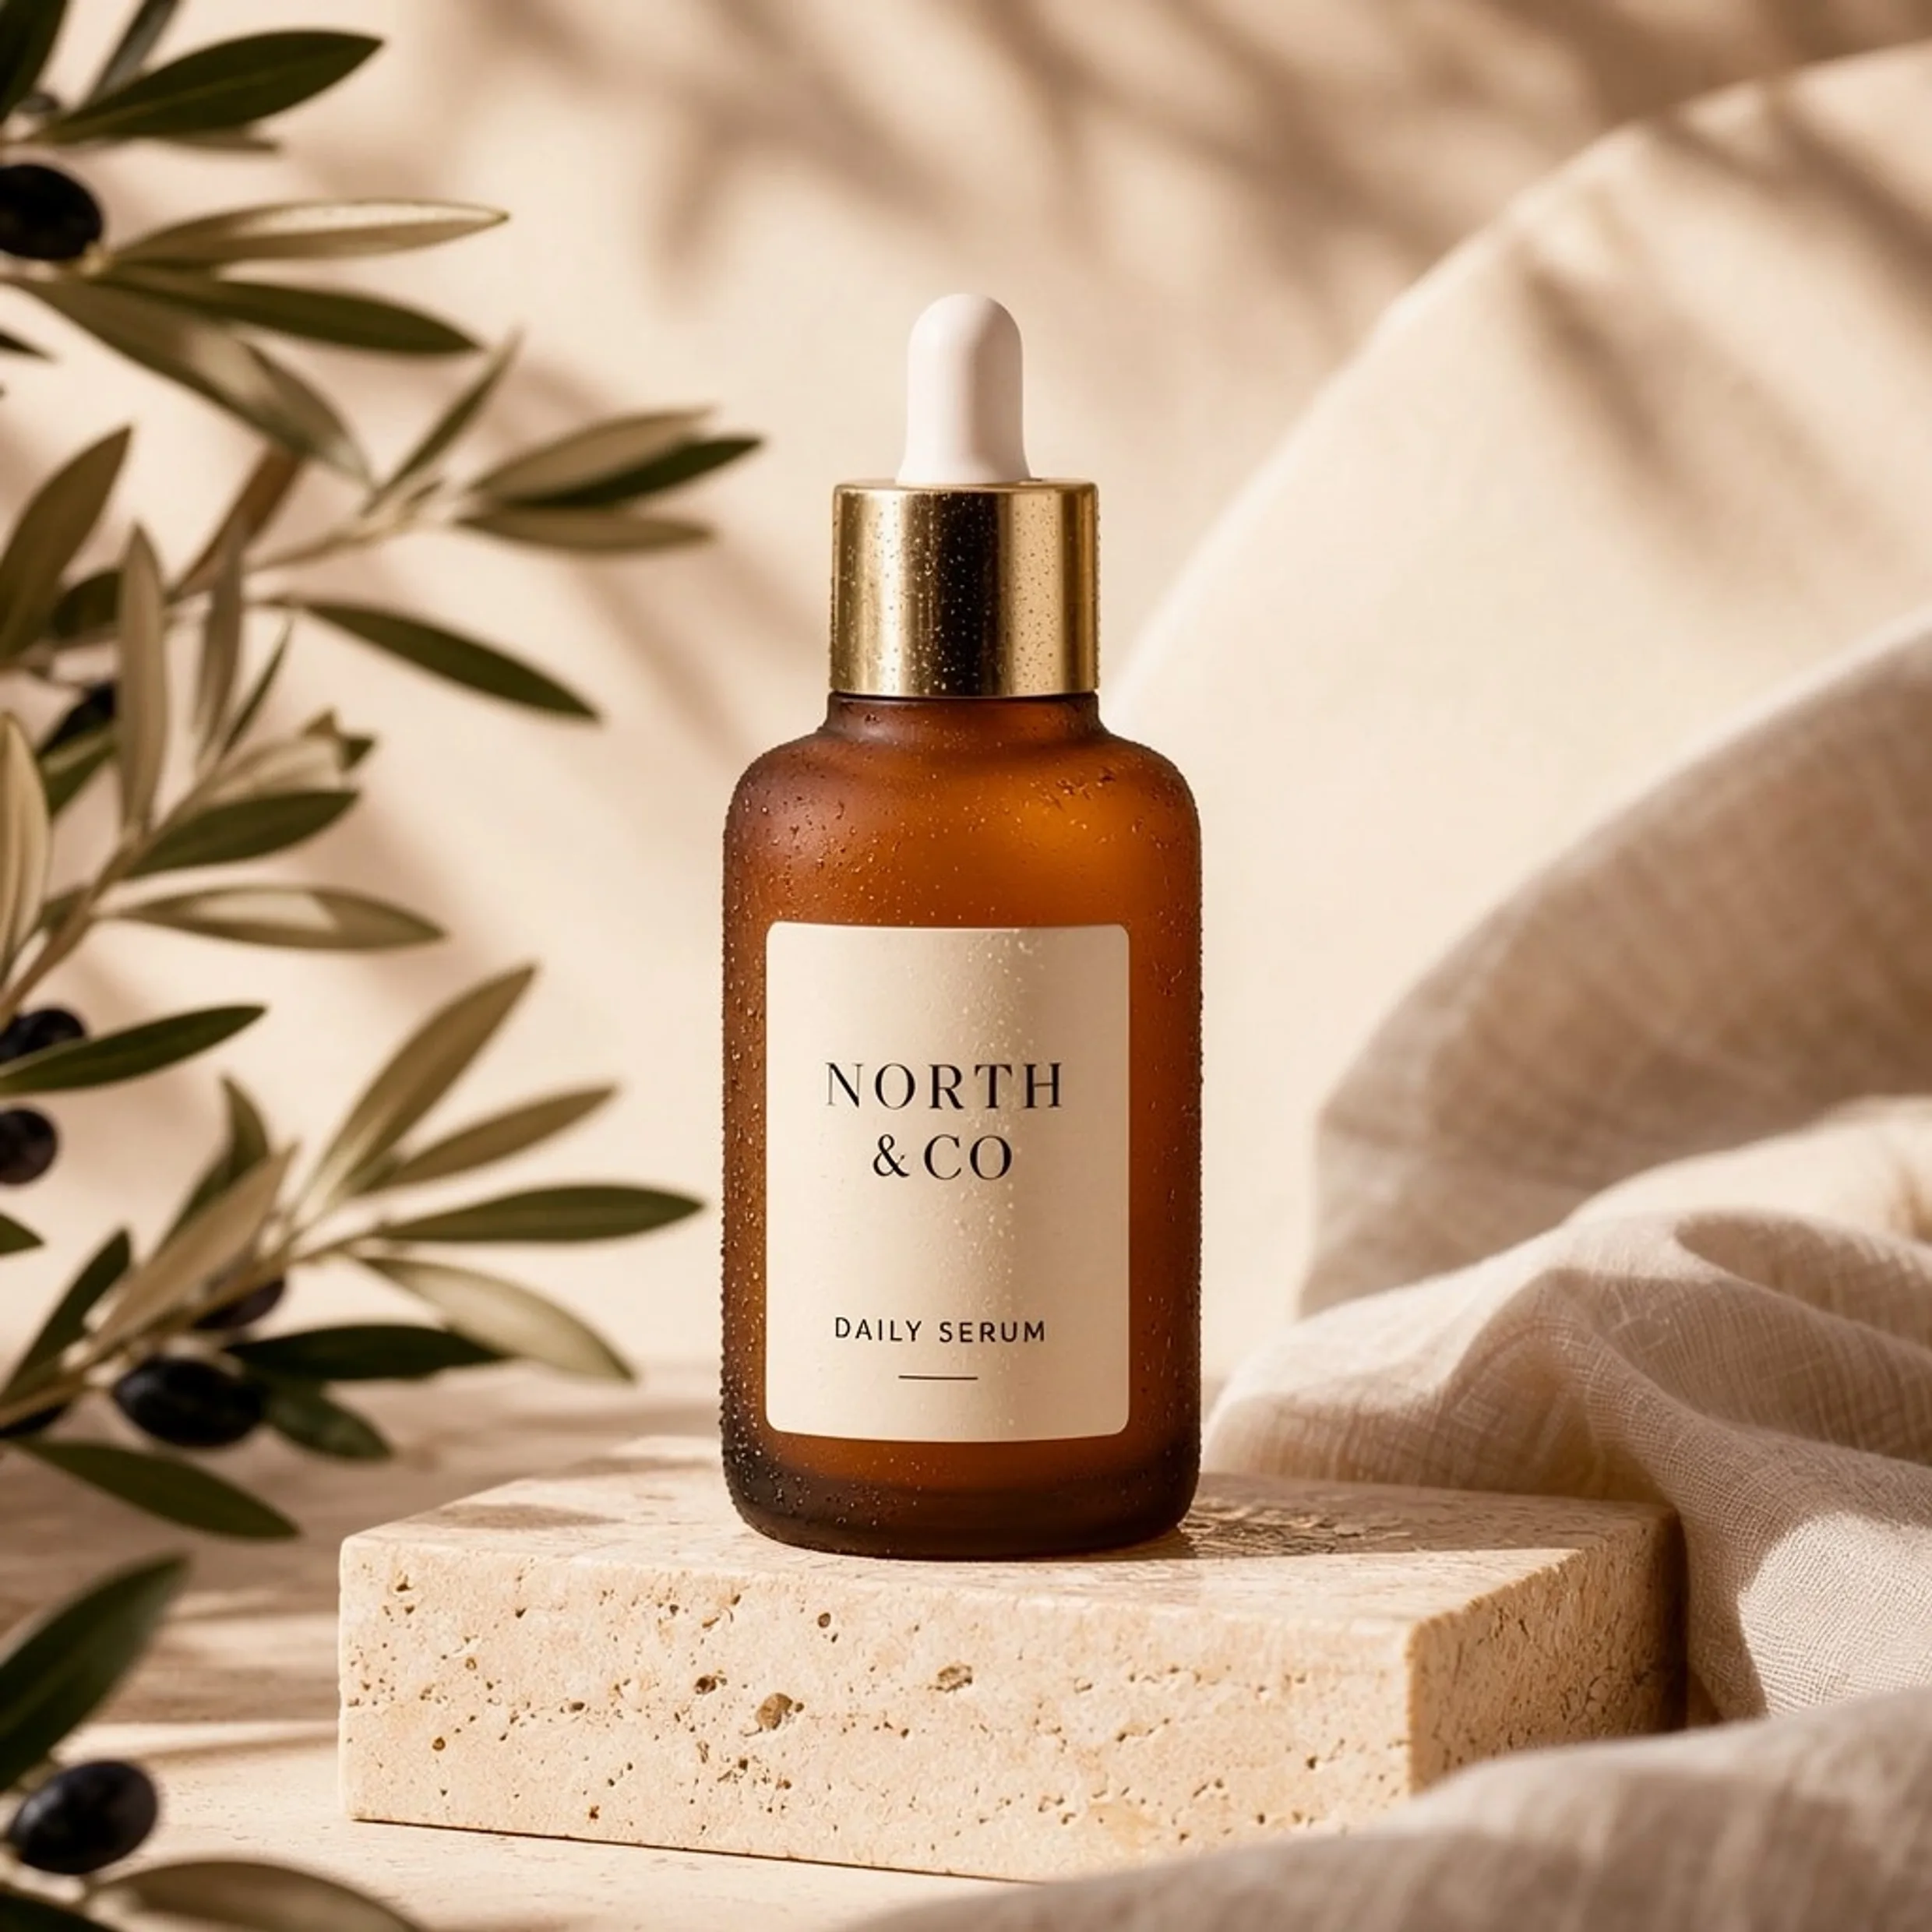
概览
关于 MOSS Image API
MOSS Image 能做什么、它在 OpenMOSS 模型阵容中的定位,以及团队选择它的原因。
MOSS Image 是 OpenMOSS 推出的图像生成与编辑模型,可通过 WaveSpeedAI REST API 使用。OpenMOSS MOSS Image——开放权重的文生图模型,适合长而详细的提示词,可在图像内清晰渲染中文和英文文字,支持 1K、1.5K 或 2K 输出、从 1:3 到 3:1 的 15 种画幅比例,并有最多可加载三个自定义 LoRA 的 LoRA 变体。
本 MOSS Image API 指南介绍 WaveSpeedAI 上两个已上线的端点:text-to-image 和 text-to-image-lora,涵盖 1K、1.5K 和 2K 档位、画幅比例、输出格式以及 LoRA 输入。下方的 Playground、示例、价格和 API 代码示例均使用已上线的 MOSS Image 端点。
WaveSpeedAI 上的 MOSS Image 系列提供 2 个 REST 端点,涵盖 Text-To-Image 个工作流。每个变体都有各自的定价、参数选项和示例输出——请选择与你的输入模态和生产约束相匹配的那一个,或使用同一个 API 密钥调用多个变体,组合成多步骤流水线。
使用与 WaveSpeedAI 上其他 1,000 多个 AI 模型相同的 API 密钥、账单账户和速率限制来运行 MOSS Image。无需单独对接供应商,无需各家 SDK,也无需应对各家不同的速率限制——一次集成即可覆盖从文生图、文生视频到音频合成、3D 生成、放大和编辑的全部能力。
规格
MOSS Image API 的能力与发布状态
开发者在选择 API 之前会搜索的模型细节:可用性、预期输出时长、参考素材支持情况,以及当前可用的在线替代方案。
可用性
已上线
MOSS Image 已在 WaveSpeedAI 目录中上线,以两个端点的形式使用同一套 REST 预测流程:text-to-image 和 text-to-image-lora。
分辨率档位
1K、1.5K、2K
resolution 参数决定输出的总像素:1k 约 1 百万像素,1.5k 约 2.4 百万像素,2k 约 4 百万像素。画幅比例再决定画面形状。
画幅比例
15 种比例
从 1:3 和 3:1,经 1:1、4:5、3:2、16:9 和 9:16,到偏高的 9:21 和偏宽的 21:9,一个端点即可覆盖海报、横幅、手机屏幕和方形帖子。
图像内文字
中文和英文
提示词支持长而详细的描述,并可在图像内渲染中文和英文文字。
LoRA
最多 3 个
text-to-image-lora 端点接受最多三个 LoRA 的列表,每个包含路径和 0 到 4 的强度值。
输出格式
JPEG、PNG、WebP
默认为 JPEG;可通过 output_format 参数选择 PNG 和 WebP。
端点
全部 MOSS Image API 端点
WaveSpeedAI 现已提供 2 个 MOSS Image 端点——请选择适合你工作流的变体。
Moss Image Text To Image Lora
MOSS Image Text-to-Image LoRA generates images from long text prompts with up to 3 custom LoRAs, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Moss Image Text To Image
MOSS Image Text-to-Image generates images from long text prompts, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
示例
看看 MOSS Image 的实际效果
由 MOSS Image API 生成的真实输出。悬停在任意视频上即可预览,点击可打开全尺寸查看器。
使用方法
如何使用 MOSS Image API
从注册到完成一次生成,只需四步。完整的 Python、Node.js 和 cURL 示例见下方的 API 部分。
- 01
获取 API 密钥
注册 WaveSpeedAI 账号,并从控制台复制你的 API 密钥。新账号附带免费体验额度——足够在开始计费前把 Playground 运行几十次。
- 02
提交预测
把你的输入以 JSON 形式 POST 到 https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image。端点会立即返回预测 ID——生成是异步的,因此推理期间你无需保持连接。
- 03
轮询完成状态
GET https://api.wavespeed.ai/api/v3/predictions/{request_id}/result。状态为 completed 时返回输出;状态为 failed、cancelled、timeout 或 deleted 时以错误终止;其他任何状态都继续轮询。
- 04
读取输出 URL
状态变为 "completed" 后,从 data.outputs[0] 读取 URL。该 URL 指向 WaveSpeedAI CDN 上你生成的媒体——具体是图片、视频、音频还是 3D 文件,取决于你调用的 MOSS Image 变体。
应用场景
用 MOSS Image 可以构建什么
开发者和创作者使用 MOSS Image API 的常见工作流。
长而详细的提示词
wavespeed-ai/moss-image/text-to-image 专为详细描述整个场景的提示词而设计:主体、环境、光线、构图和风格可写在同一段中。
带中文或英文文字的海报和封面
该模型可在图像内渲染中文和英文文字,适合海报、图书和专辑封面、标牌样机,以及文字本身就是画面一部分的社交卡片。
用 LoRA 定制风格和角色
wavespeed-ai/moss-image/text-to-image-lora 可同时应用最多三个 LoRA,每个都有各自的强度,用于品牌风格、固定角色或产品造型。
用于印刷和大屏的大尺寸图像
2k 档位一次可生成约 4 百万像素,1.5k 档位介于 2k 与 1k 之间,以更低成本获得更大的图像。
横幅、手机屏幕和竖版布局
十五种画幅比例,从 1:3 到 3:1(含 9:21 和 21:9),让同一个端点无需裁剪即可生成网站横幅、竖屏故事图和宽幅头图。
用 seed 实现可重复的结果
只修改提示词或 LoRA 强度时,设置 seed 即可重现结果;保持 -1 则每次生成新的变化。
技巧
MOSS Image 提示词技巧
让 MOSS Image 输出更好结果的实用建议——总结自生产流水线中各类图像模型都适用的做法。
- 01
把整个场景写成一段话
MOSS Image 很适合长提示词。把主体、环境、光线、构图和风格写成一段话,而不是一串关键词。
- 02
把确切的文字放在引号里
对于图像内的文字,请把想要的文字放在引号中,并说明位置,比如顶部的标题或 logo 下方的小字。中文和英文都能渲染。
- 03
先选档位,再选比例
探索时用 1k,大多数交付用 1.5k,大幅印刷用 2k,然后再选画幅比例。档位决定总像素,比例决定画面形状。
- 04
用强度值调节 LoRA
在 text-to-image-lora 端点上,每个 LoRA 先从强度 1 开始,再小幅调整;使用多个 LoRA 时,把每个强度略微调低,避免相互干扰。
定价
MOSS Image API 定价
按输出计费。最终费用会随你在各变体 Playground 中设置的参数(分辨率、时长、输出数量、参考素材)而变化。
| 端点 | 类型 | 起步价 |
|---|---|---|
| wavespeed-ai/ | text-to-image | $0.025 |
| wavespeed-ai/ | text-to-image | $0.02 |
API
调用 MOSS Image API
在 wavespeed.ai/accesskey 注册并获取 API 密钥,然后通过 REST 提交预测。Playground 可以为任意输入组合生成可直接粘贴的示例代码。
POSThttps://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "1:1",
    "resolution": "1k",
    "output_format": "jpeg"
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)对比
MOSS Image 与其他方案对比
在 WaveSpeedAI 上,何时应选择 MOSS Image 而不是同类模型。
MOSS Image 对比 Qwen-Image
Qwen-Image 同样支持中文和英文文字,其系列还提供图像编辑、多图编辑和镜头角度系统。MOSS Image 仅支持文生图,但有 LoRA 变体以及 1.5K 和 2K 档位。
MOSS Image 对比 FLUX.2 [klein]
FLUX.2 [klein] 提供支持 LoRA 的 4B 和 9B 生成与编辑模型。MOSS Image 专注于长提示词以及中英文文字渲染,有生成和 LoRA 端点,但没有编辑端点。
MOSS Image 对比 Seedream 5
Seedream 5 Pro 增加了交互式精确编辑、图层分离和多图融合。MOSS Image 不编辑已有图像,而是根据提示词和可选的 LoRA 生成图像。
常见问题
MOSS Image API — 常见问题
定价、许可、集成——关于在 WaveSpeedAI 上运行 MOSS Image 的常见问题。
MOSS Image 是什么?
MOSS Image 是 OpenMOSS 推出的开放权重文生图模型。在 WaveSpeedAI 上,它通过 REST API 以两个端点提供:text-to-image 和 text-to-image-lora。
MOSS Image 能编辑图像或接受参考图吗?
不能。已上线的端点根据文本提示词生成图像,LoRA 端点可额外加载最多三个 LoRA。如需编辑,请使用 Seedream 5 或 Qwen-Image 等编辑模型。
如何在 MOSS Image 中使用 LoRA?
向 text-to-image-lora 端点发送 loras 参数:一个最多三项的列表,每项包含 LoRA 路径(URL)和 0 到 4 之间的强度值。
MOSS Image 支持哪些分辨率和画幅比例?
三个分辨率档位(1k、1.5k、2k,约 1、2.4 和 4 百万像素)以及从 1:3 到 3:1 的 15 种画幅比例,包括 9:16、16:9、9:21 和 21:9。
MOSS Image API 是什么?
MOSS Image 是 OpenMOSS 的图像生成模型,在 WaveSpeedAI 上以 REST API 形式提供。OpenMOSS MOSS Image——开放权重的文生图模型,适合长而详细的提示词,可在图像内清晰渲染中文和英文文字,支持 1K、1.5K 或 2K 输出、从 1:3 到 3:1 的 15 种画幅比例,并有最多可加载三个自定义 LoRA 的 LoRA 变体。你可以通过编程方式调用它,也可以在上方链接的 Playground 中试用。
如何调用 MOSS Image API?
注册 WaveSpeedAI 账号,从 /accesskey 复制你的 API 密钥,然后把输入以 JSON 形式 POST 到 https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image。端点会返回预测 ID。从大约每 2 秒一次开始轮询结果端点,长耗时任务可适当拉长间隔,并在任何终止状态时停止。上方有面向生产环境的 Python / Node.js / cURL 示例。
MOSS Image API 的费用是多少?
MOSS Image 每次调用 $0.02 起。实际费用会随你设置的参数(分辨率、时长、输出数量、参考素材)而变化。Playground 中“生成”按钮旁的实时费用预览会显示你当前输入对应的准确价格。
有哪些 MOSS Image 变体可用?
WaveSpeedAI 托管了 2 个已上线的 MOSS Image 端点:wavespeed-ai/moss-image/text-to-image-lora, wavespeed-ai/moss-image/text-to-image。每个变体都有自己的 Playground 页面和定价。
MOSS Image 的输出可以商用吗?
商用权利遵循 OpenMOSS 的模型许可。大多数 OpenMOSS 模型允许商用输出;具体许可摘要请查看各模型的 Playground 页面,平台层面的条件请参阅 WaveSpeedAI 的服务条款。
为什么要在 WaveSpeedAI 上使用 MOSS Image,而不是直接对接?
一个 API 密钥、一个账单账户,即可使用 MOSS Image 以及来自其他提供方的 1,000 多个 AI 模型。无需逐家配置 SDK,无需应对各自独立的速率限制,也无需为每家重写集成代码。价格通常与 OpenMOSS 直接提供的 API 持平或更低。
提供方
关于 OpenMOSS
MOSS Image 及 WaveSpeedAI 上 OpenMOSS 更多模型背后的团队。
OpenMOSS 是 MOSS 系列模型背后的开源团队。MOSS Image 以 Apache-2.0 许可证开放权重发布,可根据长提示词生成图像,支持中英文文字渲染、最高 2K 输出和 LoRA。WaveSpeedAI 通过 REST API 提供该模型,包含 text-to-image 和 text-to-image-lora 两个端点。
在 WaveSpeedAI 上用 MOSS Image 开始构建
注册即送免费体验额度。一个 API 密钥,即可使用来自 OpenMOSS 及其他所有提供方的 1,000 多个 AI 模型。