MOSS Image API
OpenMOSS MOSS Image — un modello text-to-image a pesi aperti per prompt lunghi e dettagliati, con testo cinese e inglese nitido all'interno dell'immagine, output 1K, 1.5K o 2K, 15 proporzioni da 1:3 a 3:1 e una variante LoRA che accetta fino a tre LoRA personalizzati.
Questa guida all'API MOSS Image copre i due endpoint attivi su WaveSpeedAI, text-to-image e text-to-image-lora, con i livelli 1K, 1.5K e 2K, le proporzioni, i formati di output e gli input LoRA. Playground, esempi, prezzi ed esempi di codice qui sotto usano tutti gli endpoint MOSS Image attivi.
Panoramica
Informazioni su MOSS Image API
Cosa fa MOSS Image, come si inserisce nella gamma di modelli di OpenMOSS e perché i team lo scelgono.
MOSS Image è un modello di generazione e modifica di immagini di OpenMOSS, disponibile tramite l'API REST di WaveSpeedAI. OpenMOSS MOSS Image — un modello text-to-image a pesi aperti per prompt lunghi e dettagliati, con testo cinese e inglese nitido all'interno dell'immagine, output 1K, 1.5K o 2K, 15 proporzioni da 1:3 a 3:1 e una variante LoRA che accetta fino a tre LoRA personalizzati.
Questa guida all'API MOSS Image copre i due endpoint attivi su WaveSpeedAI, text-to-image e text-to-image-lora, con i livelli 1K, 1.5K e 2K, le proporzioni, i formati di output e gli input LoRA. Playground, esempi, prezzi ed esempi di codice qui sotto usano tutti gli endpoint MOSS Image attivi.
La famiglia MOSS Image su WaveSpeedAI offre 2 endpoint REST che coprono il flusso di lavoro Text-To-Image. Ogni variante ha il suo prezzo, i suoi parametri e i suoi esempi di output: scegli quella più adatta alla tua modalità di input e ai tuoi vincoli di produzione, oppure richiamane diverse con la stessa chiave API per comporre pipeline in più passaggi.
Usa MOSS Image con la stessa chiave API, lo stesso account di fatturazione e gli stessi limiti di frequenza che usi per gli altri oltre 1.000 modelli AI di WaveSpeedAI. Nessuna configurazione separata per fornitore, nessun SDK per provider, nessun limite di frequenza per fornitore: un'unica integrazione copre tutto, dal text-to-image e text-to-video alla sintesi audio, alla generazione 3D, all'upscaling e all'editing.
Specifiche
Funzionalità e stato di rilascio di MOSS Image API
I dettagli specifici del modello che gli sviluppatori cercano prima di scegliere un'API: disponibilità, durata prevista dell'output, supporto dei riferimenti e l'alternativa attiva al momento.
Disponibilità
Attivo ora
MOSS Image è attivo nel catalogo WaveSpeedAI come due endpoint sullo stesso flusso di predizione REST: text-to-image e text-to-image-lora.
Livelli di risoluzione
1K, 1.5K, 2K
Il parametro resolution sceglie la dimensione totale dell'output: 1k è circa 1 megapixel, 1.5k circa 2,4 megapixel e 2k circa 4 megapixel. La proporzione ne definisce poi la forma.
Proporzioni
15 proporzioni
Da 1:3 e 3:1 passando per 1:1, 4:5, 3:2, 16:9 e 9:16 fino al formato alto 9:21 e a quello largo 21:9, così un solo endpoint copre poster, banner, schermi del telefono e post quadrati.
Testo nelle immagini
Cinese e inglese
Il prompt supporta descrizioni lunghe e dettagliate e renderizza testo cinese e inglese all'interno dell'immagine.
LoRA
Fino a 3
L'endpoint text-to-image-lora accetta un elenco di al massimo tre LoRA, ciascuno con un path e una scala da 0 a 4.
Formati di output
JPEG, PNG, WebP
JPEG è il formato predefinito; PNG e WebP sono disponibili tramite il parametro output_format.
Endpoint
Tutti gli endpoint API MOSS Image
2 endpoint MOSS Image disponibili ora su WaveSpeedAI: scegli la variante più adatta al tuo flusso di lavoro.
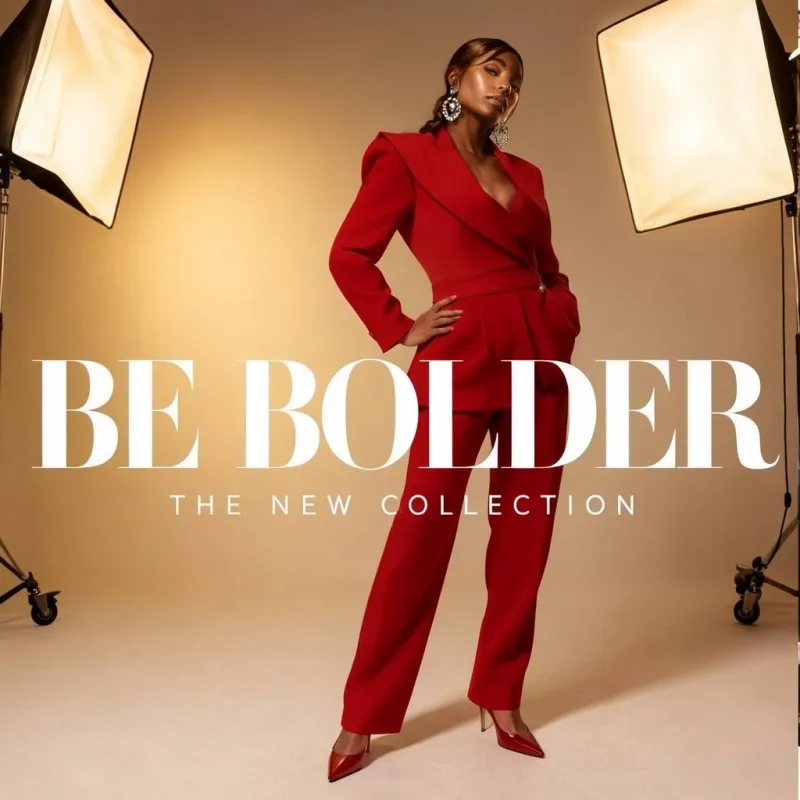
Moss Image Text To Image Lora
MOSS Image Text-to-Image LoRA generates images from long text prompts with up to 3 custom LoRAs, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
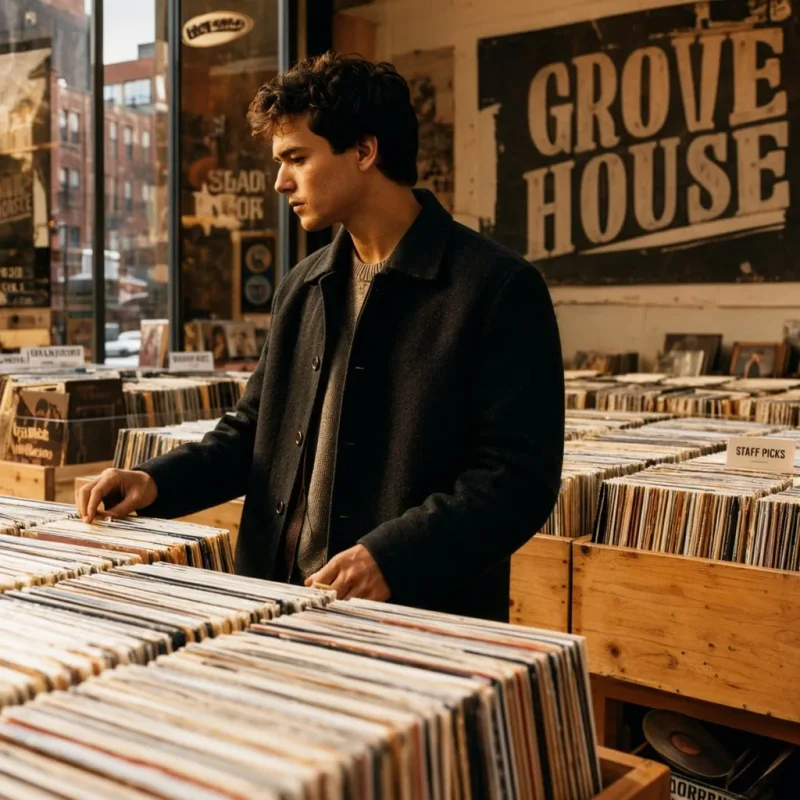
Moss Image Text To Image
MOSS Image Text-to-Image generates images from long text prompts, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Esempi
MOSS Image in azione
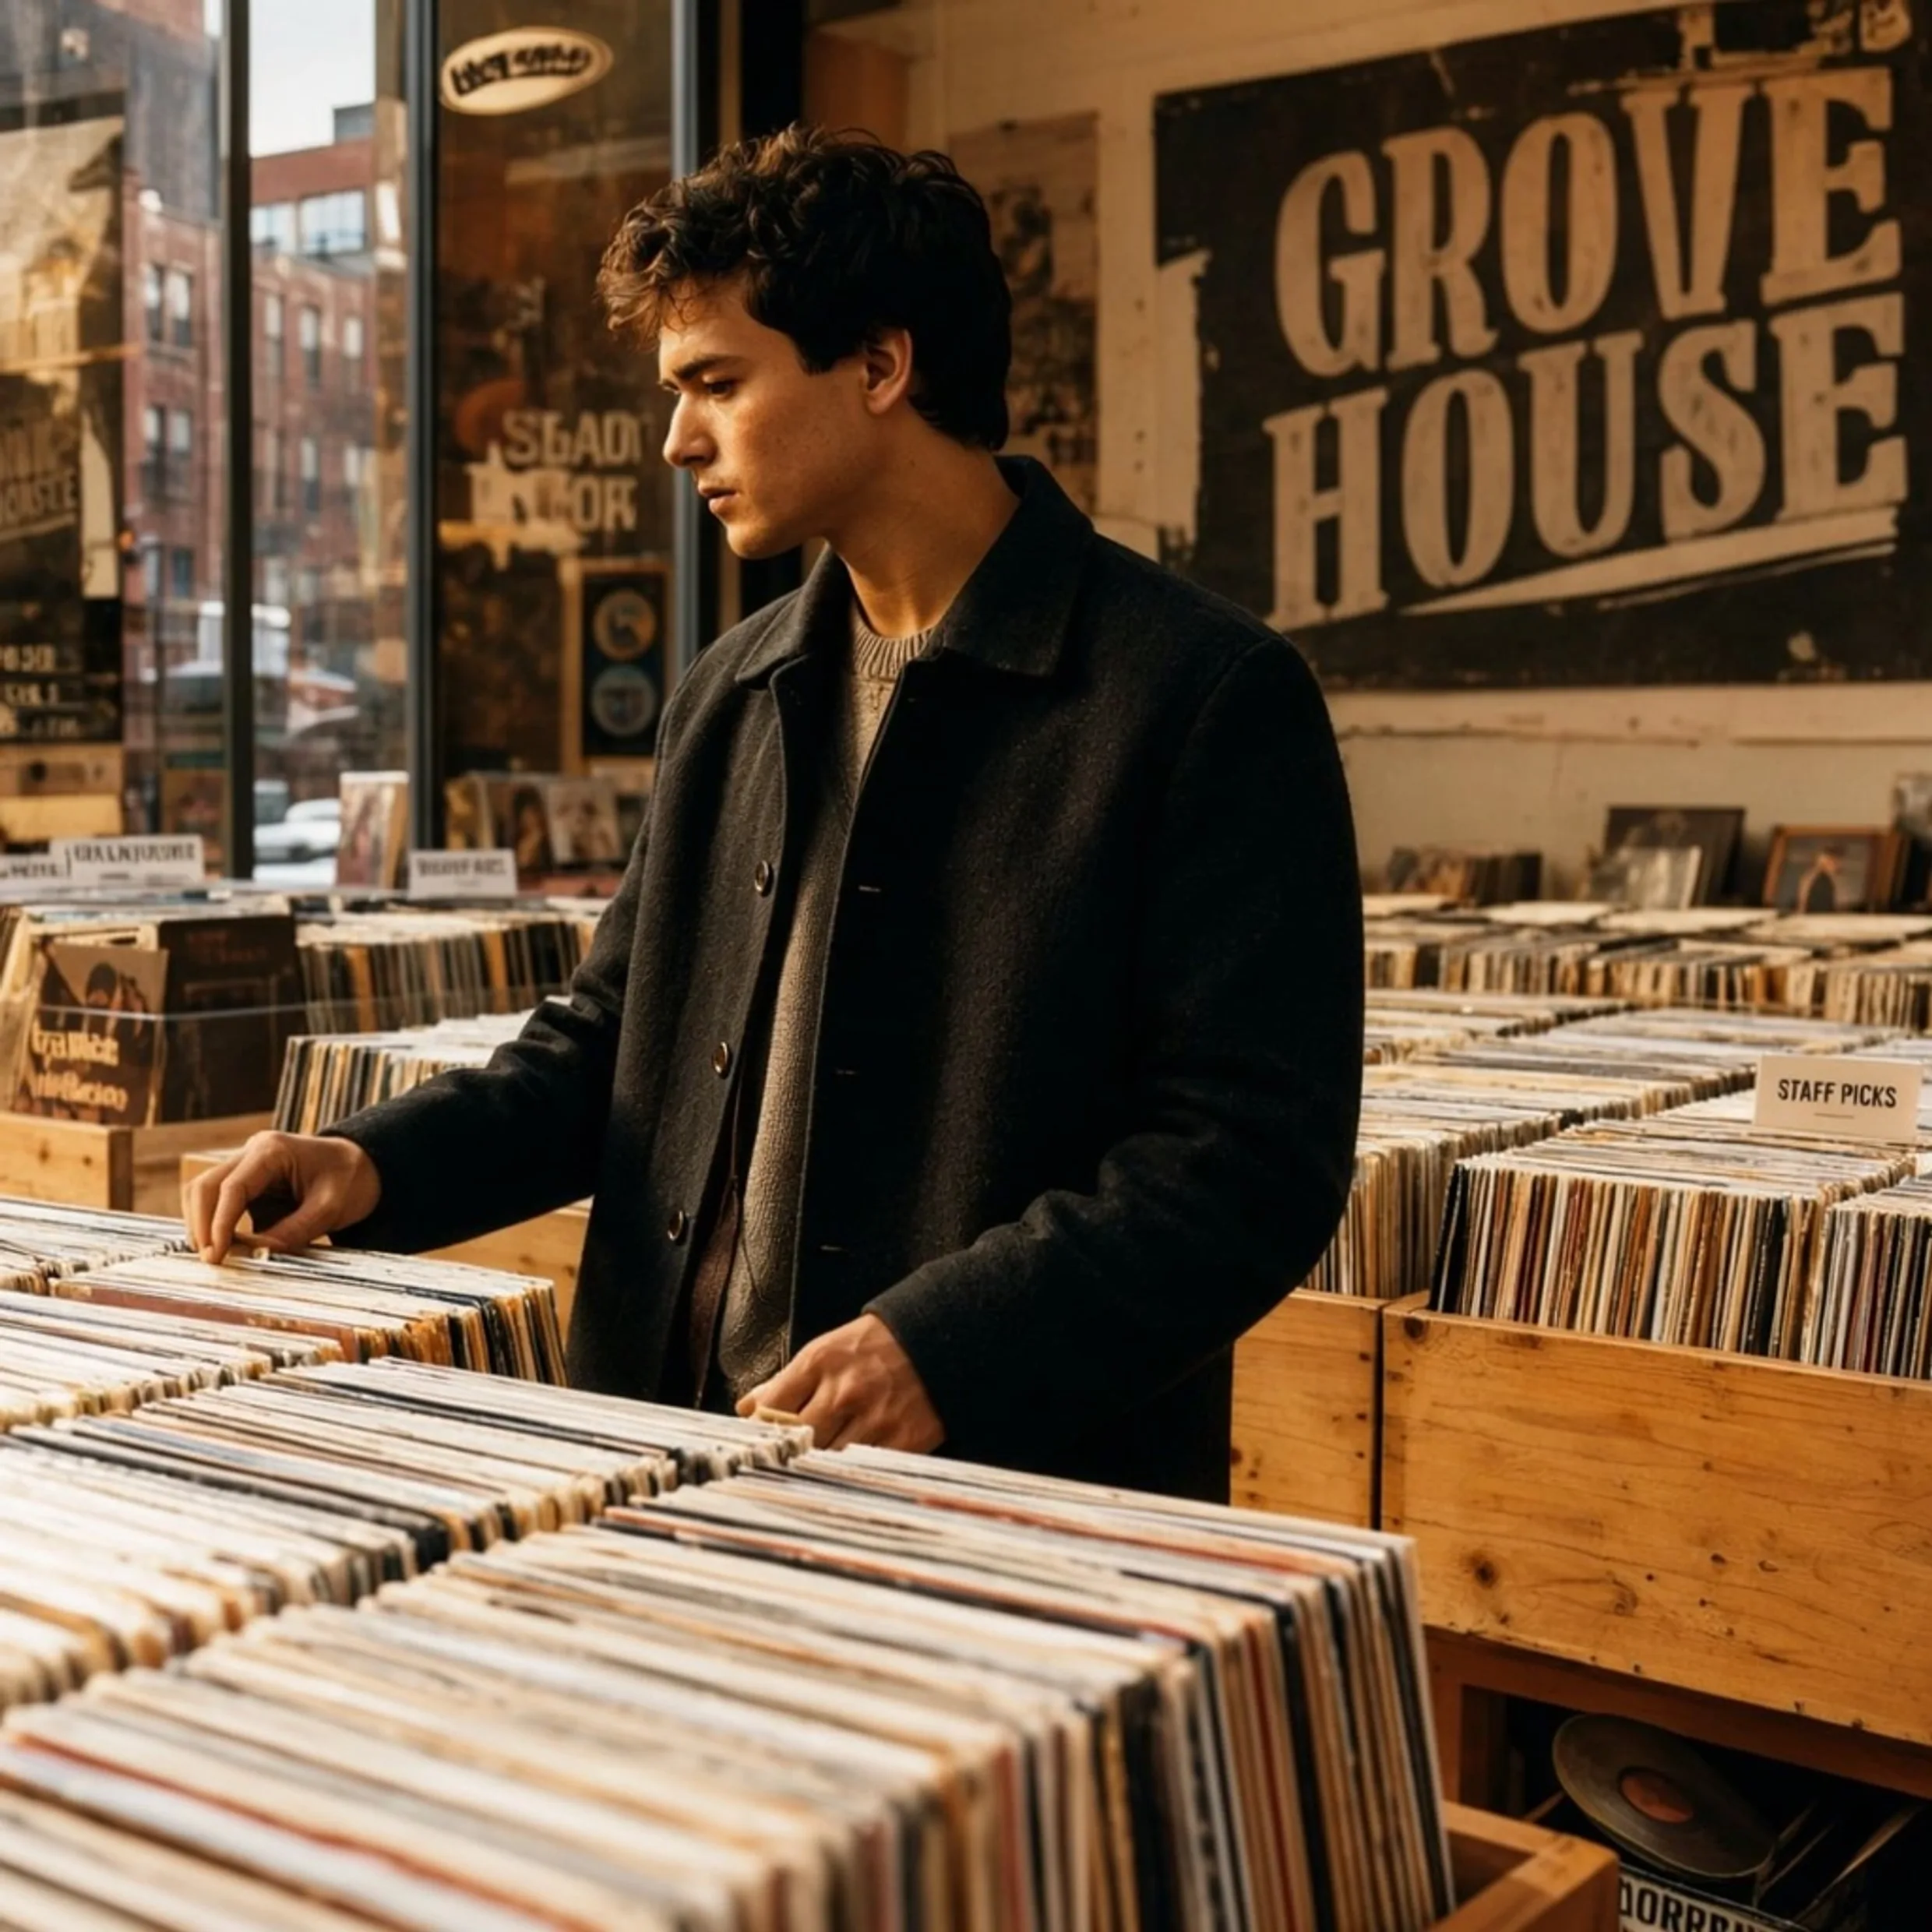
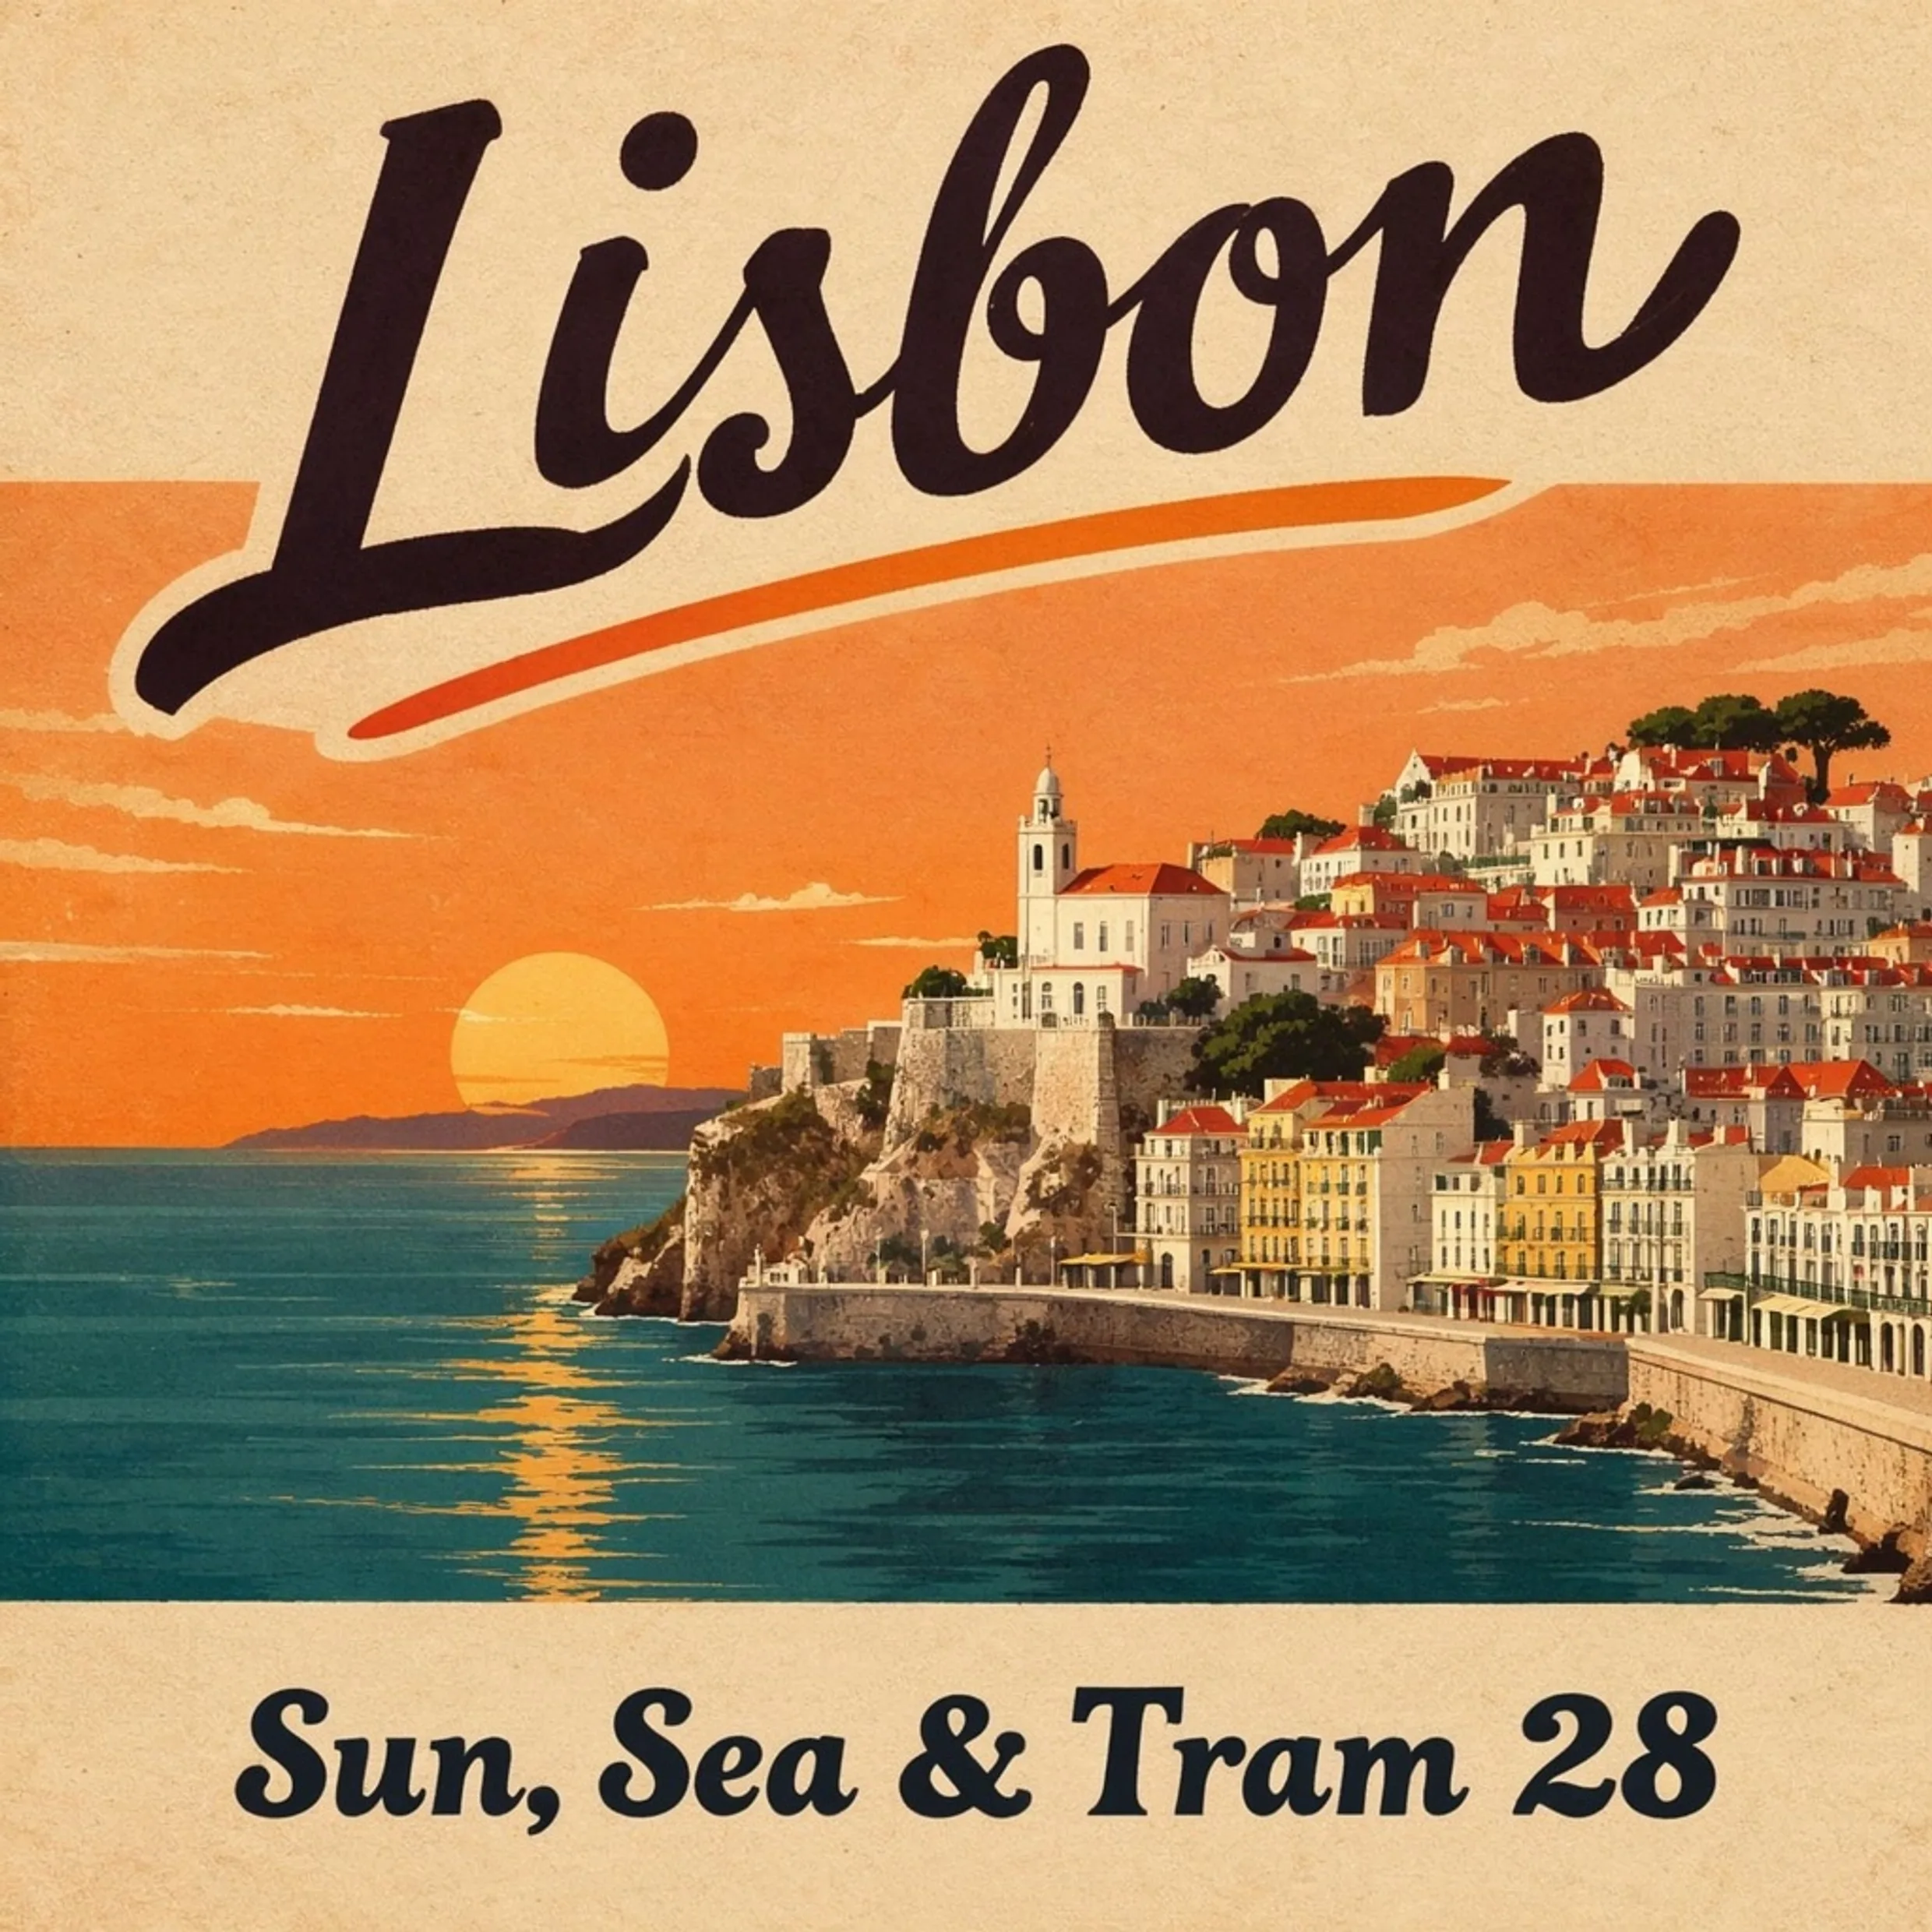
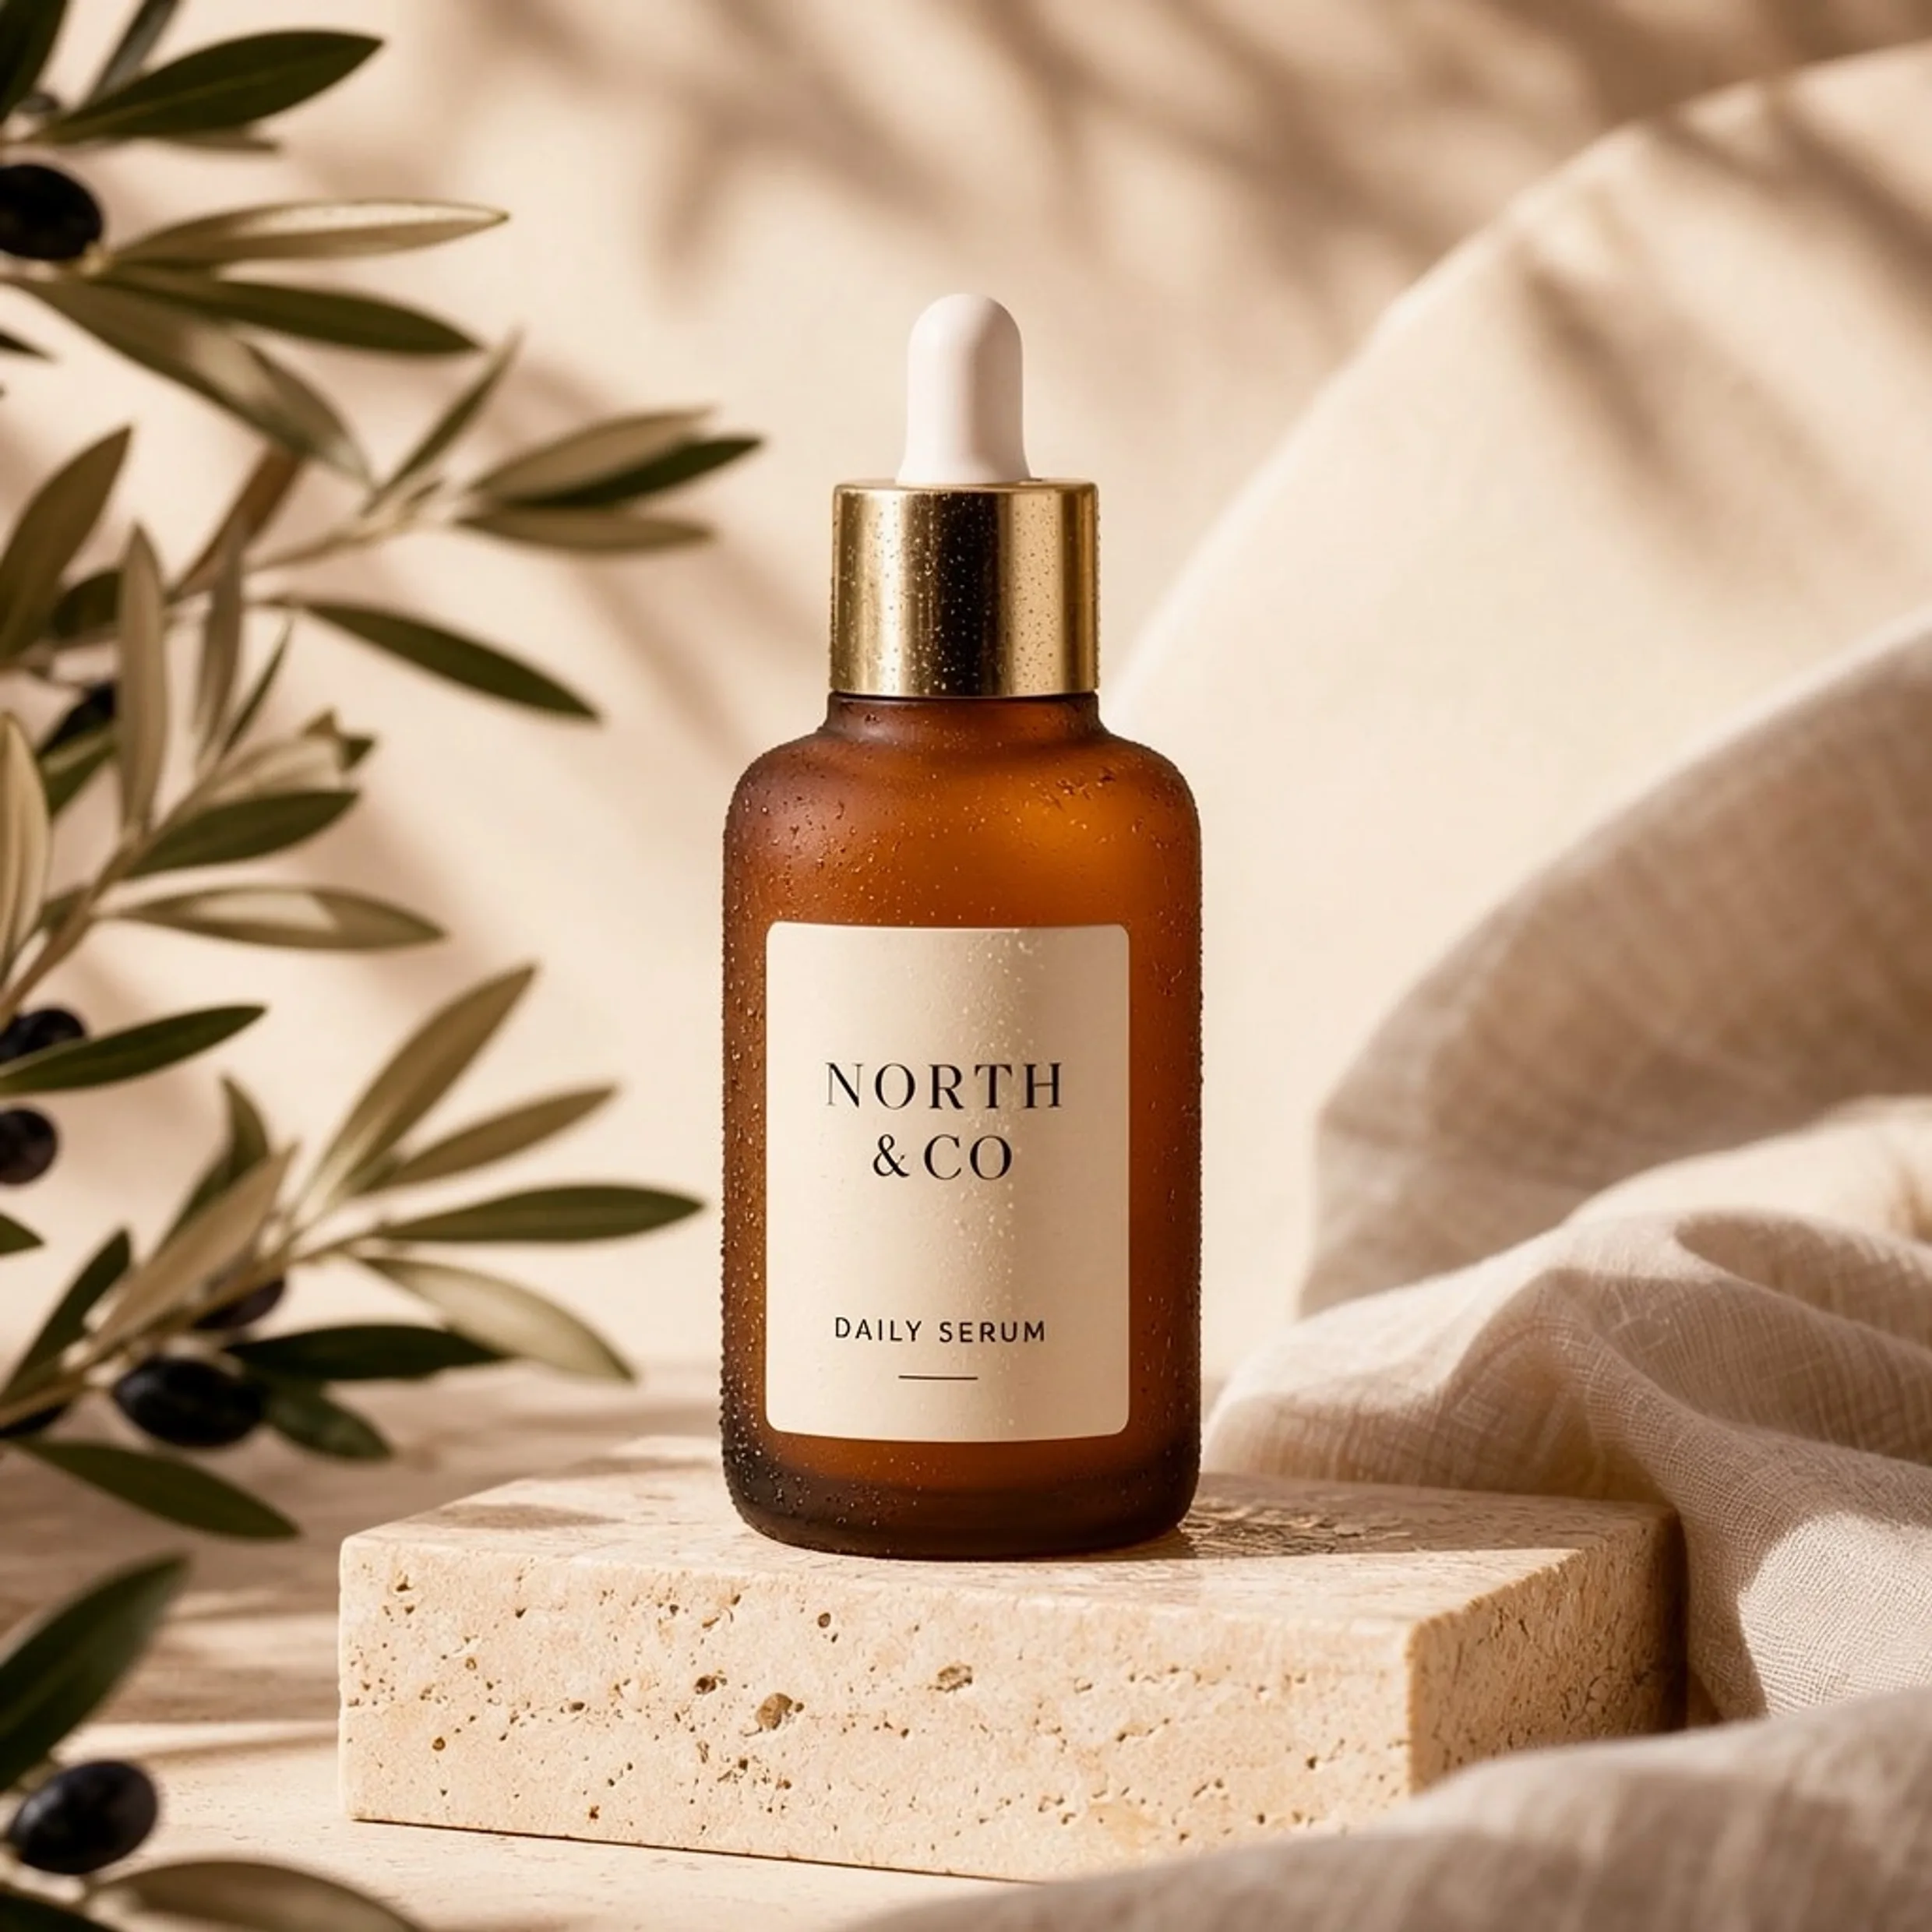
Output reali generati dall'API MOSS Image. Passa il mouse su un video per l'anteprima, clicca per aprire il visualizzatore a schermo intero.
Guida
Come usare l'API MOSS Image
Quattro passaggi dalla registrazione alla generazione completata. Esempi completi in Python, Node.js e cURL sono nella sezione API qui sotto.
- 01
Ottieni una chiave API
Registrati su WaveSpeedAI e copia la tua chiave API dalla dashboard. I nuovi account includono crediti gratuiti di benvenuto: bastano per usare il playground qualche decina di volte prima che inizi la fatturazione.
- 02
Invia una predizione
Invia con POST il tuo input in formato JSON a https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image. L'endpoint restituisce subito un id di predizione: le generazioni sono asincrone, quindi non devi tenere una connessione aperta durante l'inferenza.
- 03
Controlla il completamento
Fai GET su https://api.wavespeed.ai/api/v3/predictions/{request_id}/result. Restituisci gli output con completed; interrompi con un errore con failed, cancelled, timeout o deleted; continua il polling per ogni altro stato.
- 04
Leggi l'URL dell'output
Quando lo stato è "completed", leggi l'URL da data.outputs[0]. L'URL punta al tuo contenuto generato sulla CDN di WaveSpeedAI: immagine, video, audio o file 3D a seconda della variante di MOSS Image che hai richiamato.
Casi d'uso
Cosa puoi creare con MOSS Image
I flussi di lavoro più comuni per cui sviluppatori e creator usano l'API MOSS Image.
Prompt lunghi e dettagliati
wavespeed-ai/moss-image/text-to-image è pensato per prompt che descrivono un'intera scena nel dettaglio: soggetto, ambientazione, illuminazione, composizione e stile in un solo paragrafo.
Poster e copertine con testo cinese o inglese
Il modello renderizza testo cinese e inglese all'interno dell'immagine, adatto a poster, copertine di libri e album, mockup di insegne e card social in cui le parole fanno parte dell'immagine.
Stili e personaggi personalizzati con LoRA
wavespeed-ai/moss-image/text-to-image-lora applica fino a tre LoRA contemporaneamente, ciascuno con la propria scala, per uno stile aziendale, un personaggio ricorrente o l'aspetto di un prodotto.
Immagini grandi per stampa e display
Il livello 2k produce circa 4 megapixel in un solo passaggio, mentre il livello 1.5k si colloca tra 2k e 1k per un'immagine più grande a un costo inferiore.
Esecuzioni ripetibili con un seed
Imposta il seed per ripetere un risultato cambiando solo il prompt o la scala del LoRA, e lascialo a -1 per ottenere ogni volta una nuova variazione.
Consigli
Consigli per scrivere i prompt per MOSS Image
Consigli pratici per ottenere output migliori da MOSS Image, ricavati dagli schemi che funzionano con i modelli immagini nelle pipeline di produzione.
- 01
Scrivi l'intera scena in un solo paragrafo
MOSS Image gestisce bene i prompt lunghi. Descrivi soggetto, ambientazione, illuminazione, composizione e stile in un solo paragrafo invece che con un elenco di parole chiave.
- 02
Metti le parole esatte tra virgolette
Per il testo dentro l'immagine, metti tra virgolette le parole che vuoi e indica dove vanno, ad esempio un titolo in alto o una piccola riga sotto il logo. Sia il cinese sia l'inglese vengono renderizzati.
- 03
Scegli il livello prima della proporzione
Usa 1k per esplorare, 1.5k per la maggior parte delle consegne e 2k per le stampe grandi, poi scegli la proporzione. Il livello stabilisce i pixel totali e la proporzione ne definisce la forma.
- 04
Regola i LoRA con la scala
Sull'endpoint text-to-image-lora parti da una scala di 1 per ogni LoRA e regola a piccoli passi; con più LoRA abbassa leggermente ciascuna scala perché non si ostacolino a vicenda.
Prezzi
Prezzi dell'API MOSS Image
Il prezzo è per output. L'addebito finale dipende dai parametri impostati nel playground di ciascuna variante (risoluzione, durata, numero di output, riferimenti).
| Endpoint | Tipo | Prezzo di partenza |
|---|---|---|
| wavespeed-ai/ | text-to-image | $0.025 |
| wavespeed-ai/ | text-to-image | $0.02 |
API
Richiama l'API MOSS Image
Ottieni una chiave API su wavespeed.ai/accesskey, poi invia una predizione tramite REST. Il playground genera esempi pronti da incollare per qualsiasi combinazione di input.
POSThttps://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "1:1",
    "resolution": "1k",
    "output_format": "jpeg"
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)Confronto
MOSS Image a confronto con le alternative
Quando scegliere MOSS Image rispetto a modelli simili su WaveSpeedAI.
MOSS Image vs Qwen-Image
Qwen-Image supporta anch'esso testo cinese e inglese e aggiunge nella sua famiglia image editing, editing multi-immagine e un sistema di angoli di camera. MOSS Image è solo text-to-image, con una variante LoRA e i livelli 1.5K e 2K.
MOSS Image vs FLUX.2 [klein]
FLUX.2 [klein] offre modelli di generazione e di edit da 4B e 9B con supporto LoRA. MOSS Image si concentra su prompt lunghi e sul rendering di testo cinese e inglese, con endpoint di generazione e LoRA ma senza endpoint di edit.
MOSS Image vs Seedream 5
Seedream 5 Pro aggiunge editing di precisione interattivo, separazione dei livelli e fusione multi-immagine. MOSS Image non modifica immagini esistenti: genera da un prompt e da LoRA opzionali.
FAQ
MOSS Image API — Domande frequenti
Prezzi, licenza, integrazione: le domande più comuni sull'uso di MOSS Image su WaveSpeedAI.
Che cos'è MOSS Image?
MOSS Image è un modello text-to-image a pesi aperti di OpenMOSS. Su WaveSpeedAI funziona dietro un'API REST come due endpoint: text-to-image e text-to-image-lora.
MOSS Image modifica le immagini o accetta un'immagine di riferimento?
No. Gli endpoint attivi generano immagini da un prompt testuale, e l'endpoint LoRA aggiunge fino a tre LoRA. Per l'editing usa un modello di edit come Seedream 5 o Qwen-Image.
Come uso i LoRA con MOSS Image?
Invia il parametro loras all'endpoint text-to-image-lora: un elenco di al massimo tre elementi, ciascuno con il path del LoRA (un URL) e una scala tra 0 e 4.
Quali risoluzioni e proporzioni supporta MOSS Image?
Tre livelli di risoluzione (1k, 1.5k, 2k, circa 1, 2,4 e 4 megapixel) e 15 proporzioni da 1:3 a 3:1, tra cui 9:16, 16:9, 9:21 e 21:9.
Che cos'è l'API MOSS Image?
MOSS Image è un modello di generazione di immagini di OpenMOSS reso disponibile come API REST su WaveSpeedAI. OpenMOSS MOSS Image — un modello text-to-image a pesi aperti per prompt lunghi e dettagliati, con testo cinese e inglese nitido all'interno dell'immagine, output 1K, 1.5K o 2K, 15 proporzioni da 1:3 a 3:1 e una variante LoRA che accetta fino a tre LoRA personalizzati. Puoi richiamarlo da codice o provarlo dal playground collegato qui sopra.
Come richiamo l'API MOSS Image?
Registrati su WaveSpeedAI, copia la tua chiave API da /accesskey, poi invia con POST a https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image il tuo input in formato JSON. L'endpoint restituisce un id di predizione. Fai polling sull'endpoint dei risultati circa ogni 2 secondi, aumenta l'intervallo per le attività di lunga durata e fermati a qualsiasi stato terminale. Gli esempi in Python / Node.js / cURL orientati alla produzione sono qui sopra.
Quanto costa l'API MOSS Image?
MOSS Image parte da $0.02 per esecuzione. Il costo esatto dipende dai parametri impostati (risoluzione, durata, numero di output, riferimenti). L'anteprima del costo in tempo reale accanto al pulsante Genera nel playground mostra il prezzo esatto per il tuo input attuale.
Quali varianti di MOSS Image sono disponibili?
WaveSpeedAI offre 2 endpoint MOSS Image attivi: wavespeed-ai/moss-image/text-to-image-lora, wavespeed-ai/moss-image/text-to-image. Ogni variante ha la sua pagina playground e i suoi prezzi.
Posso usare gli output di MOSS Image a fini commerciali?
I diritti di uso commerciale seguono la licenza del modello di OpenMOSS. La maggior parte dei modelli di OpenMOSS consente l'uso commerciale degli output; consulta la pagina playground di ciascun modello per il riepilogo della licenza e i Termini di servizio di WaveSpeedAI per le condizioni a livello di piattaforma.
Perché usare MOSS Image su WaveSpeedAI invece di rivolgersi direttamente al fornitore?
Una sola chiave API e un solo account di fatturazione per MOSS Image E per oltre 1.000 altri modelli AI di altri provider. Nessuna configurazione di SDK per fornitore, nessun limite di frequenza separato, nessun codice di integrazione da riscrivere per ogni fornitore. I prezzi sono in genere in linea o inferiori a quelli dell'API diretta di OpenMOSS.
Provider
Informazioni su OpenMOSS
Il team dietro MOSS Image e dietro l'intera gamma di modelli di OpenMOSS su WaveSpeedAI.
OpenMOSS è il team open source dietro la famiglia di modelli MOSS. MOSS Image è rilasciato a pesi aperti con licenza Apache-2.0 e genera immagini da prompt lunghi, con rendering di testo cinese e inglese, output fino a 2K e supporto LoRA. WaveSpeedAI lo ospita dietro un'API REST con un endpoint text-to-image e uno text-to-image-lora.
Inizia a creare con MOSS Image su WaveSpeedAI
Crediti gratuiti di benvenuto alla registrazione. Una sola chiave API per oltre 1.000 modelli AI di OpenMOSS e di ogni altro provider.