MOSS Image API
OpenMOSS MOSS Image – ein Text-to-Image-Modell mit offenen Gewichten für lange, detaillierte Prompts, mit scharf gerendertem chinesischem und englischem Text im Bild, Ausgabe in 1K, 1.5K oder 2K, 15 Seitenverhältnissen von 1:3 bis 3:1 und einer LoRA-Variante, die bis zu drei eigene LoRAs aufnimmt.
Dieser MOSS Image API-Leitfaden behandelt die beiden aktiven Endpunkte auf WaveSpeedAI, text-to-image und text-to-image-lora, mit den Stufen 1K, 1.5K und 2K, den Seitenverhältnissen, den Ausgabeformaten und den LoRA-Eingaben. Playground, Beispiele, Preise und API-Beispiele weiter unten nutzen durchgehend die aktiven MOSS Image-Endpunkte.
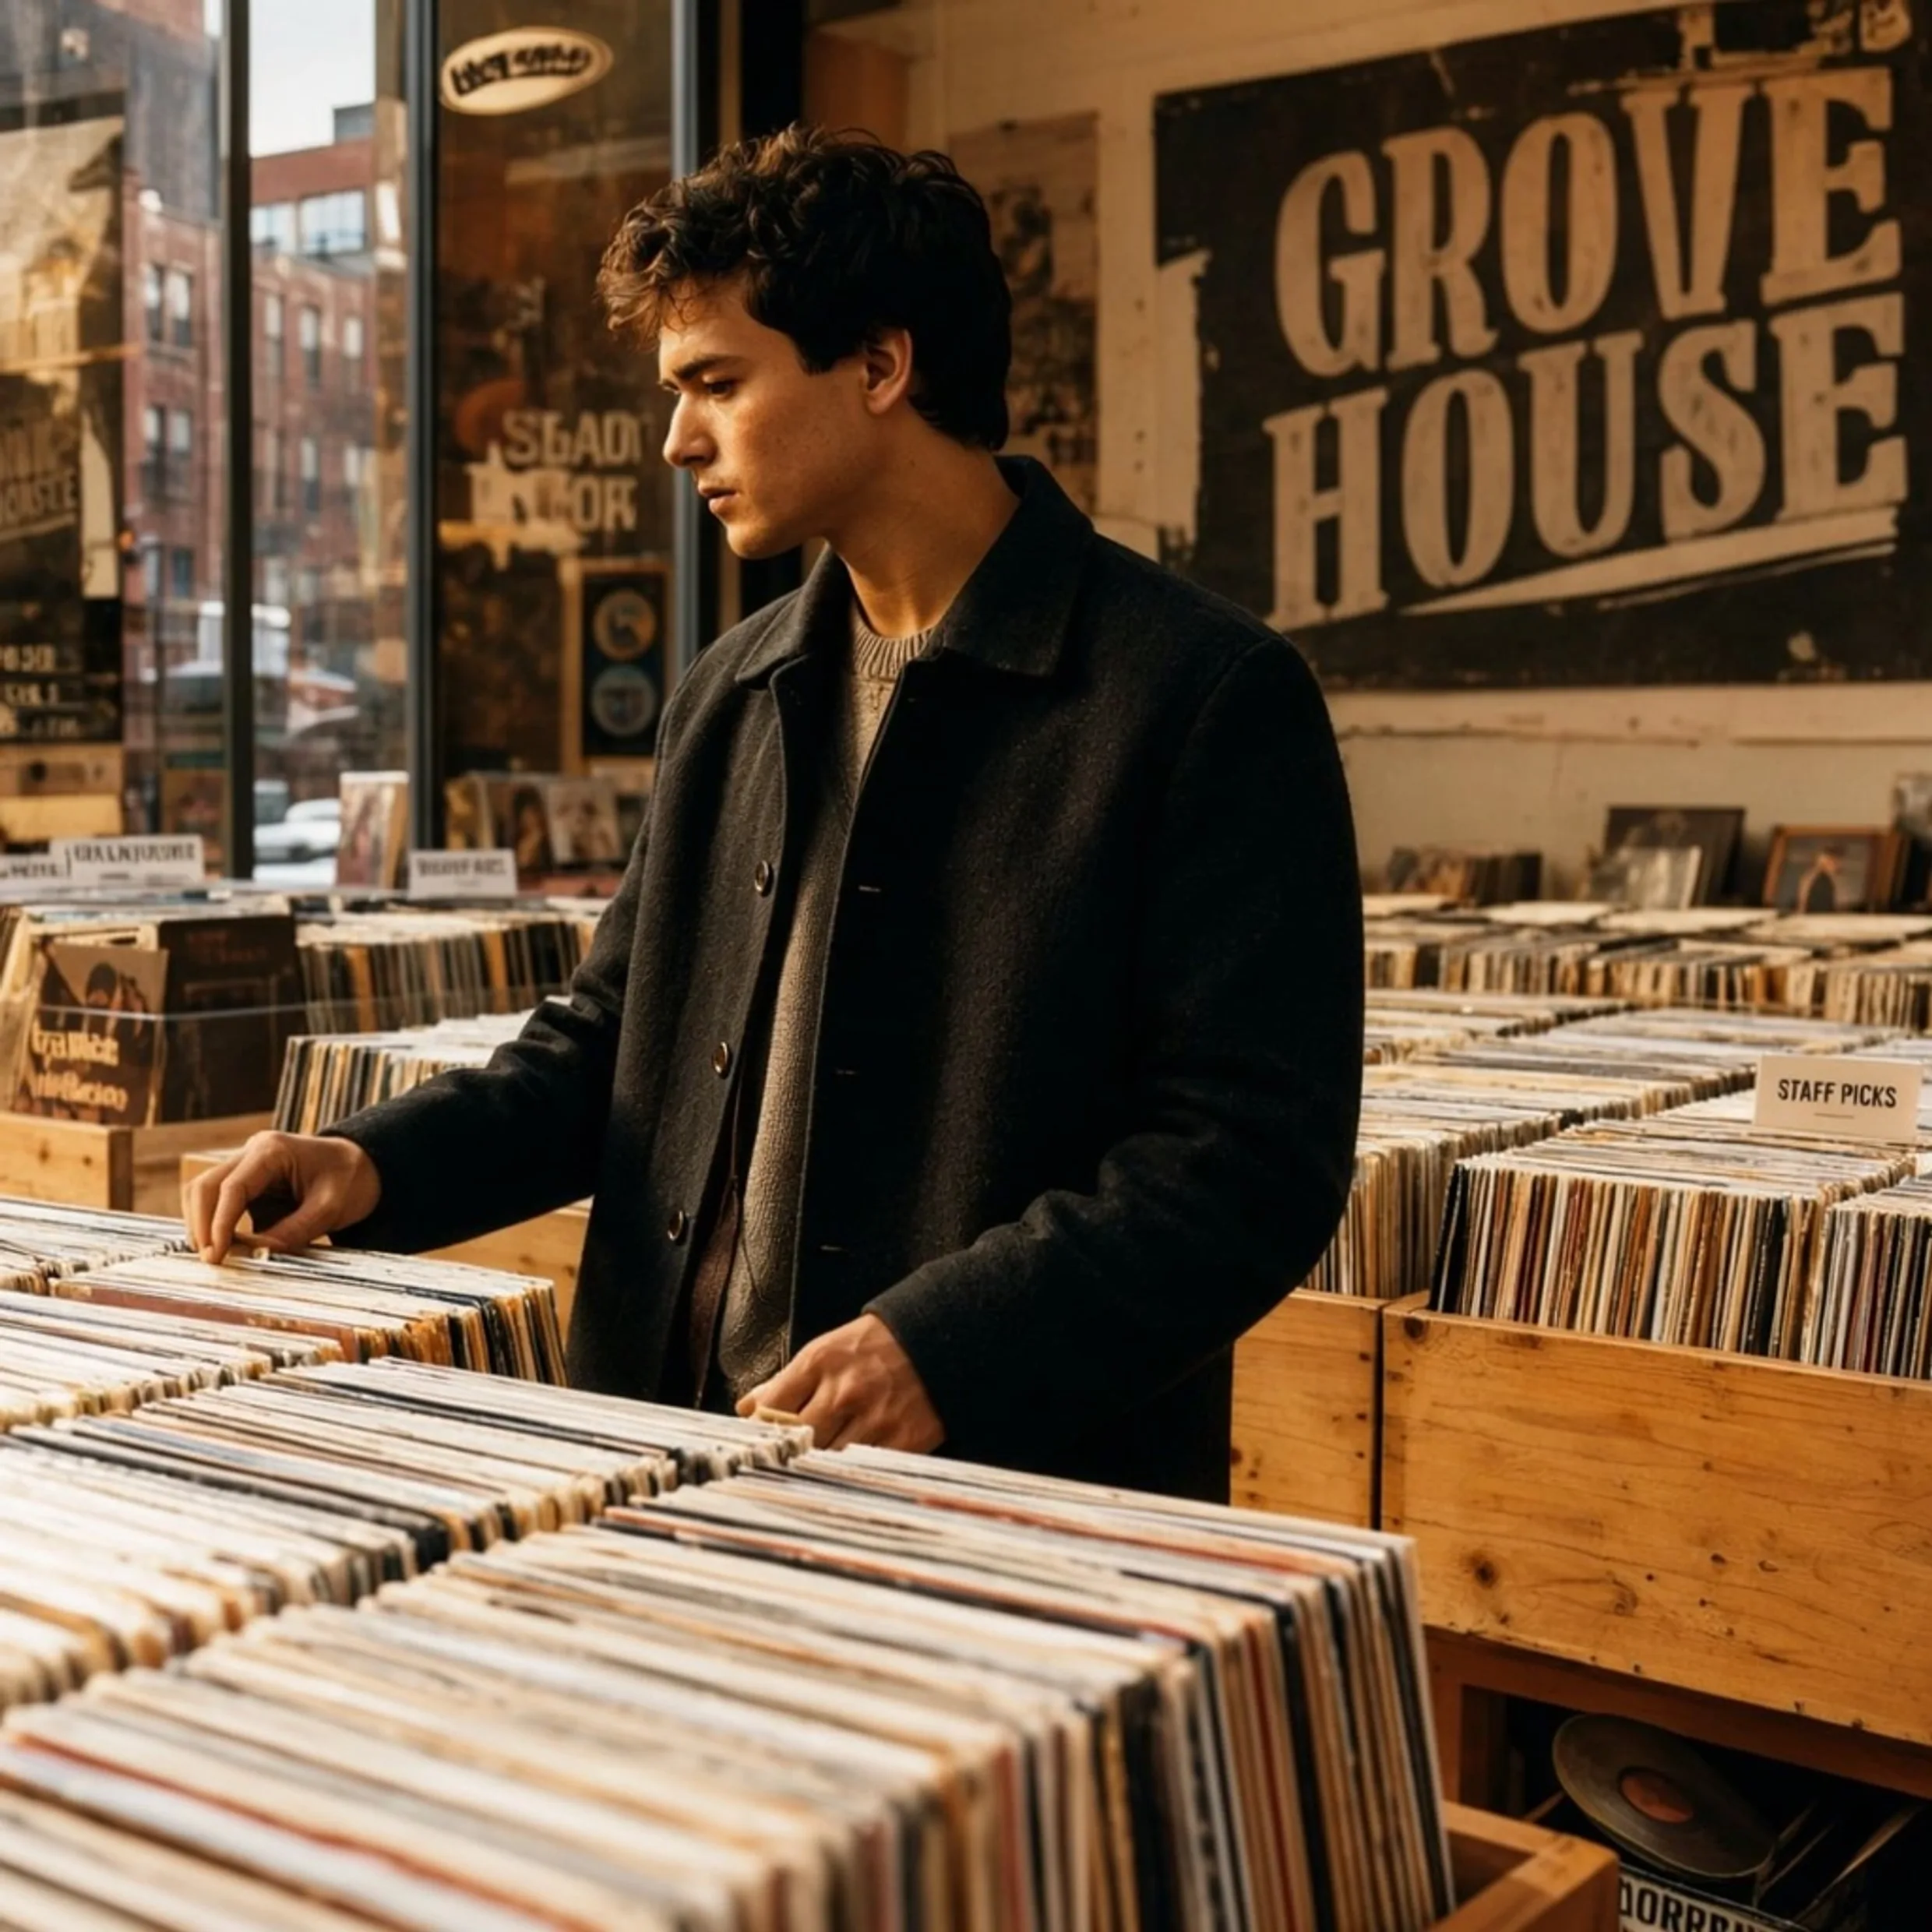
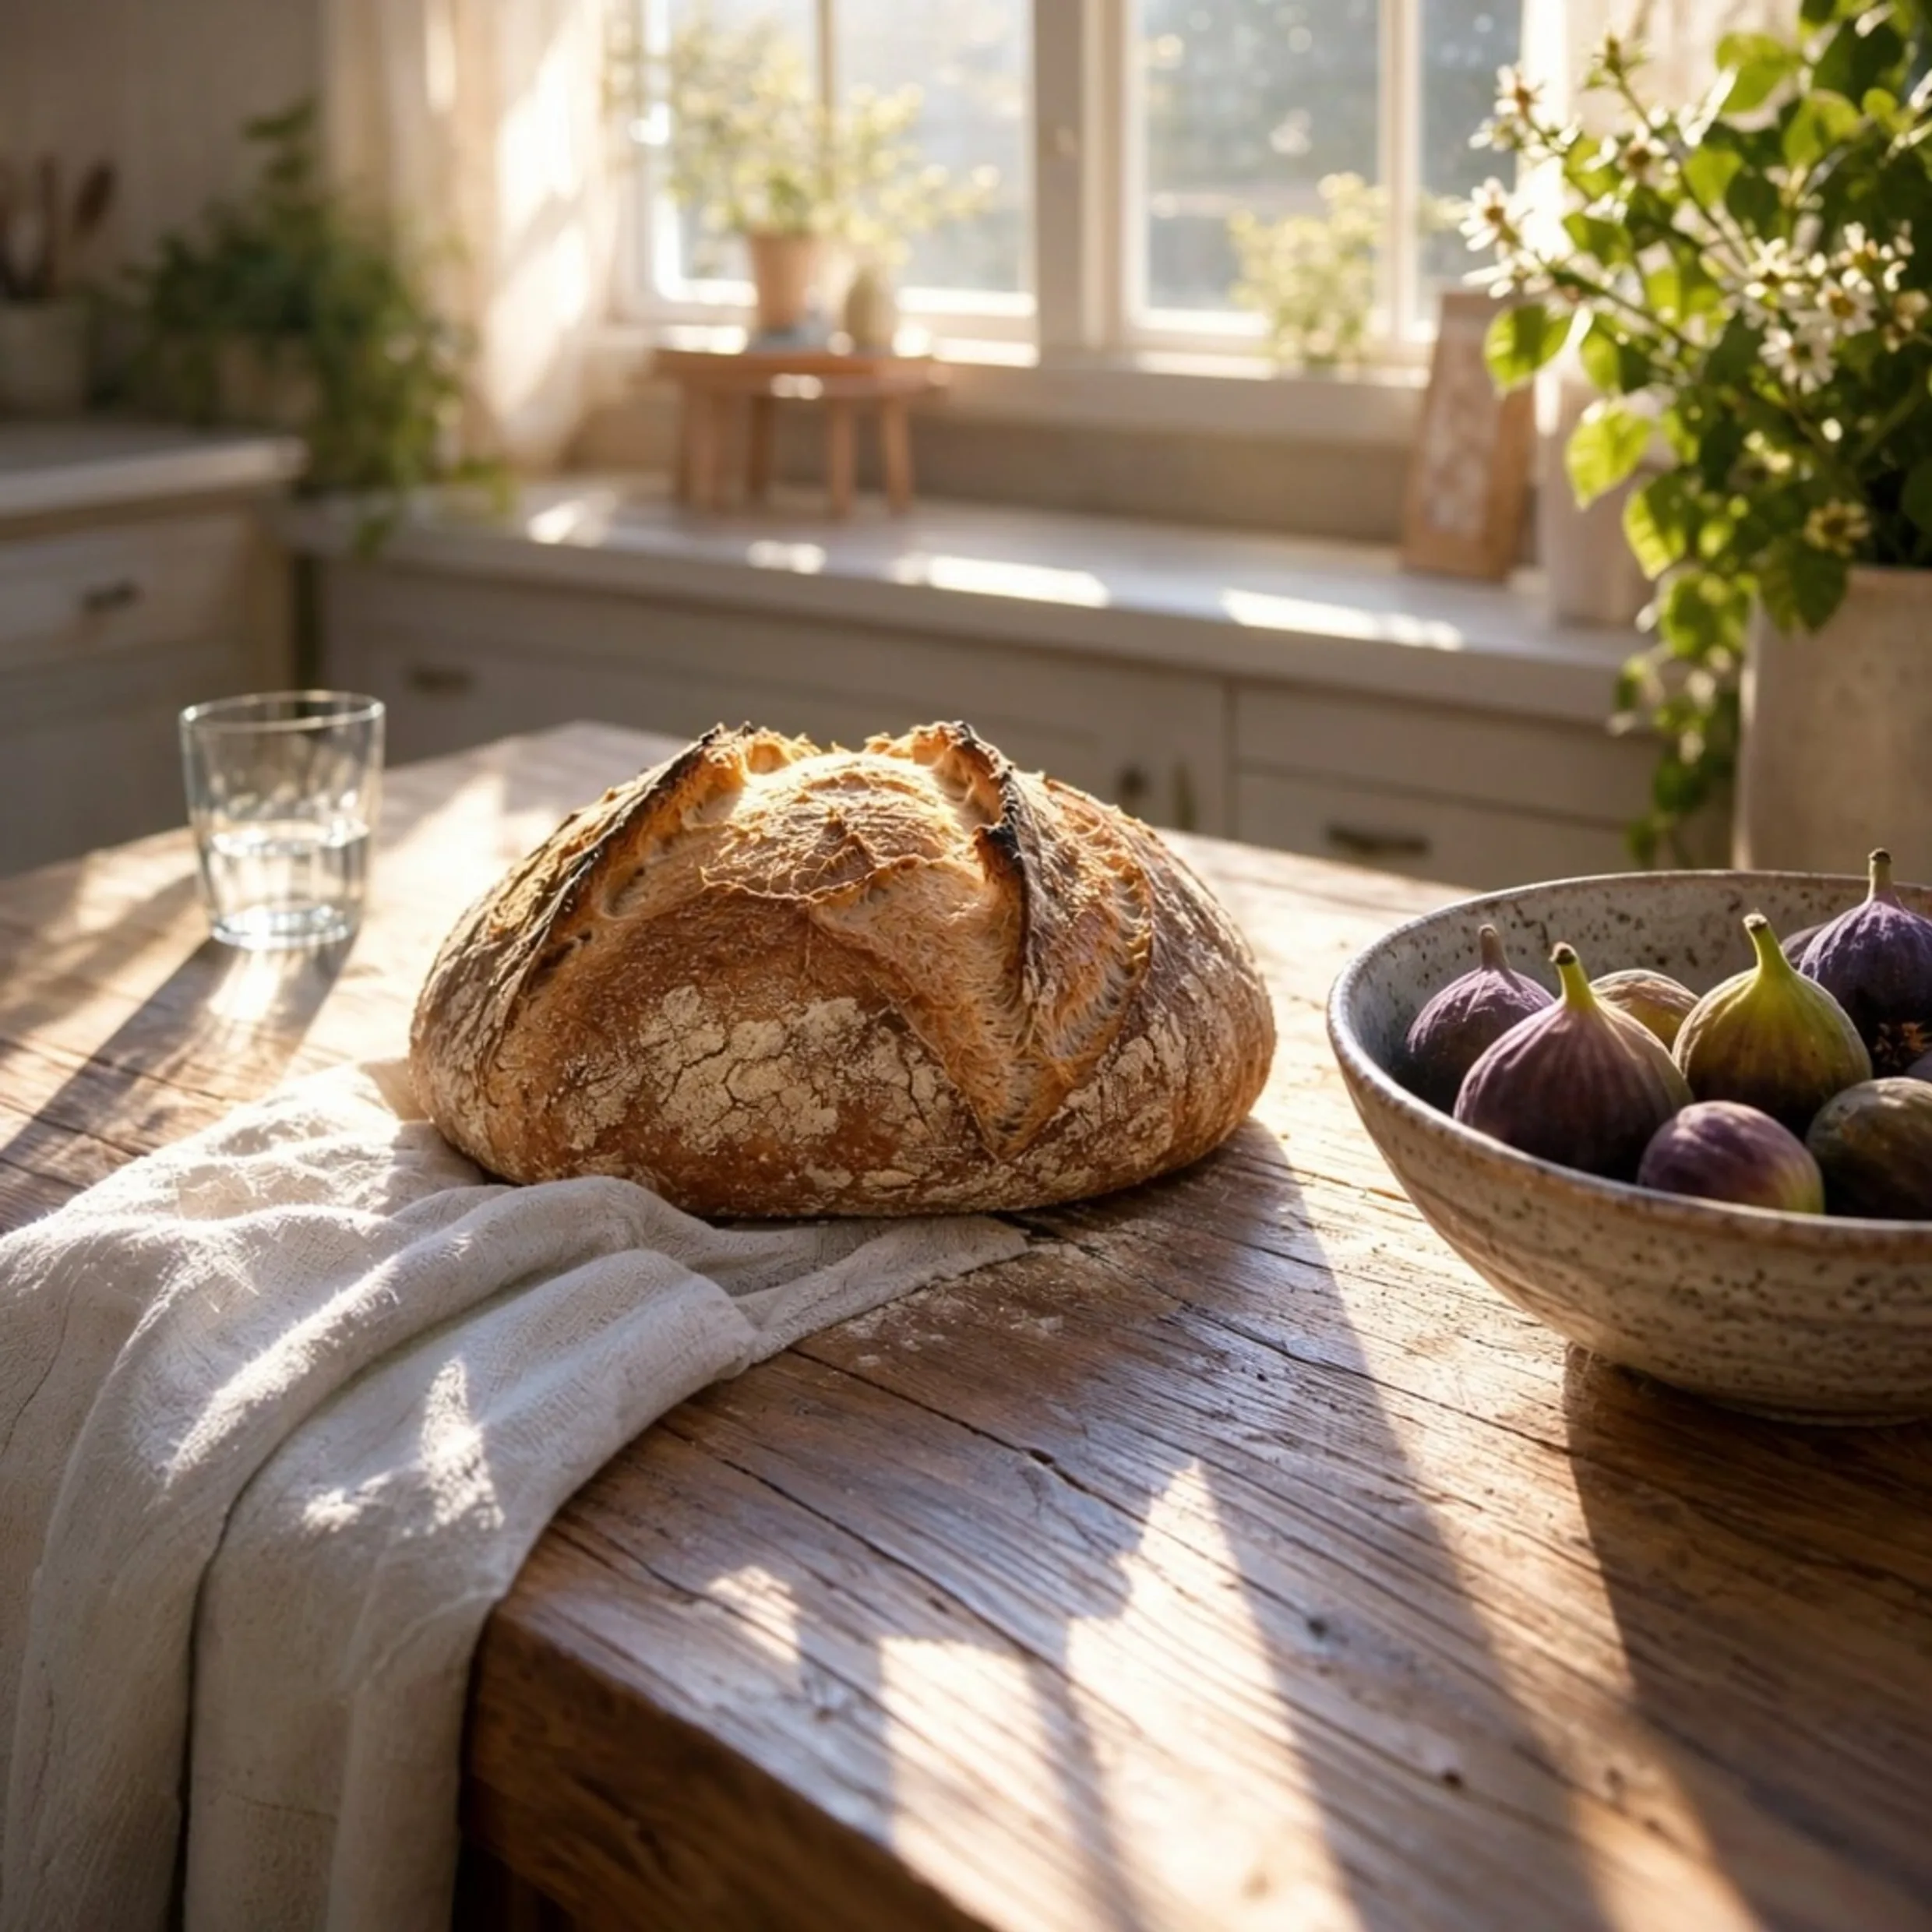
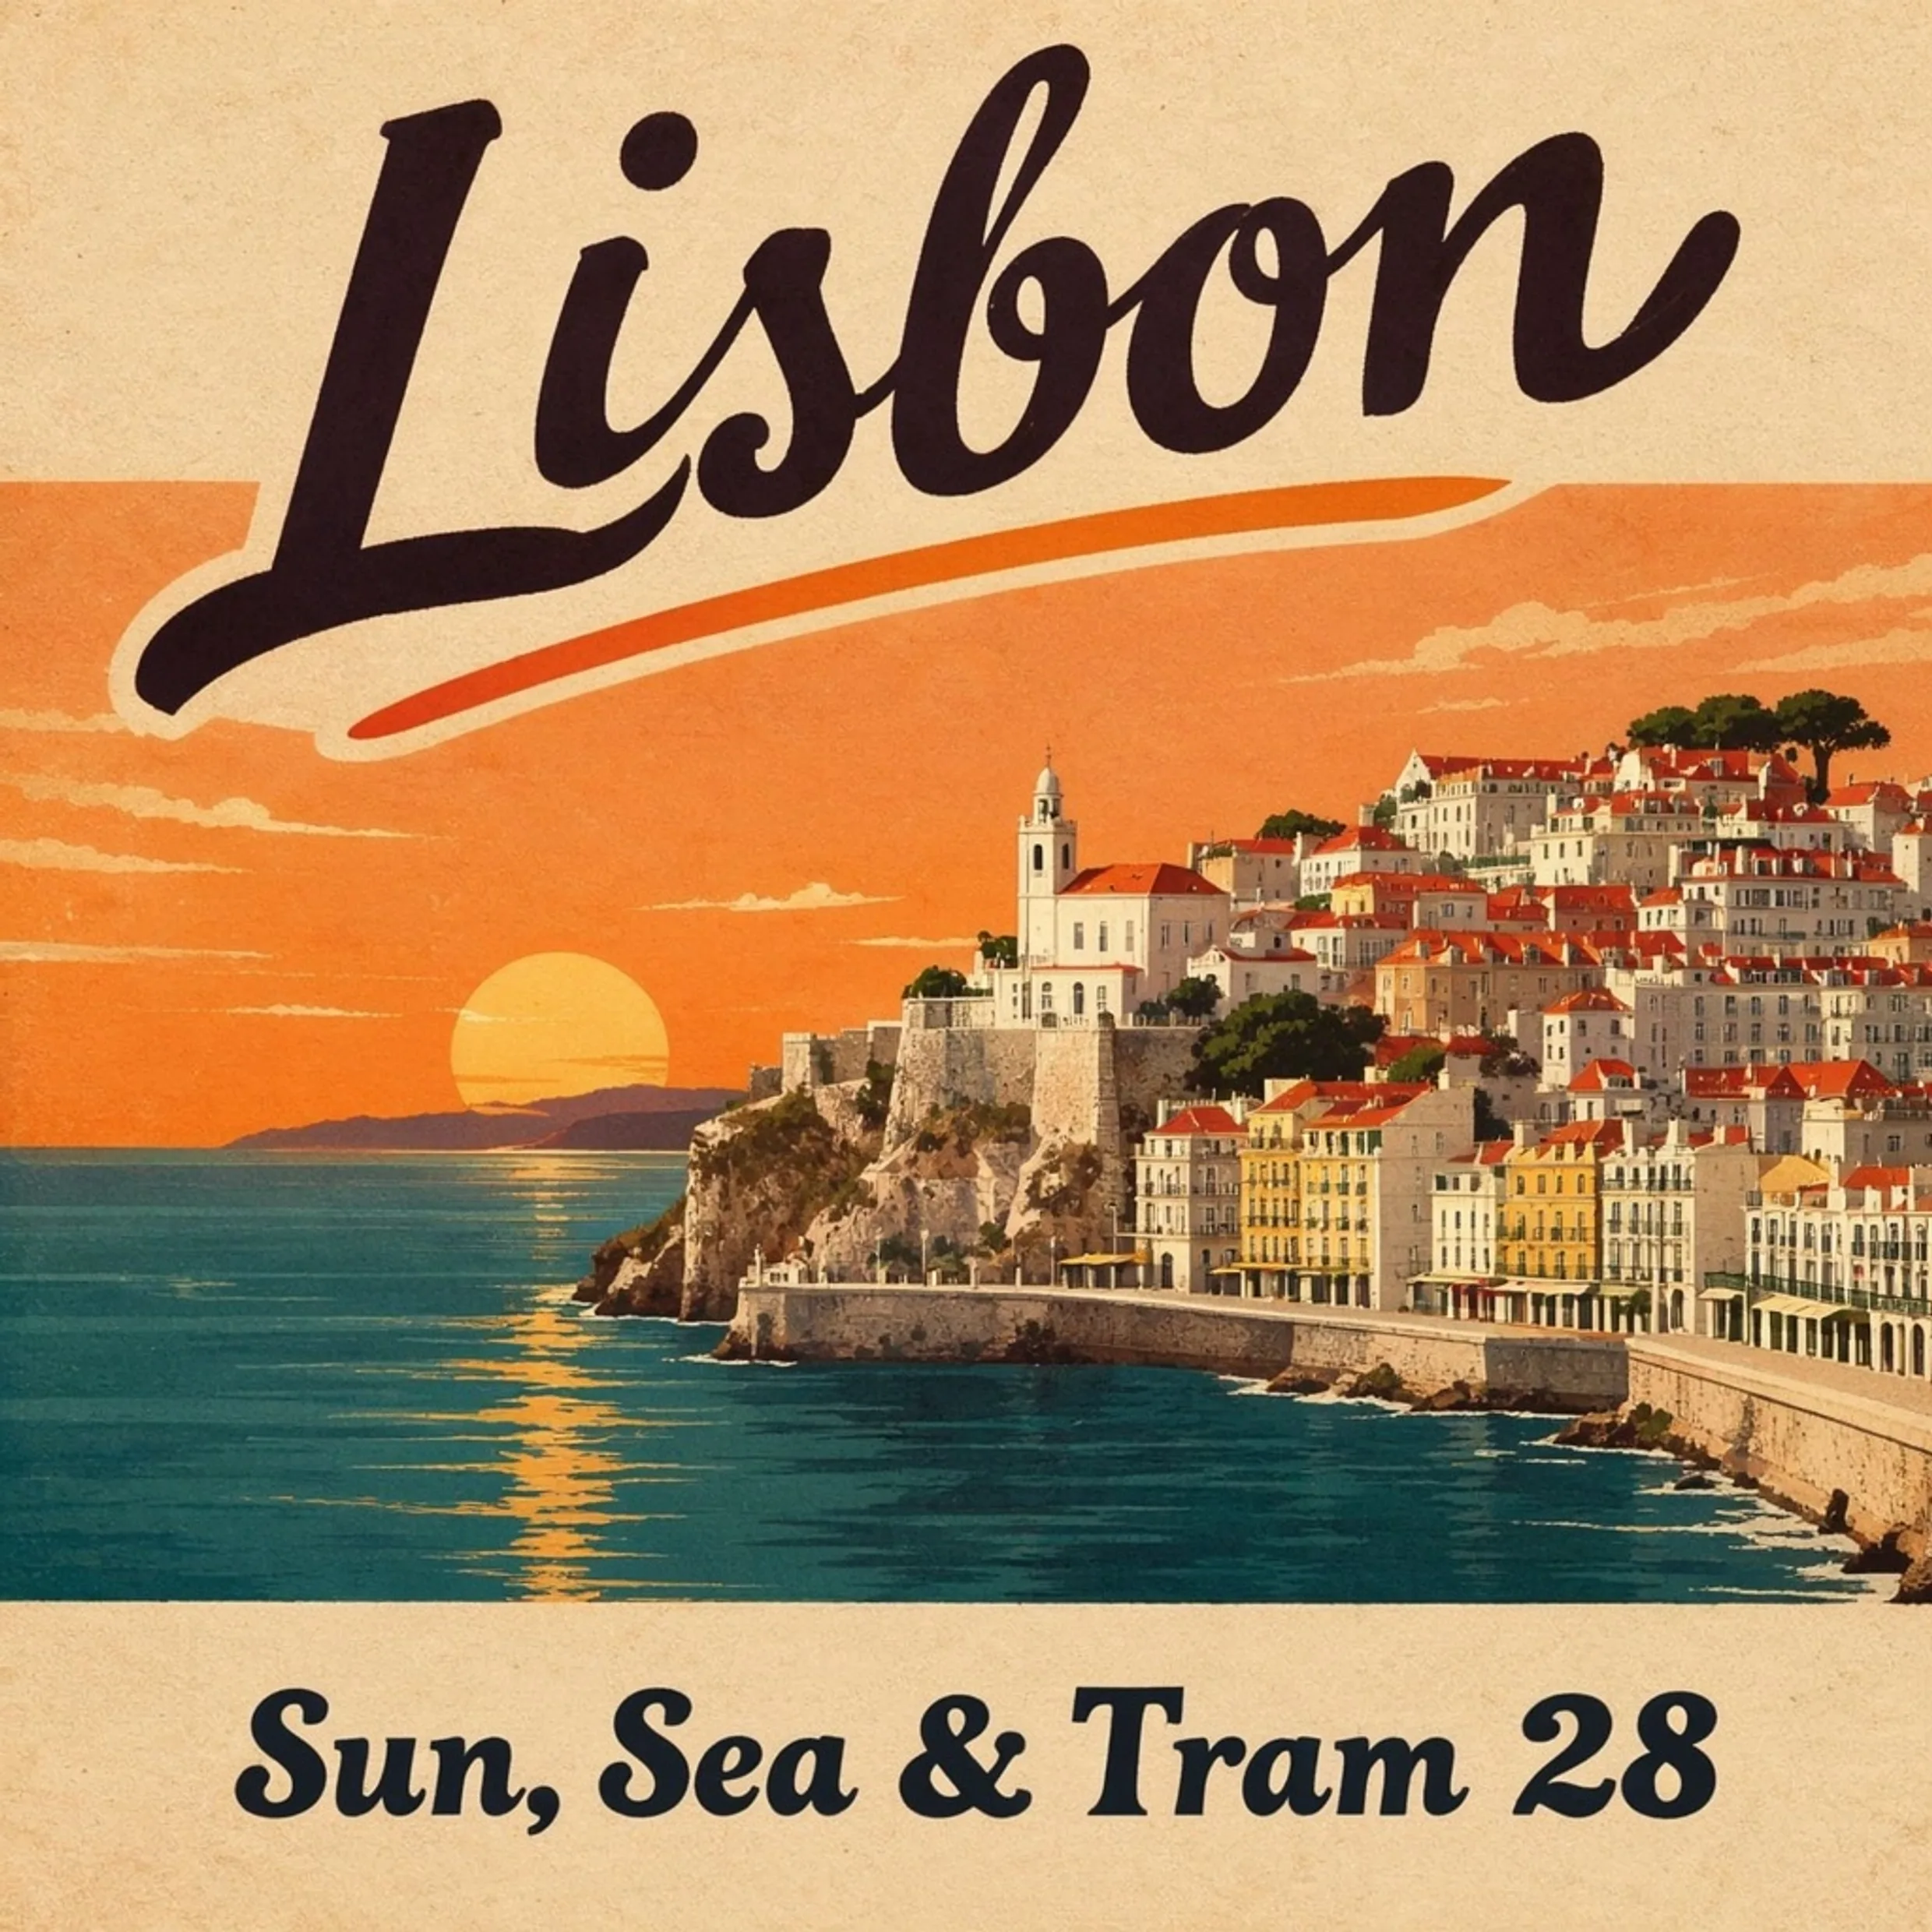
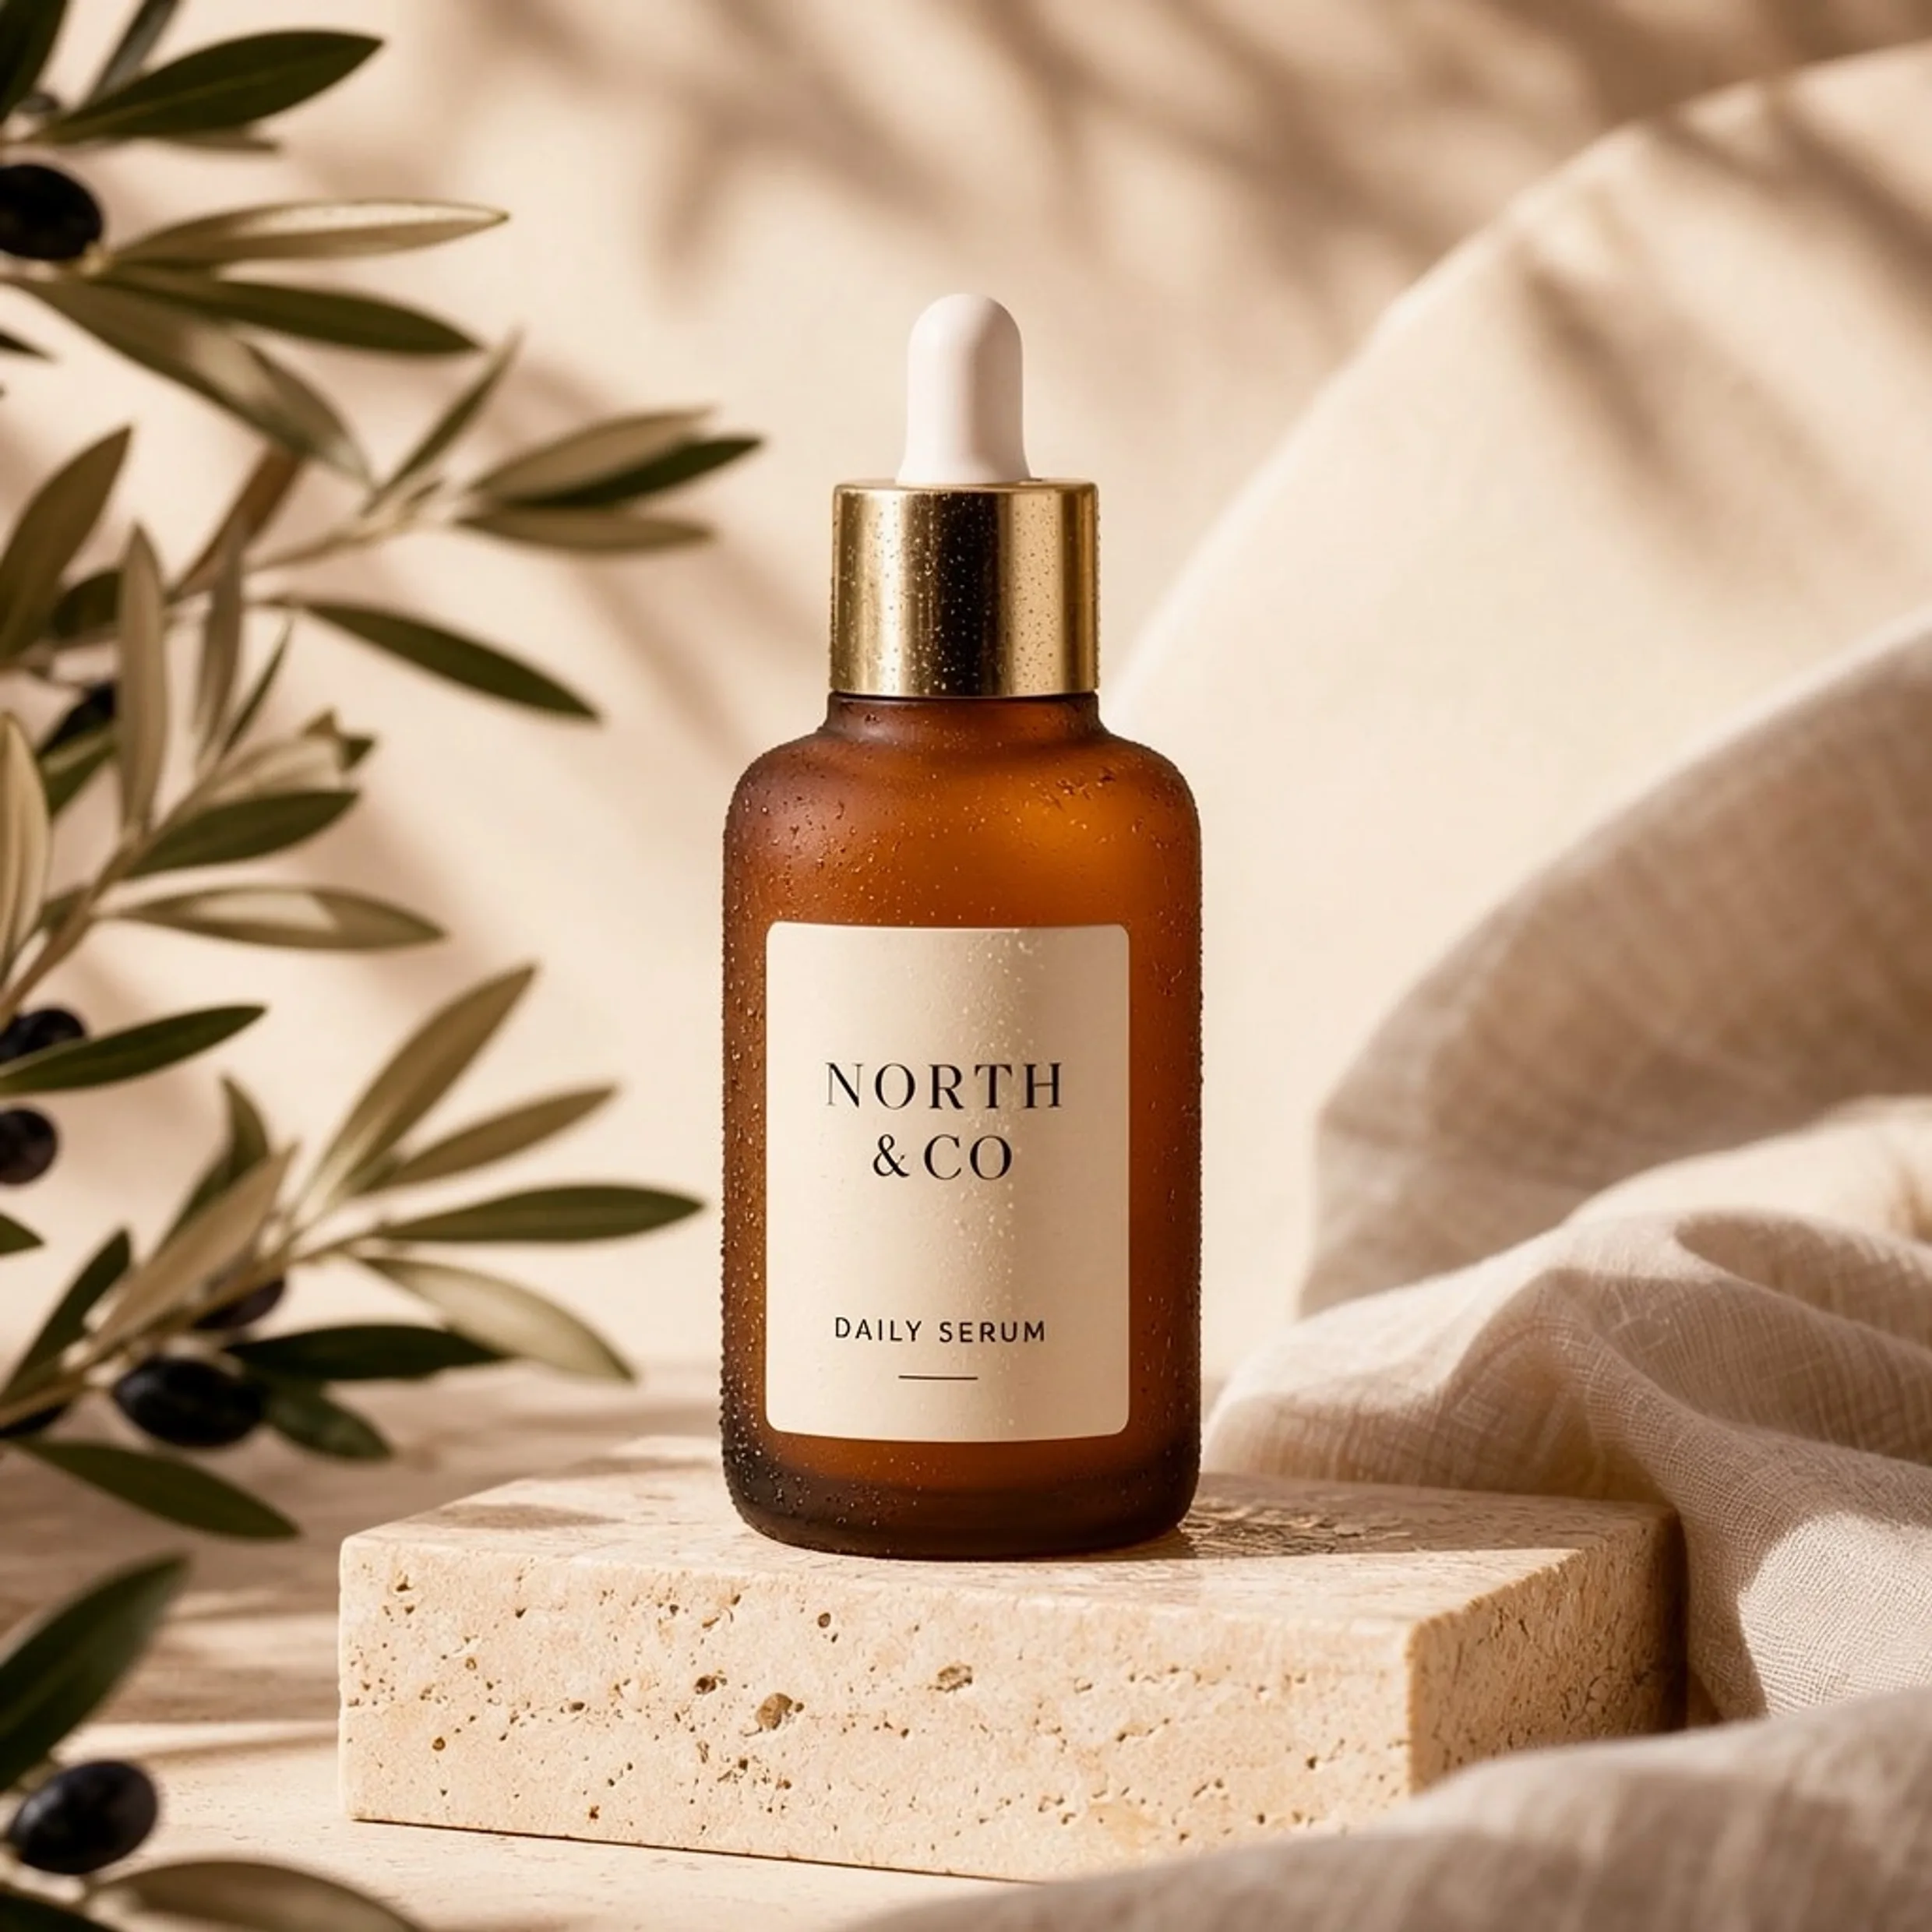
Überblick
Über MOSS Image API
Was MOSS Image leistet, wie es in die Modellpalette von OpenMOSS passt und warum Teams darauf zurückgreifen.
MOSS Image ist ein Modell von OpenMOSS für Bildgenerierung und -bearbeitung, verfügbar über die WaveSpeedAI-REST-API. OpenMOSS MOSS Image – ein Text-to-Image-Modell mit offenen Gewichten für lange, detaillierte Prompts, mit scharf gerendertem chinesischem und englischem Text im Bild, Ausgabe in 1K, 1.5K oder 2K, 15 Seitenverhältnissen von 1:3 bis 3:1 und einer LoRA-Variante, die bis zu drei eigene LoRAs aufnimmt.
Dieser MOSS Image API-Leitfaden behandelt die beiden aktiven Endpunkte auf WaveSpeedAI, text-to-image und text-to-image-lora, mit den Stufen 1K, 1.5K und 2K, den Seitenverhältnissen, den Ausgabeformaten und den LoRA-Eingaben. Playground, Beispiele, Preise und API-Beispiele weiter unten nutzen durchgehend die aktiven MOSS Image-Endpunkte.
Die Familie MOSS Image auf WaveSpeedAI umfasst 2 REST-Endpunkte für den Workflow Text-To-Image. Jede Variante hat eigene Preise, Parameter und Beispielausgaben – wählen Sie die, die zu Ihrer Eingabemodalität und Ihren Produktionsanforderungen passt, oder rufen Sie mit demselben API-Schlüssel mehrere auf, um mehrstufige Pipelines zu bauen.
Nutzen Sie MOSS Image mit demselben API-Schlüssel, demselben Abrechnungskonto und denselben Rate Limits wie die über 1.000 weiteren KI-Modelle auf WaveSpeedAI. Keine separate Einrichtung bei Anbietern, keine SDKs pro Anbieter, keine Rate Limits pro Anbieter – eine Integration deckt alles ab, von Text-zu-Bild und Text-zu-Video über Audiosynthese, 3D-Generierung und Hochskalierung bis zur Bearbeitung.
Spezifikationen
Funktionen und Release-Status von MOSS Image API
Die modellspezifischen Details, nach denen Entwickler vor der Wahl einer API suchen: Verfügbarkeit, erwartete Ausgabelänge, Referenzunterstützung und die aktuelle aktive Alternative.
Verfügbarkeit
Jetzt live
MOSS Image ist im WaveSpeedAI-Katalog live, als zwei Endpunkte im selben REST-Prediction-Ablauf: text-to-image und text-to-image-lora.
Auflösungsstufen
1K, 1.5K, 2K
Der Parameter resolution wählt die Gesamtgröße der Ausgabe: 1k sind etwa 1 Megapixel, 1.5k etwa 2,4 Megapixel und 2k etwa 4 Megapixel. Das Seitenverhältnis bestimmt dann die Form.
Seitenverhältnisse
15 Verhältnisse
Von 1:3 und 3:1 über 1:1, 4:5, 3:2, 16:9 und 9:16 bis zum hohen 9:21 und dem breiten 21:9 – ein Endpunkt deckt so Poster, Banner, Smartphone-Screens und quadratische Posts ab.
Text in Bildern
Chinesisch und Englisch
Der Prompt unterstützt lange, detaillierte Beschreibungen, und chinesischer sowie englischer Text wird im Bild gerendert.
LoRA
Bis zu 3
Der Endpunkt text-to-image-lora akzeptiert eine Liste von bis zu drei LoRAs, jeweils mit einem Pfad und einer Skalierung von 0 bis 4.
Ausgabeformate
JPEG, PNG, WebP
JPEG ist der Standard; PNG und WebP sind über den Parameter output_format verfügbar.
Endpunkte
Alle MOSS Image-API-Endpunkte
2 MOSS Image-Endpunkte jetzt auf WaveSpeedAI verfügbar – wählen Sie die Variante, die zu Ihrem Workflow passt.
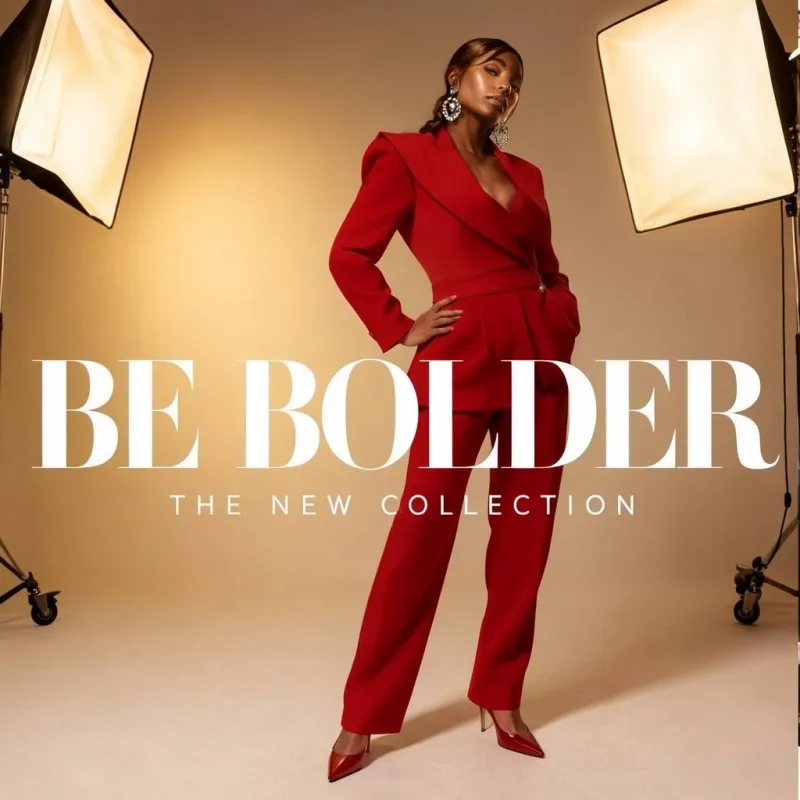
Moss Image Text To Image Lora
MOSS Image Text-to-Image LoRA generates images from long text prompts with up to 3 custom LoRAs, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
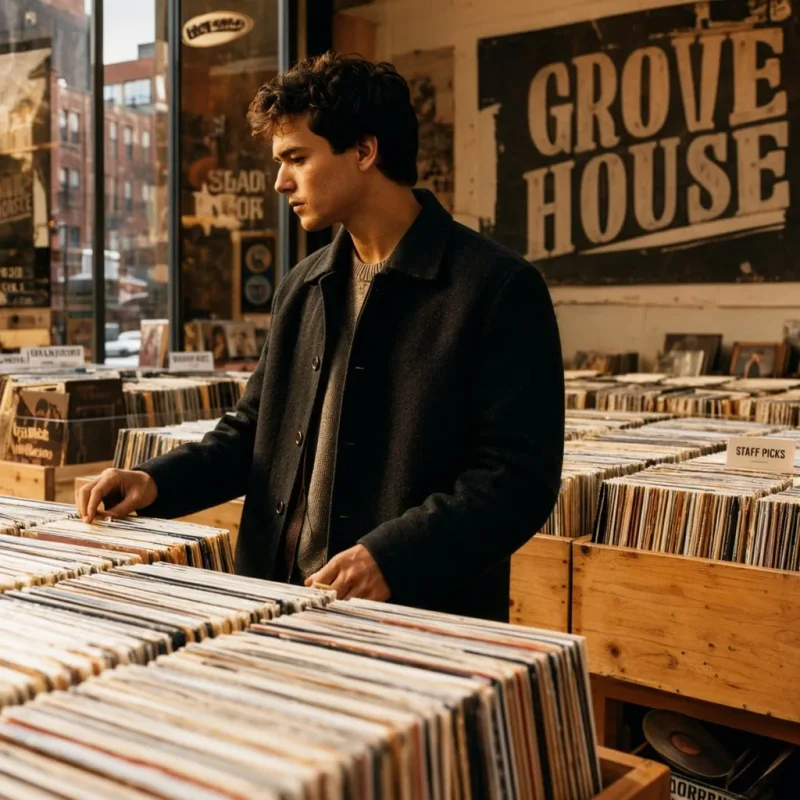
Moss Image Text To Image
MOSS Image Text-to-Image generates images from long text prompts, with sharp Chinese and English text rendering, 1K, 1.5K or 2K output and flexible aspect ratios. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Beispiele
MOSS Image in Aktion
Echte Ausgaben der MOSS Image-API. Fahren Sie über ein Video für eine Vorschau und klicken Sie, um den Viewer in voller Größe zu öffnen.
Anleitung
So verwenden Sie die MOSS Image-API
Vier Schritte von der Registrierung bis zur fertigen Generierung. Vollständige Beispiele in Python, Node.js und cURL finden Sie unten im Abschnitt „API“.
- 01
API-Schlüssel holen
Registrieren Sie ein WaveSpeedAI-Konto und kopieren Sie Ihren API-Schlüssel aus dem Dashboard. Neue Konten erhalten kostenlose Start-Credits – genug, um den Playground einige Dutzend Mal zu nutzen, bevor die Abrechnung beginnt.
- 02
Prediction senden
Senden Sie Ihre Eingabe als JSON per POST an https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image. Der Endpunkt gibt sofort eine Prediction-ID zurück – Generierungen laufen asynchron, sodass Sie während der Inferenz keine Verbindung offen halten.
- 03
Auf Abschluss prüfen
GET https://api.wavespeed.ai/api/v3/predictions/{request_id}/result. Geben Sie bei „completed“ die Ausgaben zurück; brechen Sie bei „failed“, „cancelled“, „timeout“ oder „deleted“ mit einem Fehler ab; fragen Sie bei allen anderen Status weiter ab.
- 04
Ausgabe-URL lesen
Sobald der Status „completed“ ist, lesen Sie die URL aus data.outputs[0]. Die URL verweist auf Ihre generierten Medien im WaveSpeedAI-CDN – Bild, Video, Audio oder 3D-Datei, je nach aufgerufener Variante von MOSS Image.
Anwendungsfälle
Was Sie mit MOSS Image bauen können
Gängige Workflows, für die Entwickler und Kreative die MOSS Image-API nutzen.
Lange, detaillierte Prompts
wavespeed-ai/moss-image/text-to-image ist für Prompts gebaut, die eine ganze Szene im Detail beschreiben: Motiv, Umgebung, Licht, Komposition und Stil in einem Absatz.
Poster und Cover mit chinesischem oder englischem Text
Das Modell rendert chinesischen und englischen Text im Bild. Das eignet sich für Poster, Buch- und Albumcover, Schilder-Mockups und Social-Cards, bei denen die Worte Teil des Bildes sind.
Eigene Stile und Figuren mit LoRA
wavespeed-ai/moss-image/text-to-image-lora wendet bis zu drei LoRAs gleichzeitig an, jede mit eigener Skalierung – für einen Hausstil, eine wiederkehrende Figur oder einen Produktlook.
Große Bilder für Druck und Displays
Die Stufe 2k erzeugt in einem Durchgang etwa 4 Megapixel, und die Stufe 1.5k liegt zwischen ihr und 1k – ein größeres Bild bei geringeren Kosten.
Wiederholbare Läufe mit einem Seed
Setzen Sie den Seed, um ein Ergebnis zu wiederholen und dabei nur den Prompt oder die LoRA-Skalierung zu ändern. Bei -1 erhalten Sie jedes Mal eine neue Variation.
Tipps
Tipps zum Prompting von MOSS Image
Praktische Ratschläge für bessere Ausgaben von MOSS Image – abgeleitet aus Mustern, die bei Bild-Modellen in Produktions-Pipelines funktionieren.
- 01
Schreiben Sie die ganze Szene in einen Absatz
MOSS Image kommt gut mit langen Prompts zurecht. Beschreiben Sie Motiv, Umgebung, Licht, Komposition und Stil in einem Absatz statt in einer Stichwortliste.
- 02
Setzen Sie den genauen Wortlaut in Anführungszeichen
Setzen Sie bei Text im Bild die gewünschten Worte in Anführungszeichen und sagen Sie, wohin sie gehören, etwa eine Schlagzeile oben oder eine kleine Zeile unter dem Logo. Chinesisch und Englisch werden beide gerendert.
- 03
Erst die Stufe wählen, dann das Verhältnis
Nutzen Sie 1k zum Ausprobieren, 1.5k für die meisten Lieferergebnisse und 2k für große Drucke, und wählen Sie dann das Seitenverhältnis. Die Stufe legt die Gesamtpixel fest, das Verhältnis die Form.
- 04
LoRAs über die Skalierung abstimmen
Beginnen Sie am Endpunkt text-to-image-lora mit jeder LoRA bei Skalierung 1 und passen Sie in kleinen Schritten an; bei mehreren LoRAs senken Sie jede Skalierung etwas, damit sie sich nicht gegenseitig stören.
Preise
MOSS Image-API-Preise
Die Abrechnung erfolgt pro Ausgabe. Der Endpreis richtet sich nach den Parametern, die Sie im Playground jeder Variante setzen (Auflösung, Dauer, Anzahl der Ausgaben, Referenzen).
| Endpunkt | Typ | Startpreis |
|---|---|---|
| wavespeed-ai/ | text-to-image | $0.025 |
| wavespeed-ai/ | text-to-image | $0.02 |
API
Die MOSS Image-API aufrufen
Holen Sie sich unter wavespeed.ai/accesskey einen API-Schlüssel und senden Sie dann eine Prediction per REST. Der Playground erzeugt einfügefertige Beispiele für jede Kombination von Eingaben.
POSThttps://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "1:1",
    "resolution": "1k",
    "output_format": "jpeg"
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "1:1",
"resolution": "1k",
"output_format": "jpeg"
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)Vergleich
MOSS Image im Vergleich zu Alternativen
Wann Sie MOSS Image ähnlichen Modellen auf WaveSpeedAI vorziehen sollten.
MOSS Image vs. Qwen-Image
Qwen-Image unterstützt ebenfalls chinesischen und englischen Text und bietet in seiner Familie zusätzlich Bildbearbeitung, Mehrbildbearbeitung und ein Kamerawinkel-System. MOSS Image ist reines Text-to-Image, mit einer LoRA-Variante und den Stufen 1.5K und 2K.
MOSS Image vs. FLUX.2 [klein]
FLUX.2 [klein] bietet Generierungs- und Bearbeitungsmodelle mit 4B und 9B sowie LoRA-Unterstützung. MOSS Image konzentriert sich auf lange Prompts und das Rendern von chinesischem und englischem Text, mit Endpunkten für Generierung und LoRA, aber ohne Bearbeitungsendpunkt.
MOSS Image vs. Seedream 5
Seedream 5 Pro bietet interaktive Präzisionsbearbeitung, Ebenentrennung und Fusion mehrerer Bilder. MOSS Image bearbeitet keine vorhandenen Bilder, sondern generiert aus einem Prompt und optionalen LoRAs.
FAQ
MOSS Image API — Häufig gestellte Fragen
Preise, Lizenz, Integration – häufige Fragen zur Nutzung von MOSS Image auf WaveSpeedAI.
Was ist MOSS Image?
MOSS Image ist ein Text-to-Image-Modell mit offenen Gewichten von OpenMOSS. Auf WaveSpeedAI läuft es hinter einer REST-API als zwei Endpunkte: text-to-image und text-to-image-lora.
Bearbeitet MOSS Image Bilder oder nimmt es ein Referenzbild entgegen?
Nein. Die aktiven Endpunkte generieren Bilder aus einem Text-Prompt, und der LoRA-Endpunkt ergänzt bis zu drei LoRAs. Zum Bearbeiten nutzen Sie ein Bearbeitungsmodell wie Seedream 5 oder Qwen-Image.
Wie nutze ich LoRAs mit MOSS Image?
Senden Sie den Parameter loras an den Endpunkt text-to-image-lora: eine Liste mit bis zu drei Einträgen, jeweils mit dem LoRA-Pfad (einer URL) und einer Skalierung zwischen 0 und 4.
Welche Auflösungen und Seitenverhältnisse unterstützt MOSS Image?
Drei Auflösungsstufen (1k, 1.5k, 2k, etwa 1, 2,4 und 4 Megapixel) und 15 Seitenverhältnisse von 1:3 bis 3:1, darunter 9:16, 16:9, 9:21 und 21:9.
Was ist die MOSS Image-API?
MOSS Image ist ein OpenMOSS-Modell für Bildgenerierung, das auf WaveSpeedAI als REST-API bereitgestellt wird. OpenMOSS MOSS Image – ein Text-to-Image-Modell mit offenen Gewichten für lange, detaillierte Prompts, mit scharf gerendertem chinesischem und englischem Text im Bild, Ausgabe in 1K, 1.5K oder 2K, 15 Seitenverhältnissen von 1:3 bis 3:1 und einer LoRA-Variante, die bis zu drei eigene LoRAs aufnimmt. Sie können es programmatisch aufrufen oder im oben verlinkten Playground ausprobieren.
Wie rufe ich die MOSS Image-API auf?
Registrieren Sie ein WaveSpeedAI-Konto, kopieren Sie Ihren API-Schlüssel von /accesskey und senden Sie dann per POST an https://api.wavespeed.ai/api/v3/wavespeed-ai/moss-image/text-to-image Ihre Eingabe als JSON. Der Endpunkt gibt eine Prediction-ID zurück. Fragen Sie den Ergebnis-Endpunkt etwa alle 2 Sekunden ab, verlängern Sie das Intervall bei lang laufenden Aufgaben und hören Sie bei jedem Endstatus auf. Produktionsnahe Beispiele in Python / Node.js / cURL finden Sie oben.
Was kostet die MOSS Image-API?
MOSS Image beginnt bei $0.02 pro Aufruf. Die genauen Kosten richten sich nach den Parametern, die Sie setzen (Auflösung, Dauer, Anzahl der Ausgaben, Referenzen). Die Live-Kostenvorschau neben der Schaltfläche „Generieren“ im Playground zeigt den genauen Preis für Ihre aktuelle Eingabe.
Welche Varianten von MOSS Image sind verfügbar?
WaveSpeedAI stellt 2 aktive MOSS Image-Endpunkte bereit: wavespeed-ai/moss-image/text-to-image-lora, wavespeed-ai/moss-image/text-to-image. Jede Variante hat eine eigene Playground-Seite und eigene Preise.
Kann ich die Ausgaben von MOSS Image kommerziell nutzen?
Die kommerziellen Nutzungsrechte richten sich nach der Modelllizenz von OpenMOSS. Die meisten Modelle von OpenMOSS erlauben die kommerzielle Nutzung der Ausgaben; die konkrete Lizenzzusammenfassung finden Sie auf der Playground-Seite des jeweiligen Modells, die Bedingungen auf Plattformebene in den Nutzungsbedingungen von WaveSpeedAI.
Warum MOSS Image auf WaveSpeedAI nutzen statt direkt?
Ein API-Schlüssel und ein Abrechnungskonto für MOSS Image UND über 1.000 weitere KI-Modelle anderer Anbieter. Keine SDK-Einrichtung pro Anbieter, keine separaten Rate Limits, kein Neuschreiben von Integrationscode pro Anbieter. Die Preise liegen in der Regel auf dem Niveau der direkten API von OpenMOSS oder darunter.
Anbieter
Über OpenMOSS
Das Team hinter MOSS Image und der übrigen Modellpalette von OpenMOSS auf WaveSpeedAI.
OpenMOSS ist das Open-Source-Team hinter der MOSS-Modellfamilie. MOSS Image wird mit offenen Gewichten unter der Apache-2.0-Lizenz veröffentlicht und generiert Bilder aus langen Prompts, mit Rendering von chinesischem und englischem Text, Ausgabe bis 2K und LoRA-Unterstützung. WaveSpeedAI hostet es hinter einer REST-API mit einem Endpunkt text-to-image und einem Endpunkt text-to-image-lora.
Starten Sie mit MOSS Image auf WaveSpeedAI
Kostenlose Start-Credits bei der Registrierung. Ein API-Schlüssel für über 1.000 KI-Modelle von OpenMOSS und allen anderen Anbietern.