
So verwenden Sie claw-code mit WaveSpeed AI-Modellen über die API
Erfahren Sie, wie Sie Bild- und Videogenerierungsmodelle in einen agentenbasierten claw-code-Workflow über eine einheitliche Modell-API integrieren.
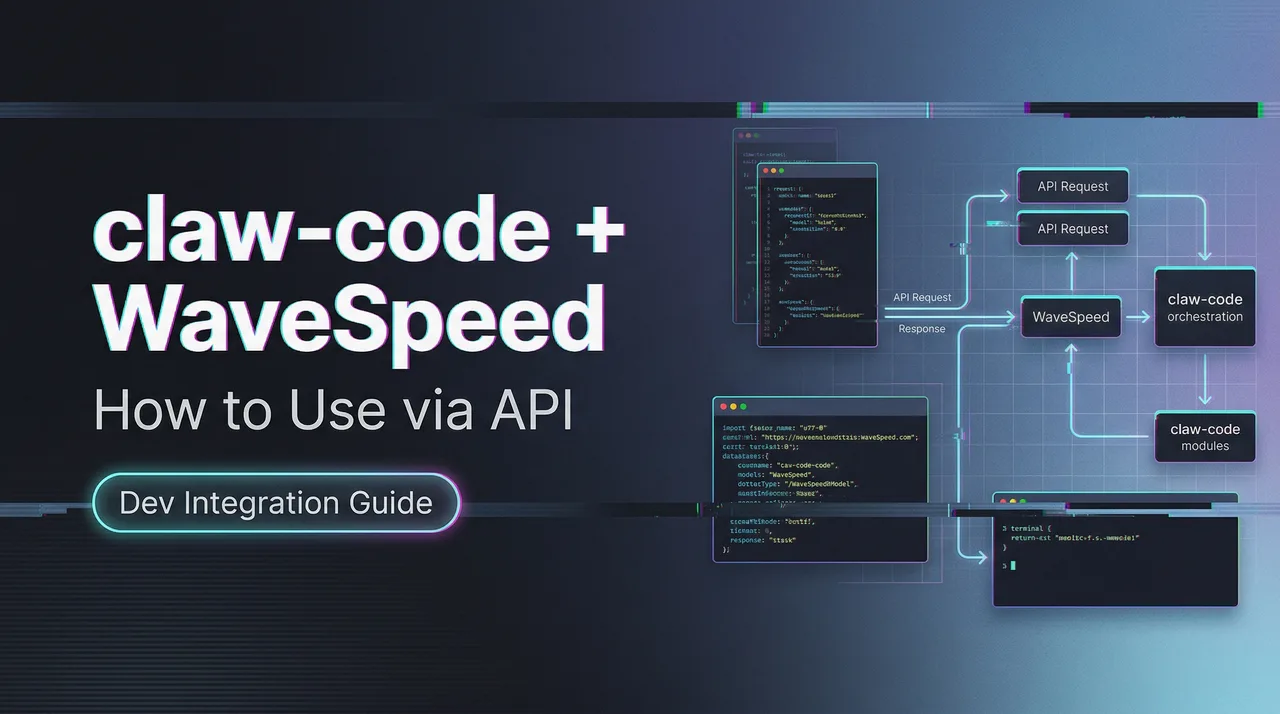
Stell dir vor: Dein KI-Agent denkt nicht nur — er erschafft.
Er denkt Schritt für Schritt, ruft dann nahtlos ein leistungsstarkes Bildgenerierungsmodell auf, um ein beeindruckendes Visual zu erstellen, wechselt zu einem Videomodell für Bewegung, analysiert die Ergebnisse und setzt den Workflow fort — alles ohne dass du einen Finger rührst oder eine einzige Zeile Code umschreiben musst.
Genau das ist jetzt mit WaveSpeed AI Modellen und claw-code möglich — von Grund auf neu in Python in einem Clean-Room-Stil entwickelt und von einem koreanischen Entwickler direkt nach dem Claude Code Leak als Open Source veröffentlicht.
In diesem Leitfaden erfährst du, wie du diese leistungsstarke Kombination nutzen kannst, um Agenten zu bauen, die nicht nur chatten… sondern erstellen, iterieren und echte Multimedia-Ergebnisse innerhalb einer einzigen intelligenten Schleife liefern.
Egal ob du Ersteller, Entwickler oder KI-Tüftler bist, der es satt hat, zwischen Tools zu wechseln — das ist dein Abkürzung zu wirklich agentischen Multimedia-Workflows.
Bereit, deine KI-Agenten visuell leistungsfähig zu machen? Lass uns loslegen.
Voraussetzungen: Was du vor dem Start brauchst
Bevor du eine einzige Zeile Konfiguration anfasst, kläre diese zwei Dinge. Wer einen davon überspringt, verliert Stunden mit kryptischen Fehlermeldungen.
claw-code-Setup und Umgebung
claw-code läuft auf Python 3.11+. Stand März 2026 ist der Hauptzweig Python-first (72,9 % Rust, 27,1 % Python laut der eigenen Sprachaufschlüsselung des Projekts, aber der CLI-Einstieg, den du täglich verwenden wirst, ist Python). Installiere es aus dem offiziellen Repository:
git clone https://github.com/instructkr/claw-code.git
cd claw-code
pip install -e .
Du solltest außerdem deinen Anthropic-Schlüssel als Umgebungsvariable setzen — claw-code unterstützt sowohl ANTHROPIC_API_KEY als auch ANTHROPIC_AUTH_TOKEN, passend zu den Anthropic API-Authentifizierungsmustern aus der offiziellen Dokumentation.
export ANTHROPIC_API_KEY="your-key-here"Erwähnenswert: Der Rust-Port ist noch in Arbeit auf einem separaten Zweig. Für Video/Bild-Workflows ist das Python-Harness stabil genug. Die Rust-Migration zielt auf leistungskritische Laufzeitpfade ab — etwas, das du für diesen Anwendungsfall gerade nicht brauchst.
API-Schlüssel und Zugang zum Modellanbieter
Neue Konten erhalten 1 $ in kostenlosen Testguthaben — genug, um einige Bildgenerierungen zu testen und zu bestätigen, dass deine Pipeline von Anfang bis Ende funktioniert, bevor du echtes Geld ausgibst.
WaveSpeed’s Modellkatalog umfasst Stand März 2026 über 700 Modelle für Bild-, Video-, Audio- und 3D-Generierung, alle hinter einem einzigen vereinheitlichten API-Schlüssel. Das ist sehr wichtig, sobald du anfängst, Multi-Modell-Agenten-Workflows zu erstellen — du möchtest nicht fünf verschiedene Auth-Header verwalten.
Externe Modell-APIs in einem claw-code-Workflow verbinden
Hier wird es wirklich interessant. claw-code ist nicht nur ein Coding-Assistent — es implementiert eine vollständige Tool-Ausführungsschicht mit 19 berechtigungsgesteuerten Tools und einem Plugin-Modell, das du erweitern kannst. Das macht die Einbindung einer externen API wie der von WaveSpeed tatsächlich handhabbar.
Wie claw-code externe Tool-Aufrufe verarbeitet
claw-code’s Tool-System arbeitet über JSON-Schema-Definitionen, die in der Rust-Schicht generiert werden, wobei Python die Agenten-Orchestrierungsseite übernimmt. Jedes Tool hat seine eigenen Zugriffskontrollen, die in permissions.py definiert sind. Wenn du ein benutzerdefiniertes Tool hinzufügst, kann der Agent autonom entscheiden, wann er es basierend auf dem Aufgabenkontext aufruft — genau das, was du willst, wenn eine Eingabeaufforderung „Schreib mir ein Skript und generiere ein passendes Thumbnail” sowohl eine Textaufgabe als auch einen Bildgenerierungsaufruf auslösen soll.
Die in den Anthropic-API-Client von claw-code eingebaute Wiederholungslogik verwendet exponentielles Backoff für 408-, 429- und 5xx-Antworten. Dieses Backoff-Muster übernimmst du nur für das Abfragen der Ergebnisse bei WaveSpeed; die Anfrage zum Einreichen der Aufgabe wird genau einmal gesendet und nie automatisch wiederholt (siehe unten).
Eine Modell-API als Tool im Harness hinzufügen
Erstelle eine Datei namens wavespeed_tool.py im Tools-Verzeichnis von claw-code:
import httpx
import os
import time

WAVESPEED_API_KEY = os.environ.get("WAVESPEED_API_KEY")
BASE_URL = "https://api.wavespeed.ai/api/v3"

TOOL_SCHEMA = {
    "name": "generate_image",
    "description": "Generate an image using WaveSpeed AI given a text prompt.",
    "input_schema": {
        "type": "object",
        "properties": {
            "prompt": {"type": "string", "description": "Image generation prompt"},
            "model": {"type": "string", "default": "wavespeed-ai/flux-dev"},
        },
        "required": ["prompt"],
    },
}

def generate_image(prompt: str, model: str = "wavespeed-ai/flux-dev") -> dict:
    headers = {"Authorization": f"Bearer {WAVESPEED_API_KEY}"}
    payload = {"inputs": {"prompt": prompt}, "enable_safety_checker": True}
    response = httpx.post(f"{BASE_URL}/{model}", json=payload, headers=headers)
    response.raise_for_status()
    return response.json()
Registriere dies in claw-code’s Tool-Registry, und der Agent kann nun generate_image in jeder Sitzung aufrufen, in der Bildgenerierung im Umfang liegt.
Bild- und Videogenerierungsmodelle aus einem Agenten-Workflow heraus aufrufen
Das ist der Abschnitt, den ich beim ersten Einrichten immer finden wollte — und nicht konnte. Hier ist er, so klar wie ich ihn schreiben kann.
REST-API-Aufrufmuster
WaveSpeed verwendet ein einheitliches REST-Muster für alle Modelle. Der grundlegende Aufruf sieht so aus (mit WAN 2.7 Text-to-Video als Beispiel):
import httpx

def call_wavespeed(model_id: str, inputs: dict) -> dict:
    headers = {
        "Authorization": f"Bearer {os.environ['WAVESPEED_API_KEY']}",
        "Content-Type": "application/json",
    }
    payload = {"inputs": inputs}
    response = httpx.post(
        f"https://api.wavespeed.ai/api/v3/{model_id}",
        json=payload,
        headers=headers,
        timeout=30,
    )
    response.raise_for_status()
    return response.json()
Bei Bildern (wie Flux Dev oder Seedream v4.5) kommt die Antwort synchron mit einer Ausgabe-URL zurück. Bei Videomodellen — WAN 2.7, Kling 2.6, Hailuo 2.3 — ist es asynchron, was bedeutet, dass du pollen musst.
Asynchrone Generierung und Polling behandeln
Die Videogenerierung auf WaveSpeed dauert je nach Modell und Länge typischerweise 30 Sekunden bis einige Minuten. Die API gibt sofort eine request_id zurück; du pollst einen Status-Endpunkt, bis der Job abgeschlossen ist.
import os
import time
import httpx

TRANSIENT = {429, 500, 502, 503, 504}


def poll_until_done(request_id: str) -> dict:
    headers = {"Authorization": f"Bearer {os.environ['WAVESPEED_API_KEY']}"}
    url = f"https://api.wavespeed.ai/api/v3/predictions/{request_id}/result"
    failures = 0

    while True:
        try:
            resp = httpx.get(url, headers=headers, timeout=30)
        except httpx.TransportError:  # network error or per-request timeout
            resp = None

        if resp is None or resp.status_code in TRANSIENT:
            failures += 1
            retry_after = resp.headers.get("Retry-After", "") if resp is not None else ""
            time.sleep(int(retry_after) if retry_after.isdigit() else min(2 ** failures, 60))
            continue
        if resp.status_code != 200:
            raise RuntimeError(f"Task {request_id}: unexpected HTTP {resp.status_code}")
        failures = 0

        data = resp.json()["data"]
        status = data.get("status")
        if status == "completed":
            return data
        if status in {"failed", "cancelled", "timeout", "deleted"}:
            raise RuntimeError(f"Task {request_id} {status}: {data.get('error')}")

        time.sleep(2)  # poll every 2 seconds
Innerhalb einer claw-code-Agentenschleife würdest du dieses Polling in die Ausführungsfunktion des Tools einwickeln, damit der Agent auf das Ergebnis wartet, bevor er mit dem nächsten Schritt fortfährt.
Rate Limits und Fallbacks in einem agentischen Kontext verwalten
Rate Limits innerhalb einer Agentenschleife sind unübersichtlicher als in einem einfachen Skript — der Agent könnte mehrere Tool-Aufrufe in schneller Folge auslösen, wenn die Aufgabe parallelisierbar ist. Hier ist das Muster, das ich verwende: genau einmal einreichen, nur die Abfrage-Anfragen wiederholen und das Fallback-Modell nur nutzen, wenn das Einreichen eindeutig abgelehnt wurde:
import httpx

FALLBACK_MODELS = {
    "wavespeed-ai/wan-2.7-t2v": "wavespeed-ai/wan-2.6-t2v",
}


def submit_once(model_id: str, inputs: dict) -> str:
    """Send the submit POST exactly once and return the task id."""
    try:
        return call_wavespeed(model_id, inputs)["data"]["id"]
    except httpx.HTTPStatusError as e:
        if e.response.status_code < 500:
            raise  # 4xx: the request was rejected, no task was created
        unknown = e
    except httpx.HTTPError as e:  # timeout, dropped connection, no response
        unknown = e
    raise RuntimeError(
        f"Submit to {model_id} has an unknown outcome ({unknown!r}). A task may "
        "exist and be billed: check History in the WaveSpeed dashboard before resubmitting."
    ) from unknown


def generate(model_id: str, inputs: dict) -> dict:
    try:
        task_id = submit_once(model_id, inputs)
    except httpx.HTTPStatusError as e:
        fallback = FALLBACK_MODELS.get(model_id)
        # Only a 429 is a clear "not accepted" signal; try the fallback once.
        if e.response.status_code != 429 or fallback is None:
            raise
        task_id = submit_once(fallback, inputs)
    return poll_until_done(task_id)
Die wichtigste Regel: Wiederhole das einreichende POST nie automatisch. Schlägt es mit einem 5xx-Fehler fehl oder läuft in ein Timeout, weißt du nicht, ob die Aufgabe erstellt (und abgerechnet) wurde. Prüfe daher den Verlauf (History) in deinem WaveSpeed-Dashboard, bevor du erneut einreichst. Nur bei einer eindeutigen Ablehnung wie 429 ist ein weiterer Schritt sicher, weil keine Aufgabe erstellt wurde. Die Abfrage per GET kann bedenkenlos wiederholt werden: Sie fängt vorübergehende Fehler ab und läuft weiter, bis die Aufgabe einen Endstatus erreicht.
Die WaveSpeed API-Dokumentation beschreibt Rate-Limit-Stufen nach Kontoebene — Silver-Konten (einmalige Aufladung von 100 $) erhalten deutlich höhere Parallelitätslimits als die Standard-Bronze-Stufe, was wichtig wird, sobald du Agenten ausführst, die mehrere Generierungsanfragen pro Sitzung auslösen.
Multi-Modell-Muster: Warum aggregierter Zugang in agentischen Pipelines wichtig ist
Ich möchte kurz darauf eingehen, warum diese Architektur den Einrichtungsaufwand wert ist — denn das ist nicht offensichtlich, bis man tatsächlich die Reibung gespürt hat, separate API-Konten für jedes Modell zu verwalten, das man testen möchte.
Modellwechsel ohne Workflow-Umschreibung
WaveSpeed’s einheitliche API bedeutet, dass du wavespeed-ai/flux-dev gegen wavespeed-ai/seedream-v4-5 mit einer einzigen Zeichenkettenänderung tauschen kannst. Kein neuer Auth-Flow, kein anderes Antwortschema zum Parsen, kein SDK-Wechsel. Für einen agentischen Workflow, bei dem du möchtest, dass der Agent das richtige Modell für die Aufgabe wählt (fotorealistisches Thumbnail vs. stilisierte Illustration vs. kurzer Videoclip), ist das wirklich nützlich — du kannst die Modell-ID als Variable übergeben und den Agenten darüber nachdenken lassen, welche passt.
Hier ist eine einfache Modellvergleichstabelle basierend auf den Generierungsspezifikationen von März 2026 aus WaveSpeed’s Katalog:
| Modell | Typ | Ausgabe | Am besten für |
|---|---|---|---|
| Flux Dev | Bild | Bis zu 4K | Fotorealistisch, schnell |
| Seedream v4.5 | Bild | Bis zu 4K | Künstlerisch, stilisiert |
| WAN 2.7 T2V | Video | 720p/1080p | Text-to-Video, kinematisch |
| Kling 2.6 Pro | Video | 720p | Bewegungssteuerung, Animation |
| Hailuo 2.3 Fast | Video | 720p | Geschwindigkeitsoptimiertes I2V |
Einheitliche Abrechnung und Schlüsselverwaltung
Das hat mich mehr überrascht, als ich erwartet hatte. Separate API-Schlüssel für Runway, Kling, FLUX und WAN zu verwalten — jeweils mit unterschiedlichen Abrechnungs-Dashboards, unterschiedlichem Rate-Limit-Verhalten, unterschiedlichen Fehlerformaten — ist eine erhebliche Betriebslast beim Erstellen agentischer Workflows. Ein Schlüssel, ein Abrechnungs-Dashboard und konsistente Fehlerschemata für alle Modelle ist eine echte Lebensqualitätsverbesserung, die sich darin zeigt, wie wartbar dein Agentencode im Laufe der Zeit bleibt.
Der OWASP Software Supply Chain Security Guide ist lesenswert, bevor du einen Drittanbieter-Agenten in der Produktion einsetzt — besonders relevant angesichts des Supply-Chain-Vorfalls, der npm-basierte Claude Code-Installationen im März 2026 betraf (claw-code selbst war nicht betroffen, aber das breitere Ökosystem erfordert Vorsicht).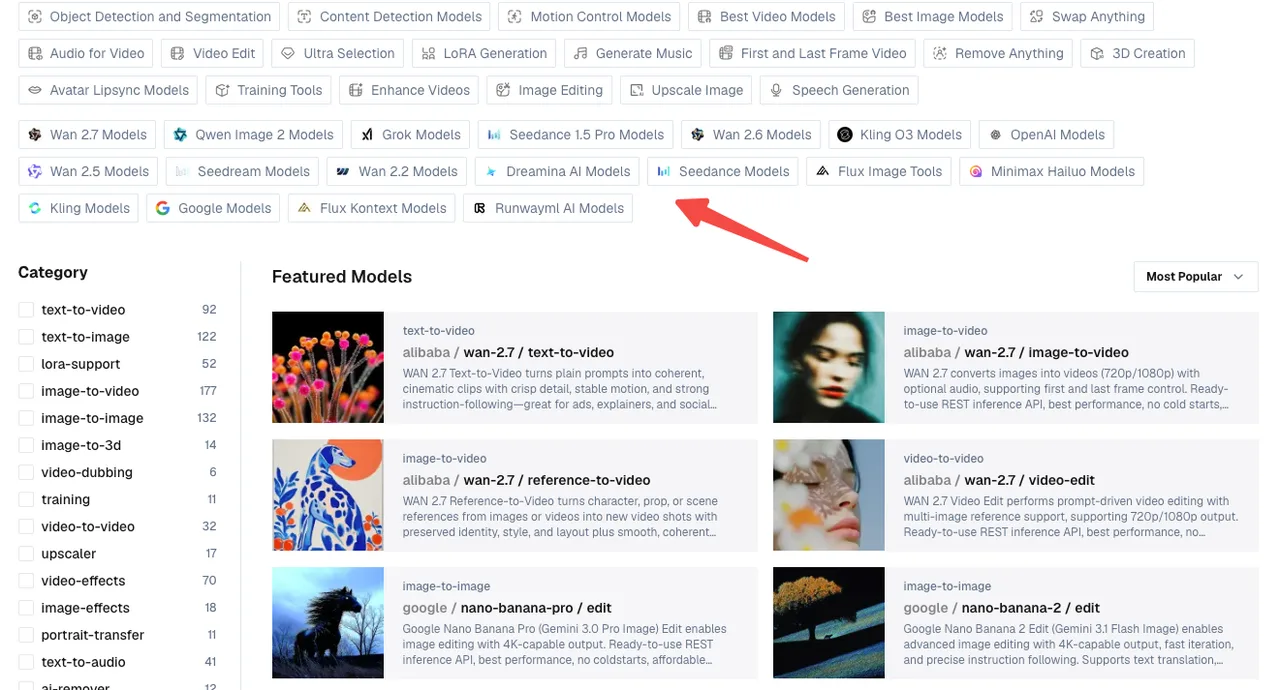
Einschränkungen und Dinge zum Überprüfen
Ich würde den nützlichsten Teil dieser Rezension weglassen, wenn ich die rauen Kanten überspringen würde.
Stabilitätsvorbehalte bei claw-code
Stand April 2026 ist claw-code nicht auf Feature-Parität mit Claude Code. Der Rust-Port ist noch in Arbeit. IDE-Integrationen gibt es nicht — das ist nur terminal. Multi-Agenten-Orchestrierung ist in der Architektur dokumentiert, wurde aber noch nicht in großem Maßstab battle-tested. Das Projekt hat 48k+ GitHub-Sterne und entwickelt sich schnell, aber „interessante Architektur” und „produktionsreif” sind wirklich unterschiedliche Maßstäbe.
Der rechtliche Status des Projekts ist ebenfalls ungeklärt. claw-code beansprucht den Clean-Room-Status als Verteidigung gegen den DMCA-Druck von Anthropic — es ist eine Neuentwicklung, keine Kopie des geleakten Quellcodes — aber diese Rechtsfrage ist nicht geklärt. Wenn du etwas für einen Kunden oder in großem Maßstab baust, berücksichtige diese Unsicherheit.
Was manuelle Tests erfordert
Bevor du diesem Workflow in der Produktion vertraust, solltest du manuell überprüfen:
- Polling-Timeout-Verhalten: Das 5-Sekunden-Polling-Intervall, das ich verwende, ist konservativ. Teste mit deinem tatsächlichen Videomodell und deiner Länge, um
max_waitanzupassen. - Tool-Registrierung: Die Tool-Registry von claw-code befindet sich in aktiver Entwicklung. Die genaue Registrierungs-API kann sich zwischen Commits verschieben — überprüfe das
CHANGELOGdes Repos, bevor du eine Version festlegst. - Berechtigungskontext: claw-code implementiert berechtigungsgesteuerte Tool-Ausführung. Bestätige, dass deine
generate_image- undgenerate_video-Tools die korrekte Zugriffsebene inpermissions.pyerhalten. - Antwortschemata-Änderungen: WaveSpeed aktualisiert gelegentlich Modellausgabe-Schemata. Füge eine Validierung rund um das Ausgabe-URL-Feld hinzu, anstatt die Struktur zu erwarten.
FAQ
F: Kann claw-code Bildgenerierungs-APIs nativ aufrufen?
Nicht von Haus aus — es gibt kein eingebautes WaveSpeed- oder Bildgenerierungstool in der Standardinstallation. Aber das Tool-System ist genau für diese Art von Erweiterung ausgelegt. Sobald du ein benutzerdefiniertes Tool mit dem korrekten JSON-Schema registrierst (wie oben gezeigt), kann der Agent es autonom in jeder Sitzung aufrufen.
F: Unterstützt claw-code asynchrone Tool-Aufrufe?
Das Python-Harness verarbeitet Tool-Ausführung synchron innerhalb der Agentenschleife. Für asynchrone Generierung (wie Videomodelle) ist das von mir empfohlene Muster: die initiale Anfrage abfeuern, die request_id erhalten, dann innerhalb der Ausführungsfunktion des Tools pollen, bis zur Fertigstellung, bevor zum Agenten zurückgekehrt wird. Das hält die Schlussfolgerung des Agenten linear und vermeidet Race Conditions im Sitzungszustand.
F: Ist dieser Workflow produktionsreif?
Ehrlich gesagt? Noch nicht, für die meisten Teams. claw-code entwickelt sich schnell, trägt aber rechtliche Unsicherheit und wurde nicht für agentische Nutzung im Produktionsmaßstab gehärtet. Die WaveSpeed API-Seite ist produktionsreif — 99,99 % Uptime-SLA, keine Cold Starts, sekundenweise Abrechnung — aber das claw-code-Harness, das es umhüllt, ist noch in einem frühen Stadium. Ich würde das momentan für interne Tools, Prototyping und Erkundung verwenden und für clientseitige Produktion erneut prüfen, sobald sich das Projekt stabilisiert hat.
Vorherige Beiträge:
- How to Set Up MaxClaw: Step-by-Step Beginner Guide (2026)
- MaxClaw Use Cases: 7 Ways to Put Your AI Agent to Work
- How to Use Seedance 2.0 via API: Async Jobs, Retries, and Result Handling
- Seedance 2.0 Quick Start on WaveSpeed: First Video in 10 Minutes
- Z-Image-Turbo Image-to-Image Guide: Strength Parameter Deep Dive
Verwandte Artikel
Einführung von AI Cinema Studio bei WaveSpeedAI: Kinoreife KI-Videoaufnahmen direkt inszenieren
Schnell generieren, in 4K liefern: KI-Video mit dem Ultimate Video Upscaler hochskalieren
WaveSpeedAI AI Chat: Bilder und Videos durch Chatten erstellen und bearbeiten
ByteDance Seedance 2.0 Mini jetzt auf WaveSpeedAI
Claude Fable 5 Fallback auf Opus 4.8 erklärt