Higgsfield API Alternative
Модели, которые разработчики ищут в Higgsfield API — Seedance 2.5 и 2.0, Kling 3.0 и O3, Wan 3.0, MiniMax H3 и Qwen Image 3.0 с открытыми весами — а также Seedream 5.0, Nano Banana 2 и Pro, GPT Image 2.5 и 2 по одному ключу API WaveSpeedAI. Оплата по факту использования: кредиты не сгорают, ни членства, ни подписки нет.
Рассматриваете Higgsfield API? Все конечные точки ниже уже работают на WaveSpeedAI, с playground, примерами и актуальной ценой за запуск. Пополните баланс один раз и тратьте кредиты, когда удобно — они не сгорают — на эти модели и более 1000 других моделей для изображений, видео, аудио, 3D и языковых задач.
Обзор
О модели Higgsfield API Alternative
Что можно вызывать в WaveSpeedAI, если вы рассматриваете Higgsfield API.
Модели, которые разработчики ищут в Higgsfield API — Seedance 2.5 и 2.0, Kling 3.0 и O3, Wan 3.0, MiniMax H3 и Qwen Image 3.0 с открытыми весами — а также Seedream 5.0, Nano Banana 2 и Pro, GPT Image 2.5 и 2 по одному ключу API WaveSpeedAI. Оплата по факту использования: кредиты не сгорают, ни членства, ни подписки нет.
Рассматриваете Higgsfield API? Все конечные точки ниже уже работают на WaveSpeedAI, с playground, примерами и актуальной ценой за запуск. Пополните баланс один раз и тратьте кредиты, когда удобно — они не сгорают — на эти модели и более 1000 других моделей для изображений, видео, аудио, 3D и языковых задач.
Ниже — 37 рабочих REST-эндпоинтов WaveSpeedAI для этих моделей, охватывающих сценарии: Text-To-Video, Image-To-Video, Image-Tools, Text-To-Image, Image-To-Image. У каждого есть свой playground, цены и примеры, и вызываются они одинаково: отправьте POST с JSON, получите id предсказания, затем опрашивайте результат или получите вебхук.
У них общий API-ключ, общий баланс и единая интеграция с остальными 1000+ моделей WaveSpeedAI — от текста в изображение и текста в видео до аудио, 3D, апскейлинга, редактирования и языковых моделей.
Эндпоинты
Все эндпоинты API WaveSpeedAI
Сейчас в WaveSpeedAI доступно эндпоинтов: 37 — выберите вариант под ваш сценарий.
Seedance 2.5 Text To Video Turbo
Seedance 2.5 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Text To Video
Seedance 2.5 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
Seedance 2.5 Image To Video Turbo
Seedance 2.5 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Image To Video
Seedance 2.5 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
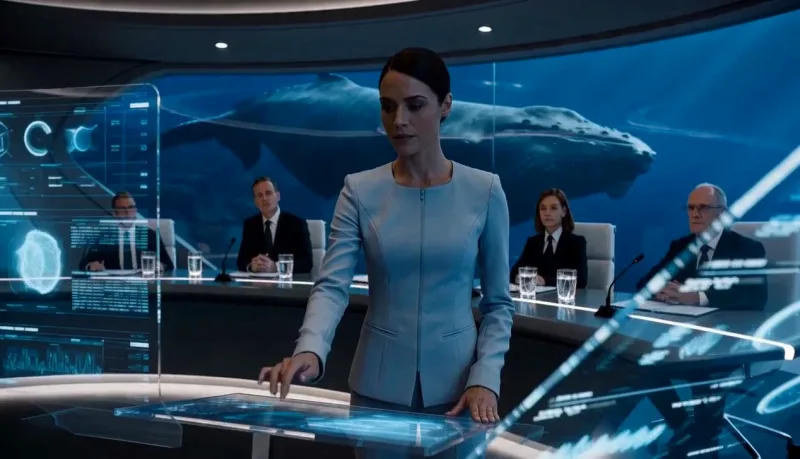
Seedance 2.0 Text To Video Turbo
Seedance 2.0 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
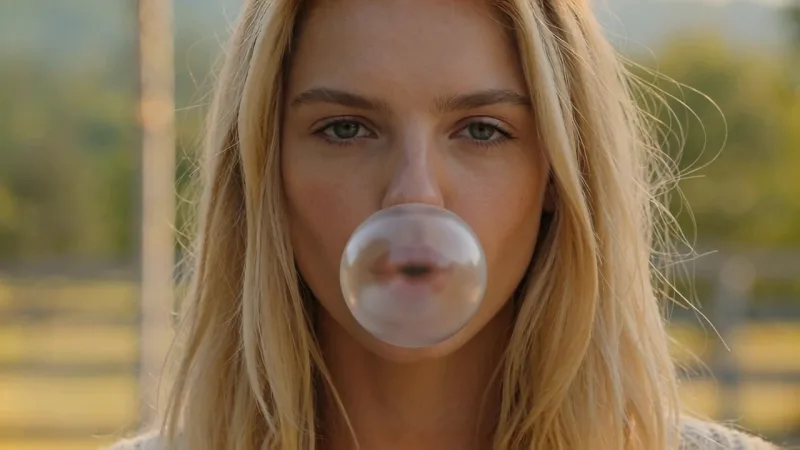
Seedance 2.0 Text To Video
Seedance 2.0 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
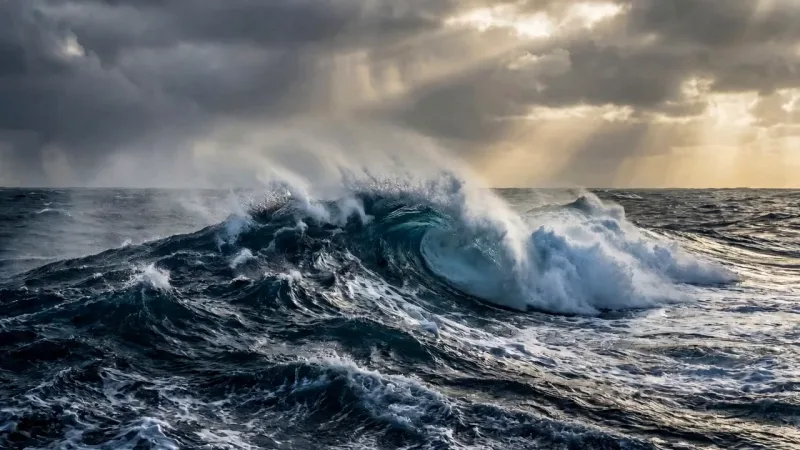
Seedance 2.0 Image To Video Turbo
Seedance 2.0 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
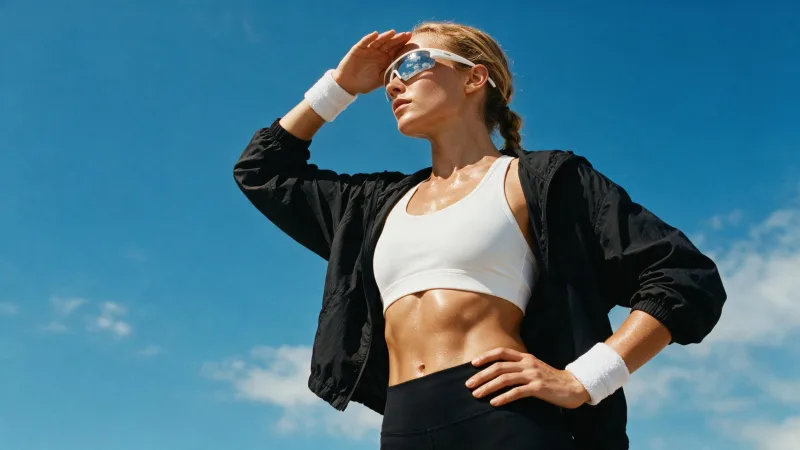
Seedance 2.0 Image To Video
Seedance 2.0 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Kling v3.0 Pro Text To Video
Kling 3.0 Pro delivers top-tier text-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling v3.0 Pro Image To Video
Kling 3.0 Pro delivers top-tier image-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling Video O3 Pro Text To Video
Kling Omni Video O3 is Kuaishou's advanced unified multi-modal video model with MVL (Multi-modal Visual Language) technology. Text-to-Video mode generates cinematic videos from text prompts with subject consistency, natural physics simulation, and precise semantic understanding. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
Kling Video O3 Pro Image To Video
Kling Omni Video O3 Image-to-Video transforms static images into dynamic cinematic videos using MVL (Multi-modal Visual Language) technology. Maintains subject consistency while adding natural motion, physics simulation, and seamless scene dynamics. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Text To Video
Wan 3.0 Text to Video generates cinematic videos from text prompts, with flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality video generation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Image To Video
Wan 3.0 Image to Video animates a first-frame image into a cinematic video, with optional last-frame guidance, flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality motion and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Text To Video Lora
MiniMax H3 Open Weights Text to Video with custom LoRA support generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Text To Video
MiniMax H3 Open Weights Text to Video generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video Lora
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro Layer Decomposition
Seedream V5.0 Pro Layer Decomposition separates a single image into a base image and transparent layers, enabling flexible compositing, image editing, asset extraction, and layered design workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro
Seedream V5.0 Pro Text to Image by ByteDance generates high-quality images from text prompts, with aspect ratio selection, strong prompt following, and 1K / 2K output tiers for flexible image creation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
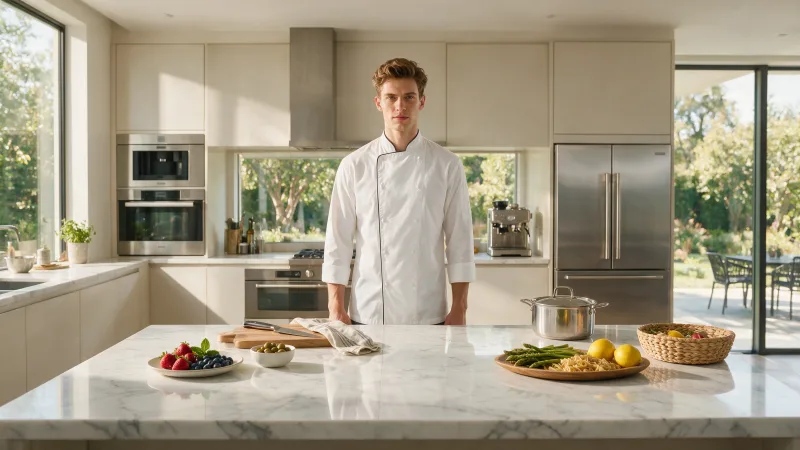
Seedream v5.0 Pro Edit
Seedream V5.0 Pro Edit by ByteDance edits and generates images from single-image or multi-reference inputs, supporting up to 10 reference images, aspect ratio selection, and 1K / 2K output tiers. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
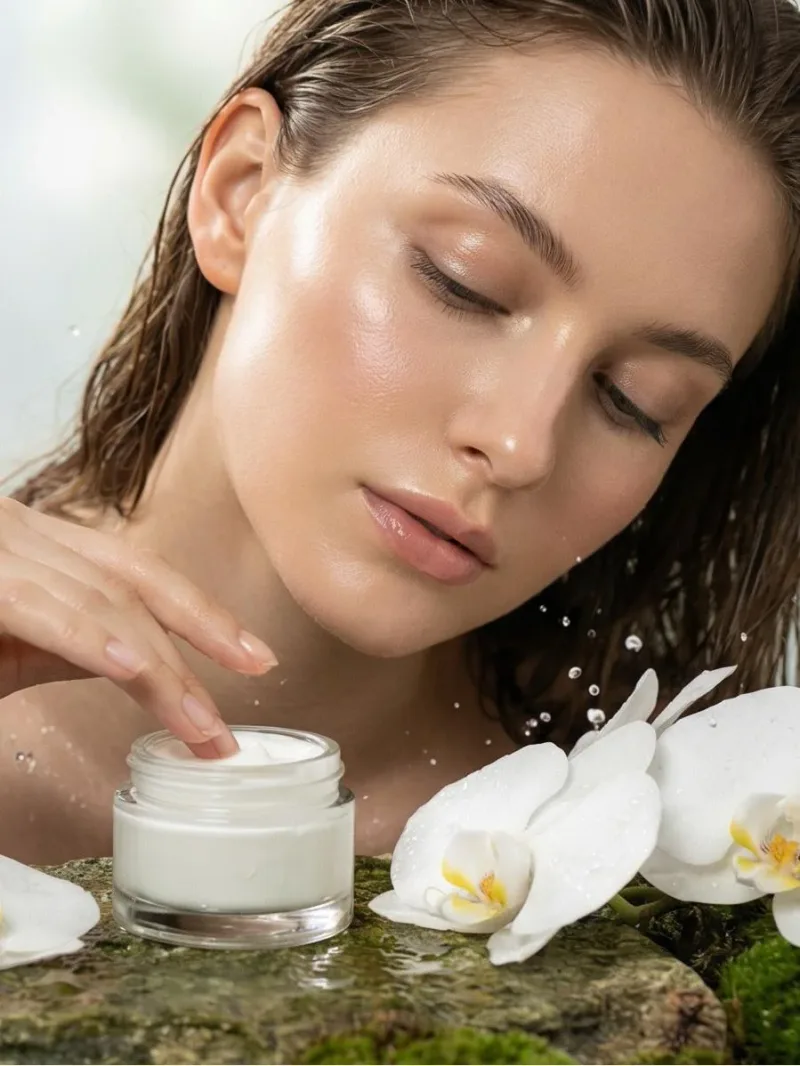
Nano Banana Pro Text To Image Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a next-generation text-to-image model capable of generating multiple high-quality images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Text To Image Ultra
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Text To Image
Google's Nano Banana pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res 4K image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
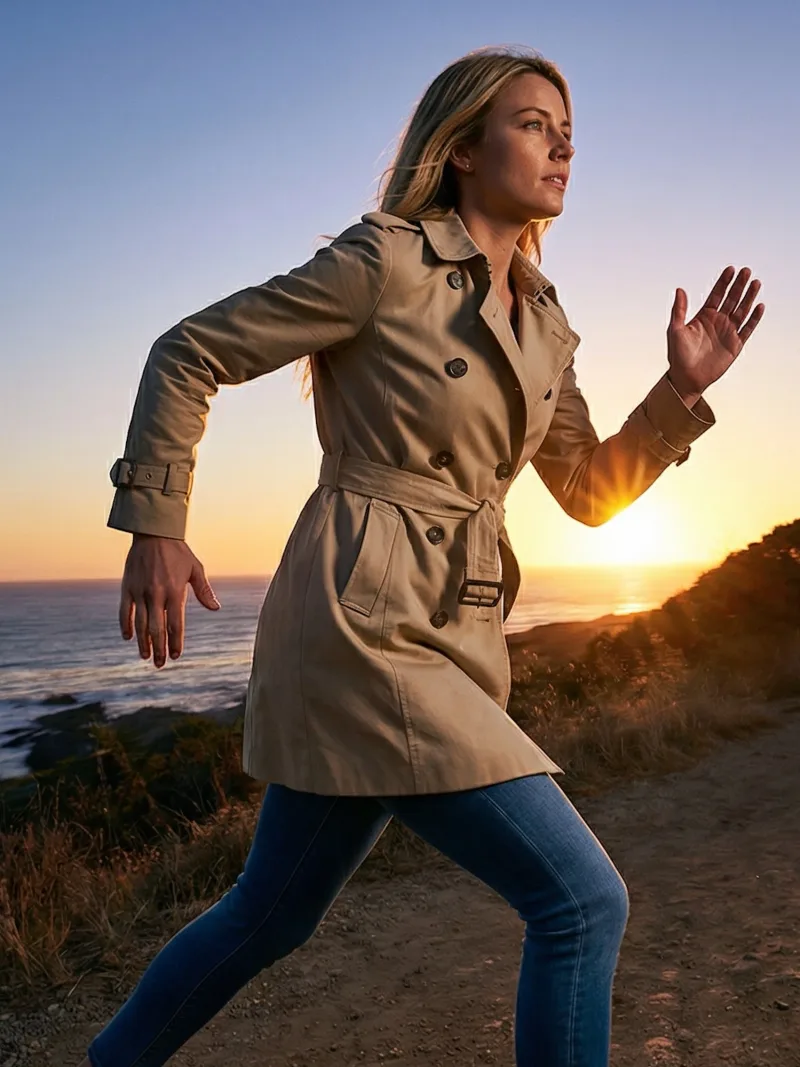
Nano Banana Pro Edit Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) Edit is a next-generation image editing model capable of generating multiple high-quality edited images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
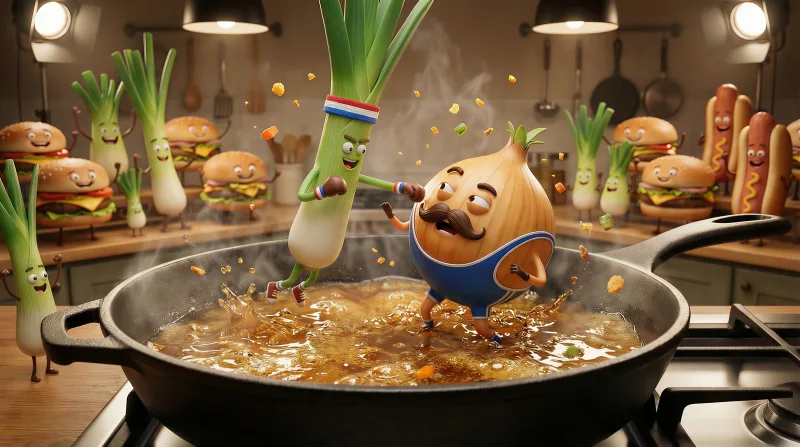
Nano Banana Pro Edit Ultra
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with highres output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
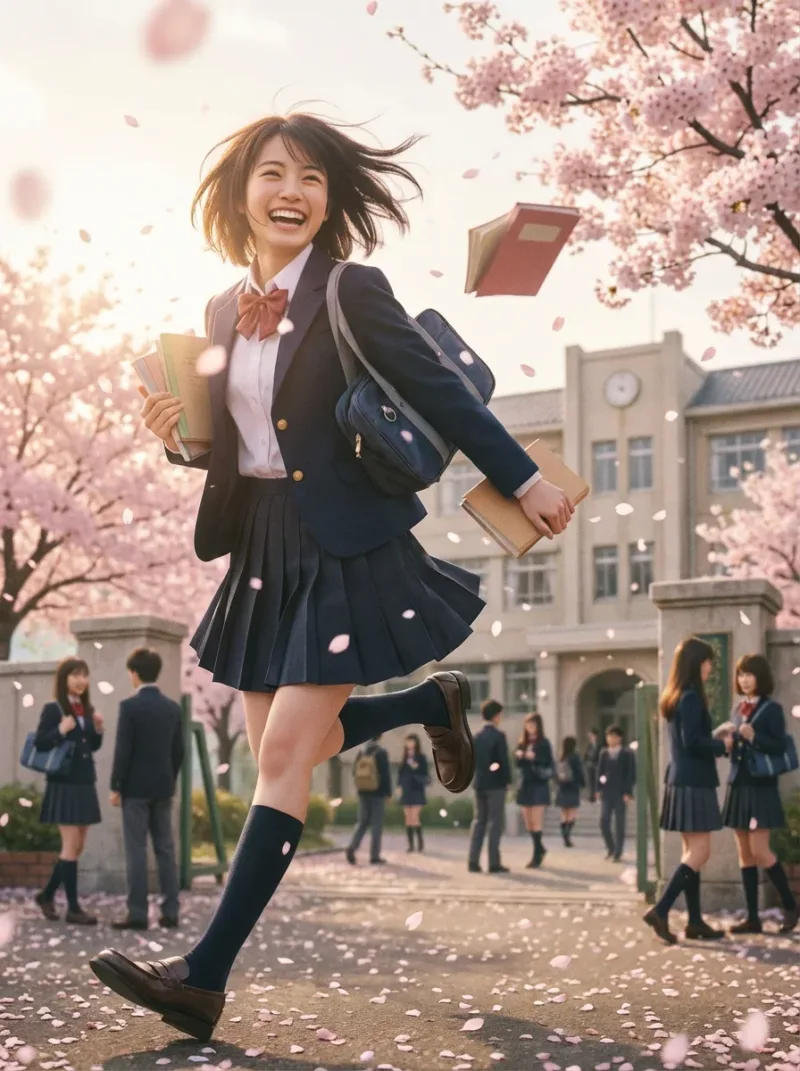
Nano Banana Pro Edit
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with 4K-capable output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
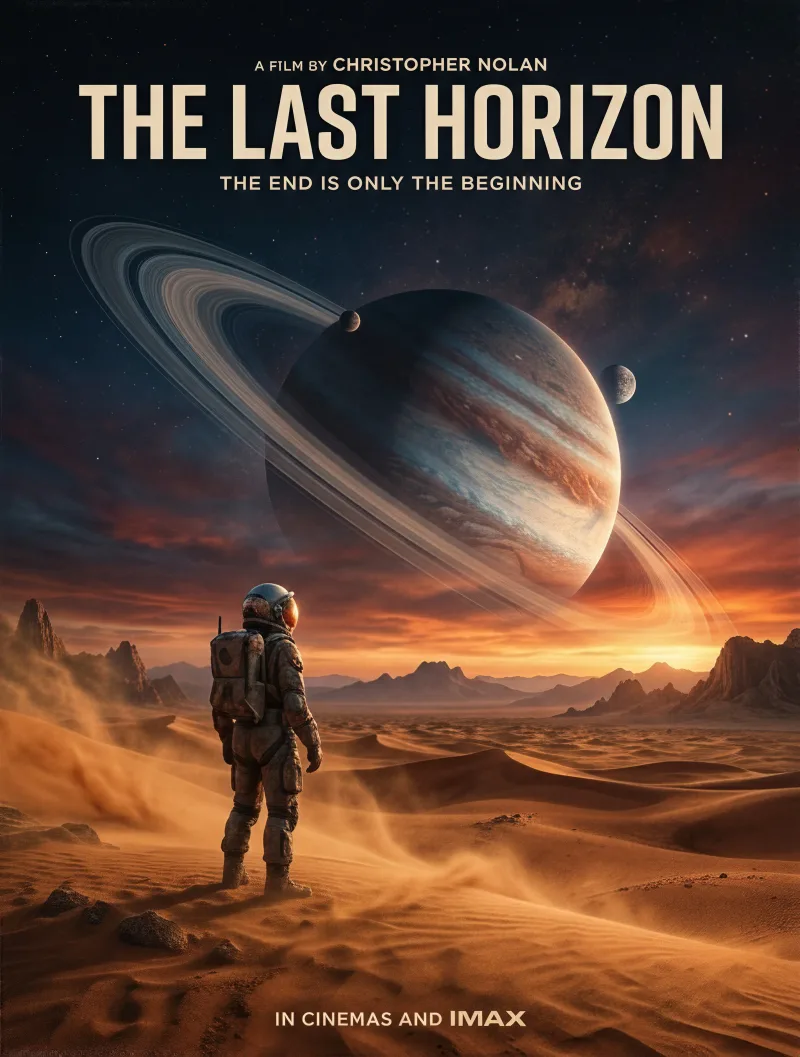
Nano Banana 2 Text To Image Fast
Google Nano Banana 2 Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 option, starting at just $0.045 per image. Delivers fast text-to-image generation with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image
Google Nano Banana 2 (Gemini 3.1 Flash Image) delivers Pro-quality image generation at Flash speed with 512px to 4K resolution support. Features include improved text rendering, character consistency for up to 5 characters, and real-world knowledge integration. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit Fast
Google Nano Banana 2 Edit Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 editing option, starting at just $0.045 per image. Enables fast image editing with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit
Google Nano Banana 2 Edit (Gemini 3.1 Flash Image) enables advanced image editing with 4K-capable output, fast iteration, and precise instruction following. Supports text translation, localization within images, and maintains subject consistency during edits. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Edit
OpenAI's GPT Image 2.5 Sunburst Edit edits one or more reference images from natural-language instructions, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Text To Image
OpenAI's GPT Image 2.5 Sunburst Text-to-Image generates high-quality images from natural-language prompts, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Text To Image
OpenAI's GPT Image 2 Text-to-Image generates high-quality images from natural-language prompts. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Edit
OpenAI's GPT Image 2 Edit enables image editing from natural-language instructions with one or more reference images. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Text To Image
Qwen Image 3.0 Text to Image is a high-quality image generation model that creates high-quality images from text prompts, with advanced prompt understanding, strong visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Edit
Qwen Image 3.0 Edit is a high-quality image editing model that transforms existing images with natural-language instructions, delivering advanced instruction understanding, superior visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Примеры
WaveSpeedAI в деле
Реальные результаты, созданные через API WaveSpeedAI. Наведите курсор на видео для предпросмотра, нажмите, чтобы открыть в полном размере.
Как использовать
Как использовать API WaveSpeedAI
Четыре шага от регистрации до готовой генерации. Полные примеры на Python, Node.js и cURL — в разделе API ниже.
- 01
Получите API-ключ
Создайте аккаунт WaveSpeedAI и скопируйте API-ключ на панели управления. Новые аккаунты получают бесплатные стартовые кредиты — их хватит, чтобы несколько десятков раз запустить playground до начала списаний.
- 02
Отправьте предсказание
Отправьте входные данные в формате JSON методом POST на https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. Эндпоинт сразу возвращает id предсказания — генерация асинхронная, поэтому соединение не нужно держать открытым на время инференса.
- 03
Опрашивайте до завершения
Выполняйте GET https://api.wavespeed.ai/api/v3/predictions/{request_id}/result. При статусе completed забирайте результат; при failed, cancelled, timeout или deleted остановитесь с ошибкой; при любом другом статусе продолжайте опрос.
- 04
Получите URL результата
Когда статус станет "completed", возьмите URL из data.outputs[0]. Он указывает на созданный файл в CDN WaveSpeedAI — изображение, видео, аудио или 3D-файл, в зависимости от вызванного варианта модели.
Сценарии применения
Что можно создать с этими моделями
Типичные сценарии, для которых разработчики и авторы используют эти API.
Перенос интеграции с Higgsfield API за один вечер
Оба API асинхронные: вы отправляете JSON, получаете идентификатор запроса, затем опрашиваете результат или принимаете webhook. В WaveSpeedAI вы делаете POST на /api/v3/<model> с ключом API в заголовке Bearer и читаете результат предсказания, так что перенос сводится в основном к смене базового URL, заголовка авторизации и пути модели.
Изображения и видео в одном конвейере
Создавайте кадры в Nano Banana Pro, Seedream 5.0 или GPT Image 2.5, затем оживляйте их через image-to-video в Seedance 2.5, Kling 3.0 или Wan 3.0 — с одним ключом и одним балансом. В опубликованном каталоге Higgsfield API нет Nano Banana, Seedream и GPT Image.
MiniMax H3 с открытыми весами и LoRA
WaveSpeedAI размещает MiniMax H3 с открытыми весами: text-to-video, image-to-video, reference-to-video, редактирование и продление видео, конечные точки LoRA для собственных стилей и персонажей, а также режим text-to-image.
Длинные цельные кадры и видео по уровням
Seedance 2.5 рендерит цельные кадры длиной до 30 секунд со встроенным звуком; Kling 3.0 и Kling O3 доступны в уровнях Standard, Pro и 4K; у Wan 3.0 добавлен уровень Prime. Выбирайте под каждый кадр в рамках одной интеграции.
Агенты и пакетные задачи
Вызывайте любую модель из SDK для Python или JavaScript, по обычному HTTP, через CLI или MCP-сервер, чтобы coding-агенты и пакетные скрипты использовали те же конечные точки и цены, что и ваше приложение.
Советы
Советы по написанию запросов для этих моделей
Практические советы, как получать лучшие результаты от этих моделей, — на основе приёмов, которые работают в продакшен-пайплайнах для моделей видео.
- 01
Конкретно описывайте движения камеры
Используйте конкретную операторскую лексику — orbit, dolly-in, push-in, pan-left, crane shot, handheld follow. Общие промпты дают статичную или произвольную камеру; названные движения камеры напрямую соответствуют замыслу движения в данных обучения модели и заметно улучшают кадр.
- 02
Закрепляйте облик героя референсными изображениями
Если промпт зависит от конкретного человека, персонажа или продукта, загрузите референсное изображение вместе с промптом. Без референса облик «плывёт» между кадрами и сценами — один и тот же персонаж в каждой генерации выглядит чуть иначе.
- 03
Описывайте освещение и время суток
Подсказки об освещении вроде 'golden hour, soft warm directional light' или 'overcast diffused light, slate-grey sky' улучшают качество и согласованность гораздо сильнее, чем расплывчатые модификаторы качества. Освещение — один из самых сильных факторов, на которые опирается модель.
- 04
Используйте негативные промпты, чтобы подавить типичные сбои
Полезные негативные подсказки для видео: 'frame flicker, motion blur, watermark, text artifacts, distorted hands, low resolution, jpeg compression'. Негативные промпты ничего не стоят и заметно снижают долю генераций, которые иначе пришлось бы перезапускать.
- 05
Выбирайте самую короткую длительность, которая передаёт ваш эпизод
Большинство промптов лучше всего работают на 5–8 секундах. Более длинные клипы усиливают временные несоответствия (изменение героя, «уплывание» окружения). Если нужна 20-секундная последовательность, создайте три клипа по 6–8 секунд и смонтируйте их — качество останется выше, чем в одной длинной генерации.
- 06
Сразу выбирайте соотношение сторон под платформу
9:16 — для TikTok / Reels / Shorts, 16:9 — для горизонтальных лент и YouTube, 1:1 — для сеток постов. Модели обучаются немного по-разному для разных соотношений сторон — кадрирование 16:9 в 9:16 постфактум теряет и детализацию, и композицию, задуманную моделью.
Цены
Цены на API WaveSpeedAI
Оплата — за каждый результат. Итоговая стоимость зависит от параметров, заданных в playground каждого варианта (разрешение, длительность, количество результатов, референсы).
API
Вызов API WaveSpeedAI
Получите API-ключ на wavespeed.ai/accesskey, затем отправьте предсказание через REST. Playground генерирует готовые к вставке примеры для любой комбинации входных данных.
POSThttps://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5,
    "generate_audio": true
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": true
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": True
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)Сравнение
WaveSpeedAI и Higgsfield API
Чем отличаются WaveSpeedAI и Higgsfield API.
WaveSpeedAI и Higgsfield API: models
В Higgsfield API перечислено 82 позиции для изображений и видео, включая собственные модели Soul и Cinema Studio, а также Seedance, Kling, Wan, MiniMax и Qwen Image. WaveSpeedAI покрывает эти сторонние семейства и добавляет Nano Banana, Seedream, GPT Image, Veo, аудио, 3D и языковые модели: всего более 1000.
WaveSpeedAI и Higgsfield API: credits
Средства в Higgsfield API сгорают через год после покупки. Кредиты WaveSpeedAI не сгорают, членства и подписки нет: пополняйте баланс по мере необходимости и платите за запрос — цена каждой конечной точки указана на странице модели и в таблице цен на этой странице. Те же кредиты оплачивают и браузерные студии.
WaveSpeedAI и Higgsfield API: open models
В обоих сервисах есть MiniMax H3. В WaveSpeedAI это модель с открытыми весами, размещённая WaveSpeedAI, с конечными точками LoRA, reference-to-video, редактирования, продления и изображений рядом со стандартными text-to-video и image-to-video.
FAQ
Higgsfield API Alternative — часто задаваемые вопросы
Модели, цены, миграция — частые вопросы о переходе с Higgsfield API на WaveSpeedAI.
Является ли WaveSpeedAI альтернативой Higgsfield API?
Да. WaveSpeedAI предоставляет Seedance 2.5 и 2.0, Kling 3.0 и O3, Wan 3.0, MiniMax H3 и Qwen Image 3.0 в виде REST-конечных точек, а также Seedream 5.0, Nano Banana 2 и Pro, GPT Image 2.5 и 2 — с одним ключом API и оплатой за запрос.
Какие модели можно вызывать, если их нет в Higgsfield API?
В опубликованном каталоге моделей Higgsfield API нет Nano Banana, Seedream, GPT Image, Veo и аудиомоделей. В WaveSpeedAI Nano Banana 2 и Pro, Seedream 5.0, GPT Image 2.5 и 2, Veo 3.1 и голоса ElevenLabs доступны по тому же ключу, что и видеомодели.
Как перейти с Higgsfield API?
Создайте ключ на странице /accesskey, затем отправьте входные данные в формате JSON методом POST на https://api.wavespeed.ai/api/v3/<model> с заголовком Authorization: Bearer. В ответ вы получите идентификатор предсказания; опрашивайте https://api.wavespeed.ai/api/v3/predictions/<id>/result или передайте webhook. Сопоставьте каждую модель с её путём в WaveSpeedAI по списку конечных точек на этой странице.
MiniMax H3 в WaveSpeedAI — это модель с открытыми весами?
Да. Конечные точки wavespeed-ai/minimax-h3 запускают MiniMax H3 с открытыми весами в WaveSpeedAI, включая варианты LoRA для собственных стилей и персонажей, reference-to-video, редактирование и продление видео, а также режим text-to-image.
Нужны ли членство или подписка и сгорают ли кредиты?
Ни членства, ни подписки нет. WaveSpeedAI работает по принципу оплаты по факту: пополняйте кредиты, когда они нужны, и платите за каждый запрос по цене, указанной на странице модели и в таблице цен выше. Кредиты не сгорают. Подходящие новые аккаунты получают бесплатные стартовые кредиты.
Как вызывать эти API?
Создайте аккаунт WaveSpeedAI, скопируйте API-ключ на странице /accesskey, затем отправьте входные данные в JSON методом POST на https://api.wavespeed.ai/api/v3/<model>, например https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. Эндпоинт вернёт id предсказания. Опрашивайте эндпоинт результата или передайте вебхук. Примеры на Python / Node.js / cURL — выше.
Сколько стоят эти API?
Эндпоинты на этой странице стоят от $0.02 за запуск; цена каждой модели указана в таблице цен выше и на странице модели. Точная стоимость зависит от заданных параметров (разрешение, длительность, количество результатов, референсы), и playground показывает её до отправки.
Начните создавать в WaveSpeedAI
Бесплатные стартовые кредиты при регистрации. Один API-ключ для 1000+ ИИ-моделей от всех ведущих провайдеров.