Higgsfield API Alternative
Os modelos que desenvolvedores procuram na API do Higgsfield — Seedance 2.5 e 2.0, Kling 3.0 e O3, Wan 3.0, MiniMax H3 de pesos abertos e Qwen Image 3.0 — além de Seedream 5.0, Nano Banana 2 e Pro e GPT Image 2.5 e 2, em uma única chave de API da WaveSpeedAI. Pay as you go: os créditos nunca expiram e não há assinatura nem plano de associação.
Avaliando a API do Higgsfield? Todos os endpoints abaixo estão ativos na WaveSpeedAI hoje, com playground, exemplos e o preço atual por execução. Recarregue uma vez e use seus créditos quando quiser — eles nunca expiram — nesses modelos e em mais de 1.000 outros modelos de imagem, vídeo, áudio, 3D e linguagem.
Visão geral
Sobre o Higgsfield API Alternative
O que você pode chamar na WaveSpeedAI se estiver avaliando Higgsfield API.
Os modelos que desenvolvedores procuram na API do Higgsfield — Seedance 2.5 e 2.0, Kling 3.0 e O3, Wan 3.0, MiniMax H3 de pesos abertos e Qwen Image 3.0 — além de Seedream 5.0, Nano Banana 2 e Pro e GPT Image 2.5 e 2, em uma única chave de API da WaveSpeedAI. Pay as you go: os créditos nunca expiram e não há assinatura nem plano de associação.
Avaliando a API do Higgsfield? Todos os endpoints abaixo estão ativos na WaveSpeedAI hoje, com playground, exemplos e o preço atual por execução. Recarregue uma vez e use seus créditos quando quiser — eles nunca expiram — nesses modelos e em mais de 1.000 outros modelos de imagem, vídeo, áudio, 3D e linguagem.
Os endpoints abaixo são 37 endpoints REST ativos da WaveSpeedAI para esses modelos, cobrindo os fluxos de Text-To-Video, Image-To-Video, Image-Tools, Text-To-Image, Image-To-Image. Cada um tem seu próprio playground, preço e exemplos, e todos são chamados do mesmo jeito: POST com JSON, recebe um id de predição e faz polling ou recebe um webhook.
Eles compartilham uma chave de API, um saldo e uma integração com os outros mais de 1.000 modelos da WaveSpeedAI, de texto para imagem e texto para vídeo até áudio, 3D, ampliação, edição e modelos de linguagem.
Endpoints
Todos os endpoints da API de WaveSpeedAI
37 endpoints disponíveis agora na WaveSpeedAI — escolha a variante que combina com seu fluxo de trabalho.
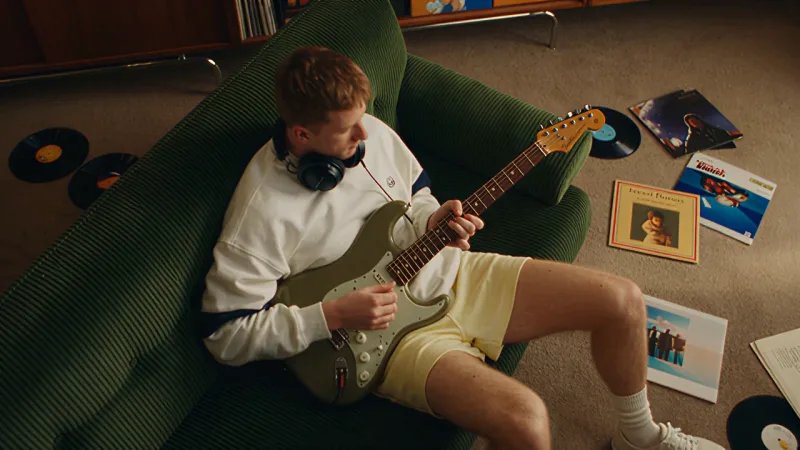
Seedance 2.5 Text To Video Turbo
Seedance 2.5 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
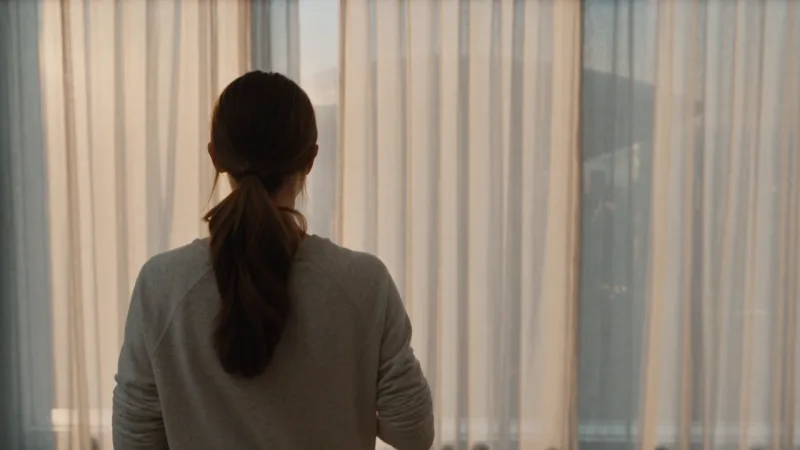
Seedance 2.5 Text To Video
Seedance 2.5 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
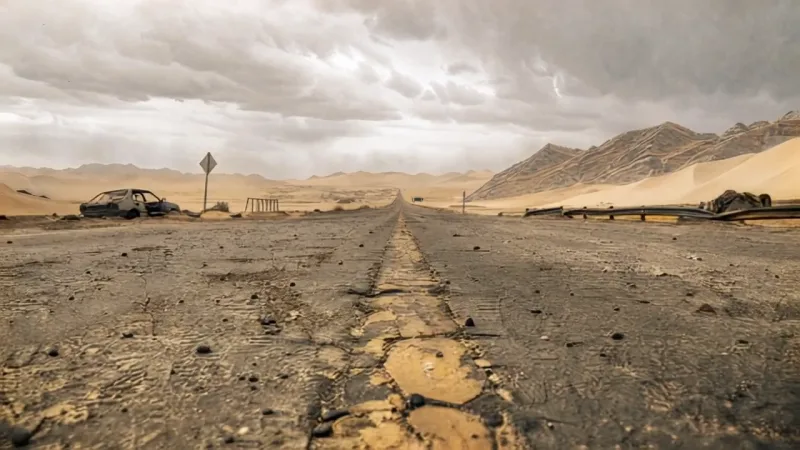
Seedance 2.5 Image To Video Turbo
Seedance 2.5 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
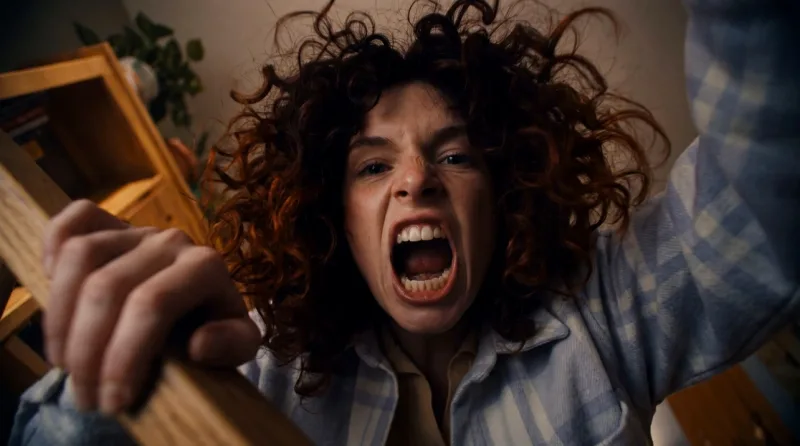
Seedance 2.5 Image To Video
Seedance 2.5 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Seedance 2.0 Text To Video Turbo
Seedance 2.0 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.0 Text To Video
Seedance 2.0 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
Seedance 2.0 Image To Video Turbo
Seedance 2.0 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.0 Image To Video
Seedance 2.0 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Kling v3.0 Pro Text To Video
Kling 3.0 Pro delivers top-tier text-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling v3.0 Pro Image To Video
Kling 3.0 Pro delivers top-tier image-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling Video O3 Pro Text To Video
Kling Omni Video O3 is Kuaishou's advanced unified multi-modal video model with MVL (Multi-modal Visual Language) technology. Text-to-Video mode generates cinematic videos from text prompts with subject consistency, natural physics simulation, and precise semantic understanding. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
Kling Video O3 Pro Image To Video
Kling Omni Video O3 Image-to-Video transforms static images into dynamic cinematic videos using MVL (Multi-modal Visual Language) technology. Maintains subject consistency while adding natural motion, physics simulation, and seamless scene dynamics. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
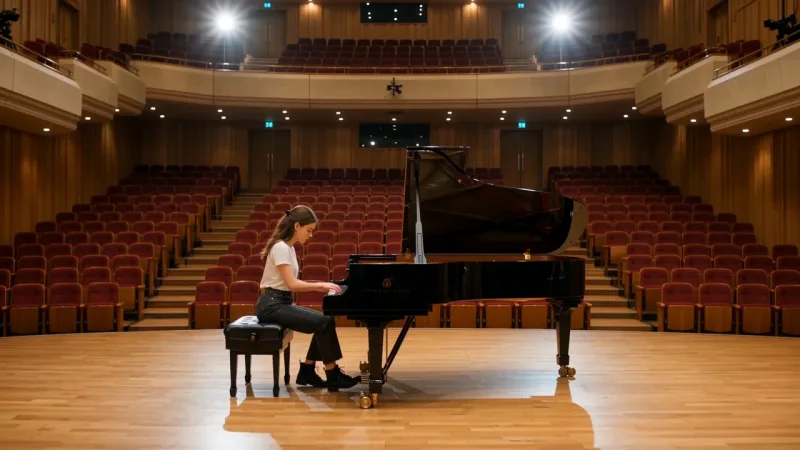
Wan 3.0 Text To Video
Wan 3.0 Text to Video generates cinematic videos from text prompts, with flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality video generation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
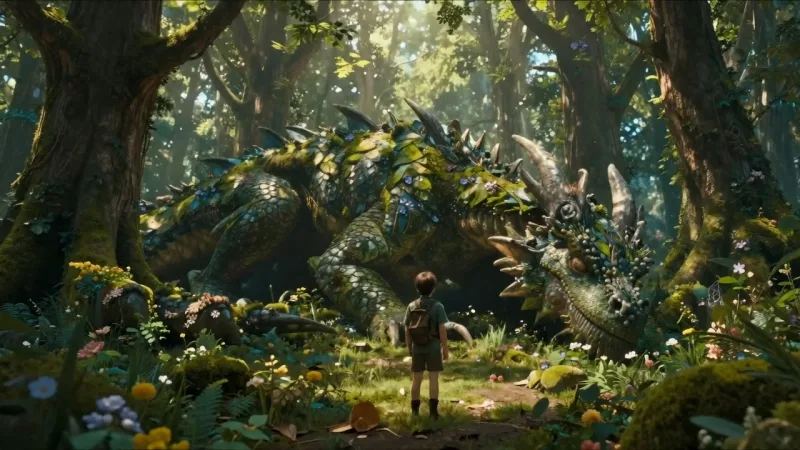
Wan 3.0 Image To Video
Wan 3.0 Image to Video animates a first-frame image into a cinematic video, with optional last-frame guidance, flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality motion and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
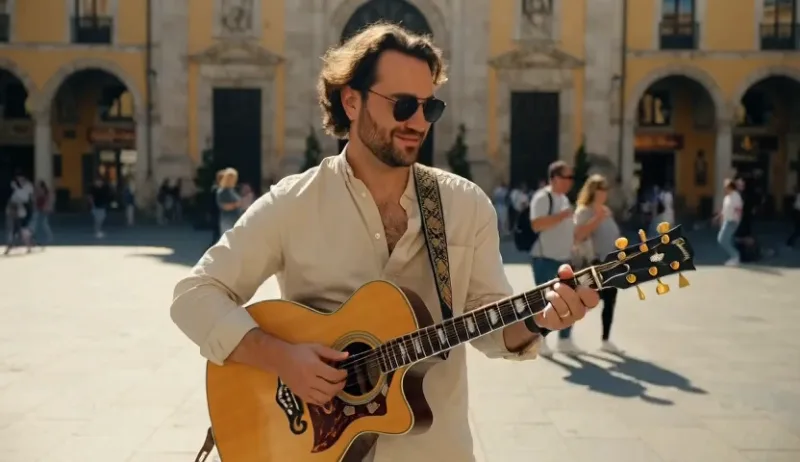
Minimax H3 Text To Video Lora
MiniMax H3 Open Weights Text to Video with custom LoRA support generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
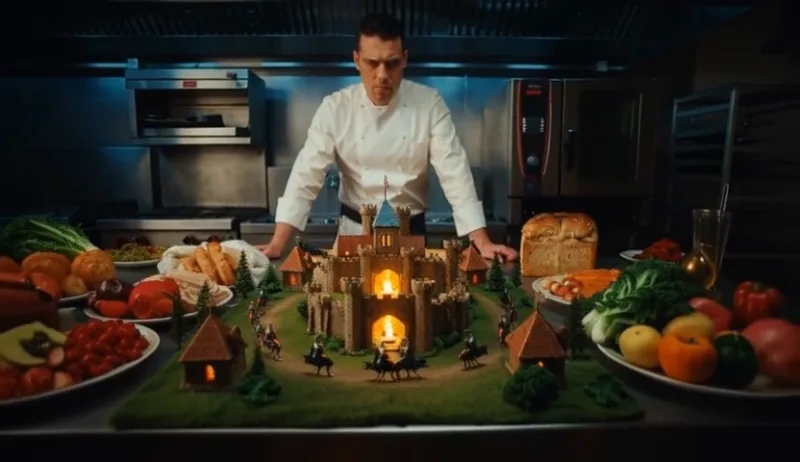
Minimax H3 Text To Video
MiniMax H3 Open Weights Text to Video generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video Lora
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro Layer Decomposition
Seedream V5.0 Pro Layer Decomposition separates a single image into a base image and transparent layers, enabling flexible compositing, image editing, asset extraction, and layered design workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro
Seedream V5.0 Pro Text to Image by ByteDance generates high-quality images from text prompts, with aspect ratio selection, strong prompt following, and 1K / 2K output tiers for flexible image creation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
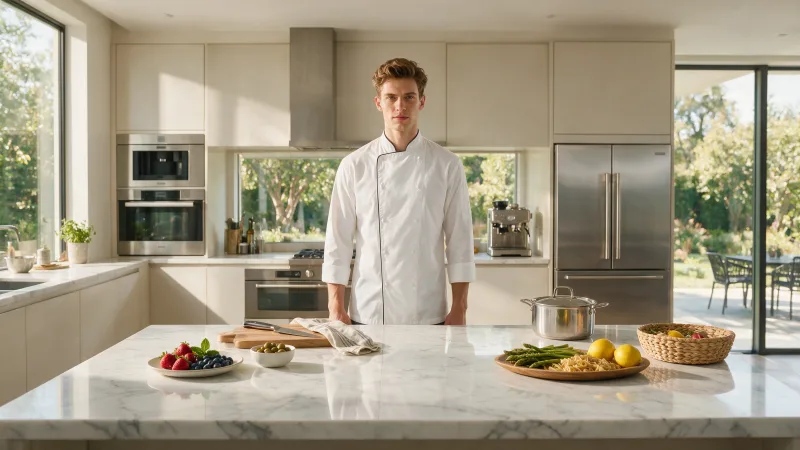
Seedream v5.0 Pro Edit
Seedream V5.0 Pro Edit by ByteDance edits and generates images from single-image or multi-reference inputs, supporting up to 10 reference images, aspect ratio selection, and 1K / 2K output tiers. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
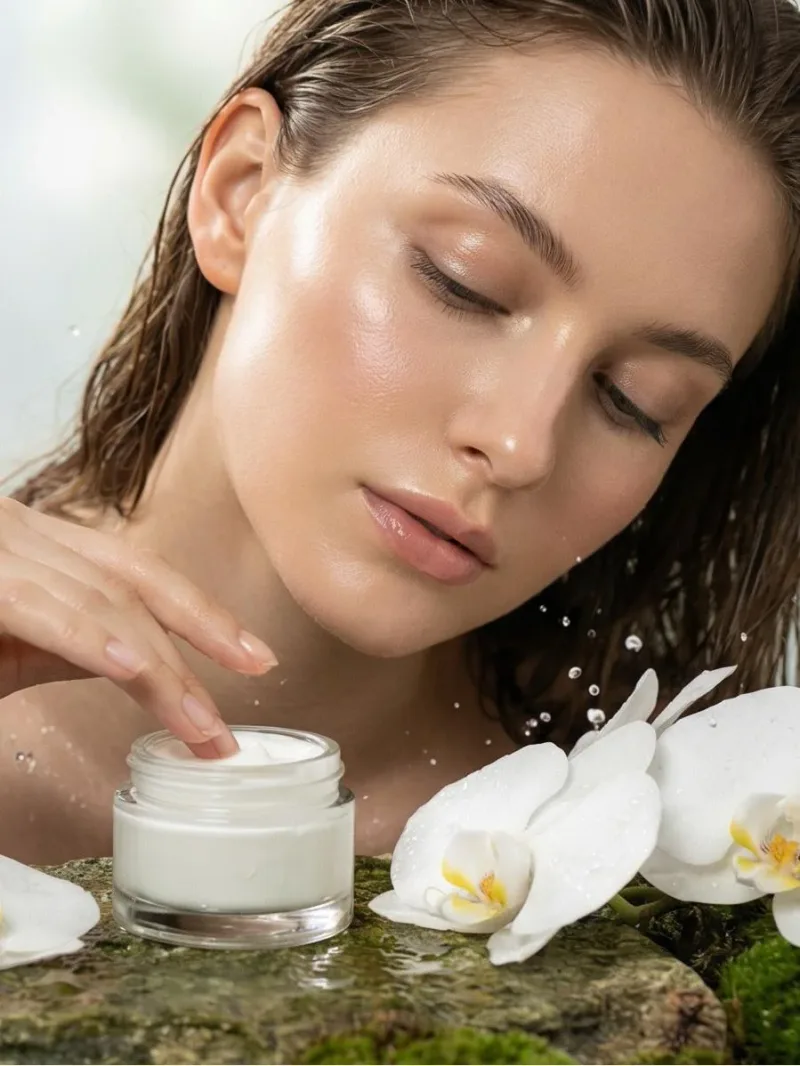
Nano Banana Pro Text To Image Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a next-generation text-to-image model capable of generating multiple high-quality images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
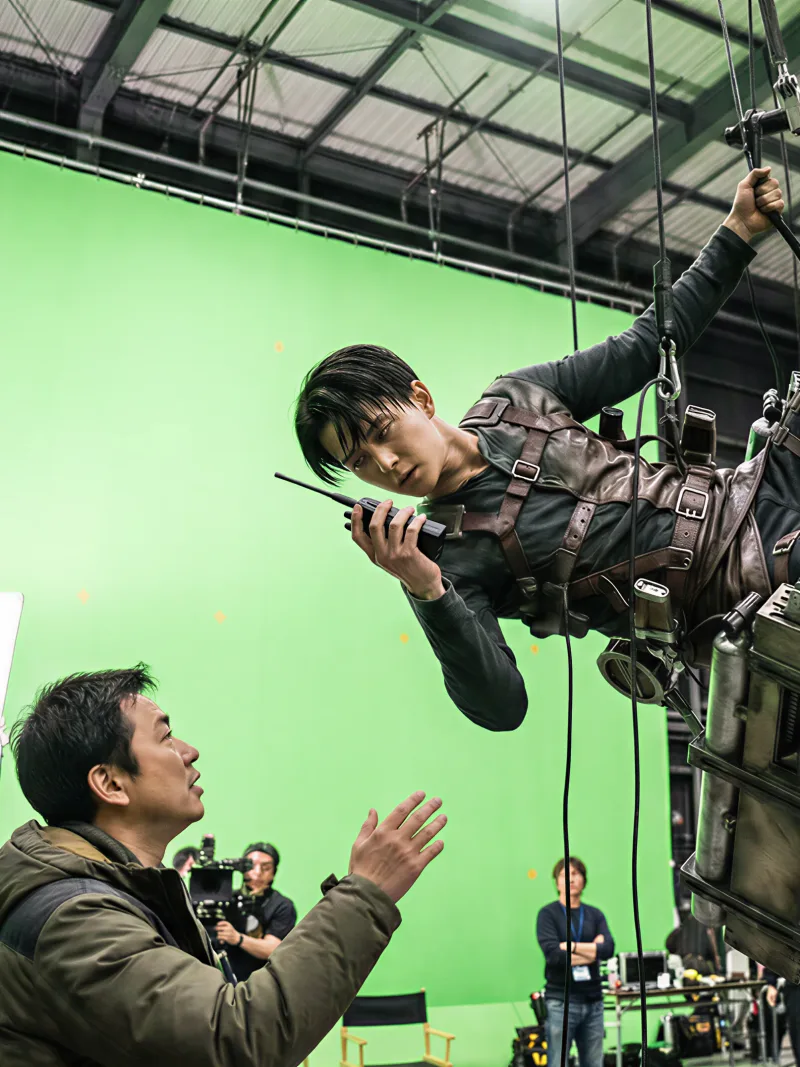
Nano Banana Pro Text To Image Ultra
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
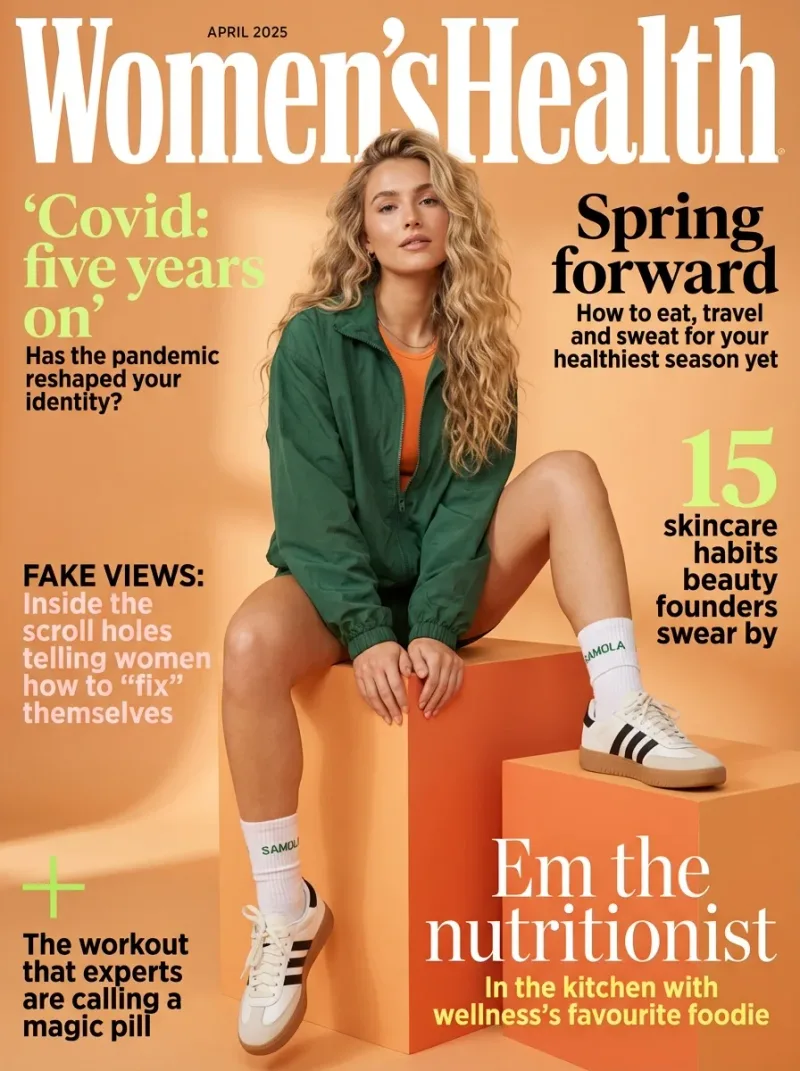
Nano Banana Pro Text To Image
Google's Nano Banana pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res 4K image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) Edit is a next-generation image editing model capable of generating multiple high-quality edited images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Ultra
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with highres output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with 4K-capable output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image Fast
Google Nano Banana 2 Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 option, starting at just $0.045 per image. Delivers fast text-to-image generation with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image
Google Nano Banana 2 (Gemini 3.1 Flash Image) delivers Pro-quality image generation at Flash speed with 512px to 4K resolution support. Features include improved text rendering, character consistency for up to 5 characters, and real-world knowledge integration. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit Fast
Google Nano Banana 2 Edit Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 editing option, starting at just $0.045 per image. Enables fast image editing with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit
Google Nano Banana 2 Edit (Gemini 3.1 Flash Image) enables advanced image editing with 4K-capable output, fast iteration, and precise instruction following. Supports text translation, localization within images, and maintains subject consistency during edits. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Edit
OpenAI's GPT Image 2.5 Sunburst Edit edits one or more reference images from natural-language instructions, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Text To Image
OpenAI's GPT Image 2.5 Sunburst Text-to-Image generates high-quality images from natural-language prompts, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Text To Image
OpenAI's GPT Image 2 Text-to-Image generates high-quality images from natural-language prompts. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Edit
OpenAI's GPT Image 2 Edit enables image editing from natural-language instructions with one or more reference images. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Text To Image
Qwen Image 3.0 Text to Image is a high-quality image generation model that creates high-quality images from text prompts, with advanced prompt understanding, strong visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Edit
Qwen Image 3.0 Edit is a high-quality image editing model that transforms existing images with natural-language instructions, delivering advanced instruction understanding, superior visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Exemplos
Veja o WaveSpeedAI em ação
Resultados reais gerados pela API do WaveSpeedAI. Passe o mouse sobre qualquer vídeo para pré-visualizar e clique para abrir o visualizador em tamanho real.
Como usar
Como usar a API do WaveSpeedAI
Quatro passos do cadastro até uma geração concluída. Exemplos completos em Python, Node.js e cURL estão na seção de API abaixo.
- 01
Obtenha uma chave de API
Crie uma conta na WaveSpeedAI e copie sua chave de API no painel. Contas novas recebem créditos iniciais grátis — o suficiente para usar o playground algumas dezenas de vezes antes de a cobrança começar.
- 02
Envie uma predição
Faça POST da sua entrada em JSON para https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. O endpoint devolve um id de predição imediatamente — as gerações são assíncronas, então você não mantém uma conexão aberta durante a inferência.
- 03
Consulte até concluir
Faça GET em https://api.wavespeed.ai/api/v3/predictions/{request_id}/result. Retorne os resultados quando o status for completed; pare com erro em failed, cancelled, timeout ou deleted; continue consultando em qualquer outro status.
- 04
Leia a URL do resultado
Quando o status for "completed", leia a URL em data.outputs[0]. A URL aponta para a mídia gerada na CDN da WaveSpeedAI — imagem, vídeo, áudio ou arquivo 3D, conforme a variante do modelo que você chamou.
Casos de uso
O que você pode criar com esses modelos
Fluxos de trabalho comuns para os quais desenvolvedores e criadores usam essas APIs.
Migre uma integração da API do Higgsfield em uma tarde
Ambas as APIs são assíncronas: você envia JSON, recebe um id de requisição e depois consulta o resultado ou recebe um webhook. Na WaveSpeedAI, você faz POST para /api/v3/<model> com uma chave de API Bearer e lê o resultado da prediction, então a migração costuma se resumir a trocar a URL base, o cabeçalho de autenticação e o caminho do modelo.
Imagem e vídeo em um único pipeline
Gere imagens estáticas com Nano Banana Pro, Seedream 5.0 ou GPT Image 2.5 e anime-as com imagem para vídeo do Seedance 2.5, Kling 3.0 ou Wan 3.0, com uma só chave e um só saldo. O catálogo publicado da API do Higgsfield não lista Nano Banana, Seedream nem GPT Image.
MiniMax H3 de pesos abertos com LoRA
A WaveSpeedAI hospeda o MiniMax H3 de pesos abertos com texto para vídeo, imagem para vídeo, referência para vídeo, edição e extensão de vídeo, endpoints LoRA para estilos e personagens personalizados e um modo de texto para imagem.
Planos únicos longos e vídeo em níveis
O Seedance 2.5 renderiza planos únicos de até 30 segundos com áudio nativo; o Kling 3.0 e o Kling O3 vêm nos níveis Standard, Pro e 4K; o Wan 3.0 adiciona um nível Prime. Escolha por plano, dentro da mesma integração.
Agentes e jobs em lote
Chame todos os modelos pelos SDKs de Python ou JavaScript, por HTTP puro, pela CLI ou por um servidor MCP, para que agentes de código e scripts em lote usem os mesmos endpoints e preços do seu app.
Dicas
Dicas de prompt para esses modelos
Conselhos práticos para obter melhores resultados com esses modelos — extraídos dos padrões que funcionam em modelos de vídeo em pipelines de produção.
- 01
Seja específico nos movimentos de câmera
Use vocabulário de cinematografia concreto — orbit, dolly-in, push-in, pan-left, crane shot, handheld follow. Prompts genéricos produzem escolhas de câmera estáticas ou arbitrárias; movimentos de câmera nomeados correspondem diretamente à intenção de movimento nos dados de treinamento do modelo e melhoram muito a qualidade do plano.
- 02
Ancore a identidade do personagem com imagens de referência
Se o seu prompt depende de uma pessoa, personagem ou produto específico, envie uma imagem de referência junto com o prompt. Sem referência, a identidade se desvia entre quadros e planos — o mesmo personagem acaba parecendo uma pessoa ligeiramente diferente a cada geração.
- 03
Descreva a iluminação e a hora do dia
Indicações de iluminação como "golden hour, soft warm directional light" ou "overcast diffused light, slate-grey sky" melhoram a qualidade e a consistência muito mais do que modificadores vagos de qualidade. A iluminação é um dos priors mais fortes em que o modelo se baseia.
- 04
Use prompts negativos para suprimir falhas comuns
Negativos úteis para vídeo: "frame flicker, motion blur, watermark, text artifacts, distorted hands, low resolution, jpeg compression". Prompts negativos não custam nada e reduzem de forma perceptível a taxa de gerações que você teria de refazer.
- 05
Escolha a menor duração que captura o seu momento
A maioria dos prompts funciona melhor em 5 a 8 segundos. Clipes mais longos amplificam inconsistências temporais (sujeito que se deforma, deriva do ambiente). Se você precisa de uma sequência de 20 segundos, gere três clipes de 6 a 8 segundos e monte-os na edição — a qualidade fica maior do que em uma única geração longa.
- 06
Combine a proporção de tela com a plataforma desde o início
9:16 para TikTok / Reels / Shorts, 16:9 para feeds em paisagem e YouTube, 1:1 para grades de posts. Os modelos são treinados de modo ligeiramente diferente por proporção de tela — recortar um 16:9 em 9:16 depois perde tanto a fidelidade quanto a composição que o modelo pretendia.
Preços
Preços da API de WaveSpeedAI
O preço é por resultado. O valor final varia conforme os parâmetros definidos no playground de cada variante (resolução, duração, quantidade de resultados, referências).
API
Chame a API de WaveSpeedAI
Crie uma chave de API em wavespeed.ai/accesskey e envie uma predição via REST. O playground gera exemplos prontos para colar para qualquer combinação de entradas.
POSThttps://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5,
    "generate_audio": true
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": true
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": True
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)Comparar
WaveSpeedAI vs Higgsfield API
Onde a WaveSpeedAI e Higgsfield API diferem.
WaveSpeedAI vs Higgsfield API: models
A API do Higgsfield lista 82 entradas de imagem e vídeo, incluindo seus próprios modelos Soul e Cinema Studio, além de Seedance, Kling, Wan, MiniMax e Qwen Image. A WaveSpeedAI cobre essas famílias de terceiros e acrescenta Nano Banana, Seedream, GPT Image, Veo, áudio, 3D e modelos de linguagem: mais de 1.000 no total.
WaveSpeedAI vs Higgsfield API: credits
Os fundos da API do Higgsfield expiram um ano após a compra. Os créditos da WaveSpeedAI nunca expiram e não há assinatura nem plano de associação: recarregue quando precisar e pague por requisição, com o preço de cada endpoint na página do modelo e na tabela de preços desta página. Os mesmos créditos também pagam os studios no navegador.
WaveSpeedAI vs Higgsfield API: open models
Ambas listam o MiniMax H3. Na WaveSpeedAI, é o modelo de pesos abertos hospedado pela WaveSpeedAI, com endpoints de LoRA, referência para vídeo, edição, extensão e imagem ao lado de texto para vídeo e imagem para vídeo padrão.
FAQ
Higgsfield API Alternative — Perguntas frequentes
Modelos, preços, migração — perguntas comuns sobre migrar de Higgsfield API para a WaveSpeedAI.
A WaveSpeedAI é uma alternativa à API do Higgsfield?
Sim. A WaveSpeedAI oferece Seedance 2.5 e 2.0, Kling 3.0 e O3, Wan 3.0, MiniMax H3 e Qwen Image 3.0 como endpoints REST, além de Seedream 5.0, Nano Banana 2 e Pro e GPT Image 2.5 e 2, com uma única chave de API e preço por requisição.
Quais modelos posso chamar que a API do Higgsfield não lista?
O catálogo de modelos publicado da API do Higgsfield não inclui Nano Banana, Seedream, GPT Image, Veo nem modelos de áudio. Na WaveSpeedAI, Nano Banana 2 e Pro, Seedream 5.0, GPT Image 2.5 e 2, Veo 3.1 e as vozes do ElevenLabs ficam atrás da mesma chave dos modelos de vídeo.
Como migro da API do Higgsfield?
Crie uma chave em /accesskey e envie sua entrada em JSON com POST para https://api.wavespeed.ai/api/v3/<model>, com um cabeçalho Authorization: Bearer. Você recebe um id de prediction; consulte https://api.wavespeed.ai/api/v3/predictions/<id>/result ou informe um webhook. Mapeie cada modelo para o caminho correspondente na WaveSpeedAI a partir da lista de endpoints desta página.
O MiniMax H3 na WaveSpeedAI é o modelo de pesos abertos?
Sim. Os endpoints wavespeed-ai/minimax-h3 executam o MiniMax H3 de pesos abertos na WaveSpeedAI, incluindo variantes LoRA para estilos e personagens personalizados, referência para vídeo, edição e extensão de vídeo e um modo de texto para imagem.
Preciso de assinatura ou plano de associação? Os créditos expiram?
Sem plano de associação e sem assinatura. A WaveSpeedAI é pay as you go: recarregue créditos quando precisar e pague por requisição pelo preço exibido em cada página de modelo e na tabela de preços acima. Os créditos nunca expiram. Contas novas elegíveis recebem créditos iniciais gratuitos.
Como chamo essas APIs?
Crie uma conta na WaveSpeedAI, copie sua chave de API em /accesskey e faça POST da sua entrada em JSON para https://api.wavespeed.ai/api/v3/<model>, por exemplo https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. O endpoint devolve um id de predição. Consulte o endpoint de resultado ou informe um webhook. Exemplos em Python / Node.js / cURL estão acima.
Quanto custam essas APIs?
Os endpoints desta página começam em $0.02 por execução; o preço de cada modelo está na tabela de preços acima e na página do modelo. O custo exato varia conforme os parâmetros definidos (resolução, duração, quantidade de resultados, referências), e o playground o mostra antes de você enviar.
Comece a criar na WaveSpeedAI
Créditos iniciais grátis no cadastro. Uma chave de API para mais de 1.000 modelos de IA de todos os principais provedores.