Higgsfield API Alternative
Modele, których deweloperzy szukają w API Higgsfield — Seedance 2.5 i 2.0, Kling 3.0 i O3, Wan 3.0, open-weights MiniMax H3 i Qwen Image 3.0 — a do tego Seedream 5.0, Nano Banana 2 i Pro oraz GPT Image 2.5 i 2, pod jednym kluczem API WaveSpeedAI. Płatność za użycie: kredyty nigdy nie wygasają i nie ma członkostwa ani subskrypcji.
Oceniasz API Higgsfield? Każdy endpoint poniżej jest już dostępny w WaveSpeedAI, z playground, przykładami i aktualną ceną za uruchomienie. Doładuj raz i wykorzystuj kredyty, kiedy chcesz — nigdy nie wygasają — w tych modelach oraz w ponad 1000 innych modeli obrazu, wideo, dźwięku, 3D i językowych.
Przegląd
O modelu Higgsfield API Alternative
Co możesz wywołać w WaveSpeedAI, jeśli rozważasz Higgsfield API.
Modele, których deweloperzy szukają w API Higgsfield — Seedance 2.5 i 2.0, Kling 3.0 i O3, Wan 3.0, open-weights MiniMax H3 i Qwen Image 3.0 — a do tego Seedream 5.0, Nano Banana 2 i Pro oraz GPT Image 2.5 i 2, pod jednym kluczem API WaveSpeedAI. Płatność za użycie: kredyty nigdy nie wygasają i nie ma członkostwa ani subskrypcji.
Oceniasz API Higgsfield? Każdy endpoint poniżej jest już dostępny w WaveSpeedAI, z playground, przykładami i aktualną ceną za uruchomienie. Doładuj raz i wykorzystuj kredyty, kiedy chcesz — nigdy nie wygasają — w tych modelach oraz w ponad 1000 innych modeli obrazu, wideo, dźwięku, 3D i językowych.
Poniżej znajduje się 37 aktywnych endpointów REST WaveSpeedAI dla tych modeli, obejmujących workflowy: Text-To-Video, Image-To-Video, Image-Tools, Text-To-Image, Image-To-Image. Każdy ma własny playground, cennik i przykłady, a wszystkie wywołuje się tak samo: POST z JSON, odbiór identyfikatora predykcji, następnie odpytywanie lub webhook.
Łączy je jeden klucz API, jedno saldo i jedna integracja z pozostałymi ponad 1000 modeli w WaveSpeedAI: od tekstu na obraz i tekstu na wideo, przez dźwięk, 3D, upscaling i edycję, po modele językowe.
Endpointy
Wszystkie endpointy API WaveSpeedAI
37 endpointów dostępnych teraz w WaveSpeedAI — wybierz wariant pasujący do Twojego workflow.
Seedance 2.5 Text To Video Turbo
Seedance 2.5 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Text To Video
Seedance 2.5 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
Seedance 2.5 Image To Video Turbo
Seedance 2.5 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Image To Video
Seedance 2.5 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Seedance 2.0 Text To Video Turbo
Seedance 2.0 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.0 Text To Video
Seedance 2.0 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
Seedance 2.0 Image To Video Turbo
Seedance 2.0 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.0 Image To Video
Seedance 2.0 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Kling v3.0 Pro Text To Video
Kling 3.0 Pro delivers top-tier text-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling v3.0 Pro Image To Video
Kling 3.0 Pro delivers top-tier image-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling Video O3 Pro Text To Video
Kling Omni Video O3 is Kuaishou's advanced unified multi-modal video model with MVL (Multi-modal Visual Language) technology. Text-to-Video mode generates cinematic videos from text prompts with subject consistency, natural physics simulation, and precise semantic understanding. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
Kling Video O3 Pro Image To Video
Kling Omni Video O3 Image-to-Video transforms static images into dynamic cinematic videos using MVL (Multi-modal Visual Language) technology. Maintains subject consistency while adding natural motion, physics simulation, and seamless scene dynamics. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Text To Video
Wan 3.0 Text to Video generates cinematic videos from text prompts, with flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality video generation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Image To Video
Wan 3.0 Image to Video animates a first-frame image into a cinematic video, with optional last-frame guidance, flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality motion and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Text To Video Lora
MiniMax H3 Open Weights Text to Video with custom LoRA support generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Text To Video
MiniMax H3 Open Weights Text to Video generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video Lora
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro Layer Decomposition
Seedream V5.0 Pro Layer Decomposition separates a single image into a base image and transparent layers, enabling flexible compositing, image editing, asset extraction, and layered design workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro
Seedream V5.0 Pro Text to Image by ByteDance generates high-quality images from text prompts, with aspect ratio selection, strong prompt following, and 1K / 2K output tiers for flexible image creation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
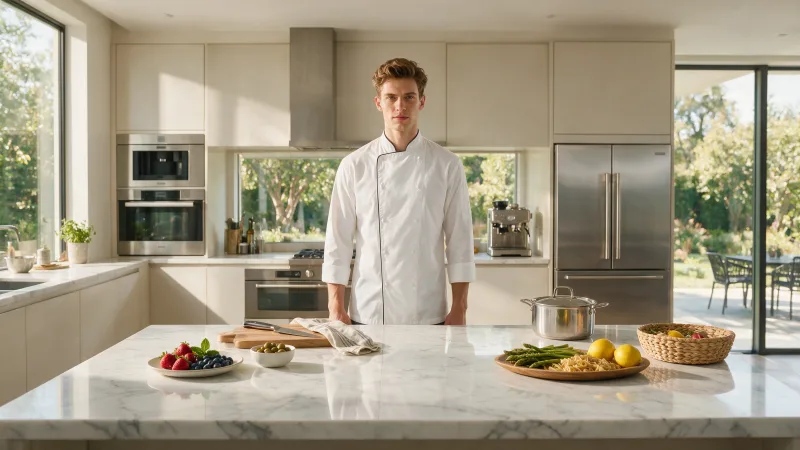
Seedream v5.0 Pro Edit
Seedream V5.0 Pro Edit by ByteDance edits and generates images from single-image or multi-reference inputs, supporting up to 10 reference images, aspect ratio selection, and 1K / 2K output tiers. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
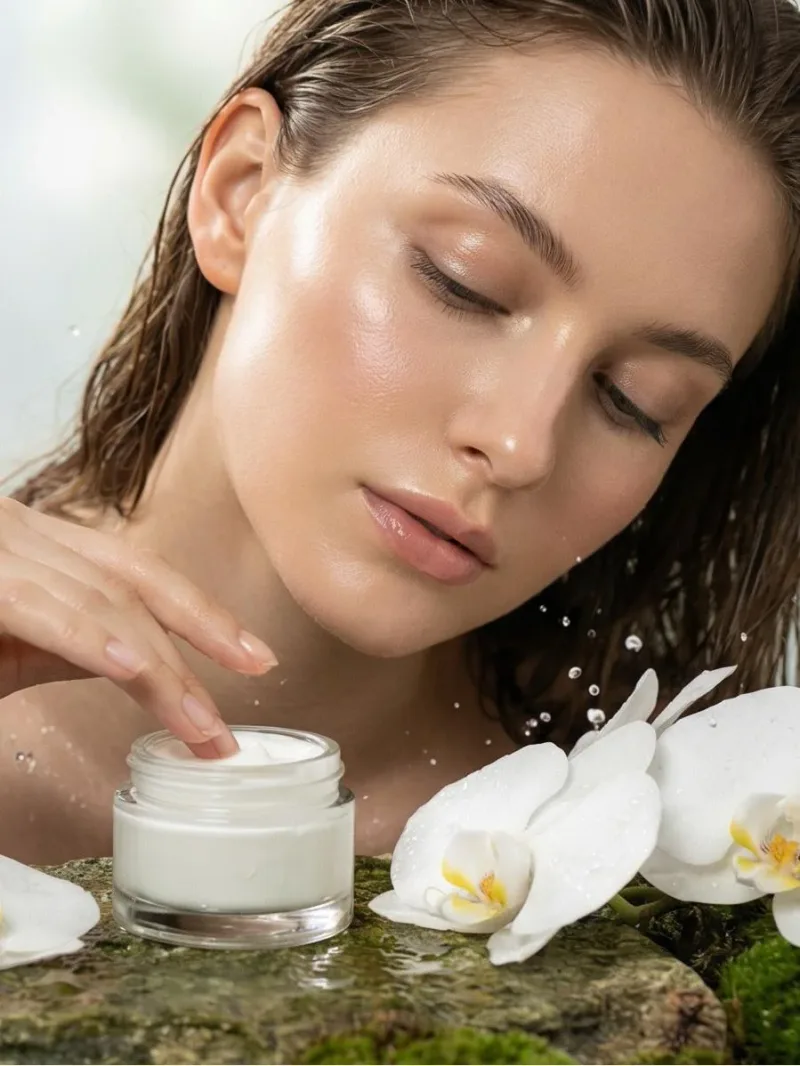
Nano Banana Pro Text To Image Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a next-generation text-to-image model capable of generating multiple high-quality images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Text To Image Ultra
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
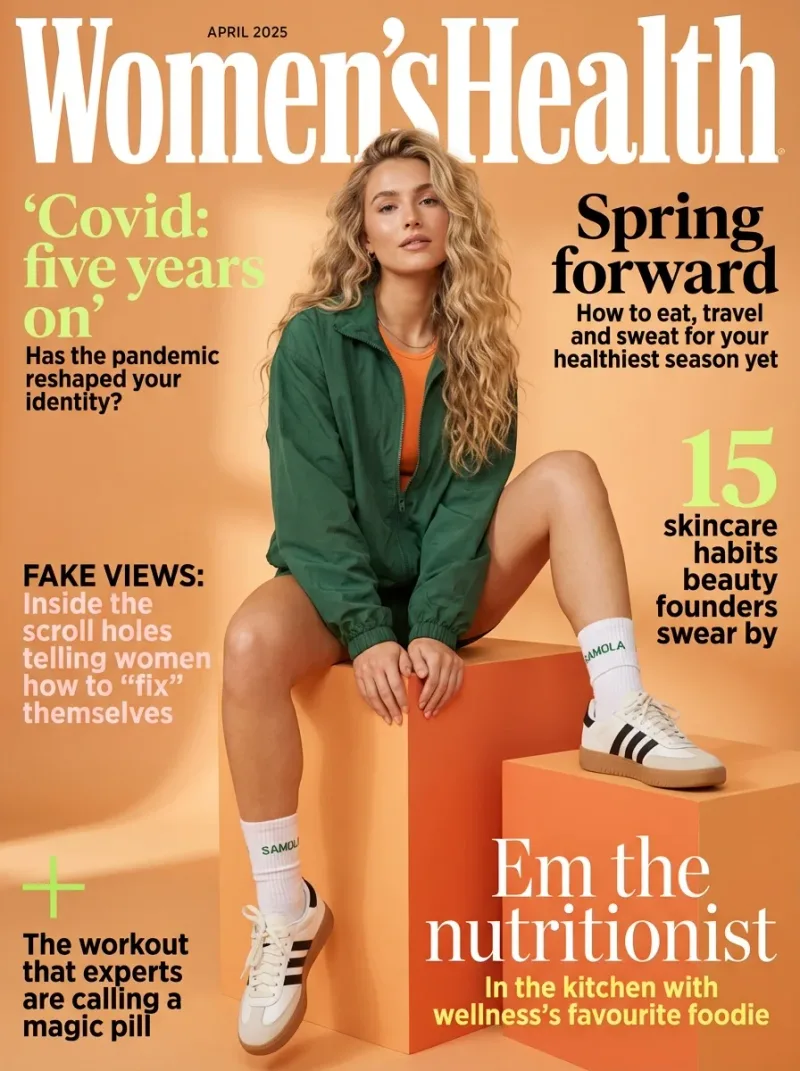
Nano Banana Pro Text To Image
Google's Nano Banana pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res 4K image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) Edit is a next-generation image editing model capable of generating multiple high-quality edited images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Ultra
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with highres output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with 4K-capable output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image Fast
Google Nano Banana 2 Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 option, starting at just $0.045 per image. Delivers fast text-to-image generation with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image
Google Nano Banana 2 (Gemini 3.1 Flash Image) delivers Pro-quality image generation at Flash speed with 512px to 4K resolution support. Features include improved text rendering, character consistency for up to 5 characters, and real-world knowledge integration. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit Fast
Google Nano Banana 2 Edit Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 editing option, starting at just $0.045 per image. Enables fast image editing with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit
Google Nano Banana 2 Edit (Gemini 3.1 Flash Image) enables advanced image editing with 4K-capable output, fast iteration, and precise instruction following. Supports text translation, localization within images, and maintains subject consistency during edits. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Edit
OpenAI's GPT Image 2.5 Sunburst Edit edits one or more reference images from natural-language instructions, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Text To Image
OpenAI's GPT Image 2.5 Sunburst Text-to-Image generates high-quality images from natural-language prompts, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Text To Image
OpenAI's GPT Image 2 Text-to-Image generates high-quality images from natural-language prompts. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Edit
OpenAI's GPT Image 2 Edit enables image editing from natural-language instructions with one or more reference images. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Text To Image
Qwen Image 3.0 Text to Image is a high-quality image generation model that creates high-quality images from text prompts, with advanced prompt understanding, strong visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Edit
Qwen Image 3.0 Edit is a high-quality image editing model that transforms existing images with natural-language instructions, delivering advanced instruction understanding, superior visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Przykłady
WaveSpeedAI w akcji
Prawdziwe wyniki wygenerowane przez API WaveSpeedAI. Najedź na wideo, aby zobaczyć podgląd, kliknij, aby otworzyć pełnowymiarowy podgląd.
Jak zacząć
Jak korzystać z API WaveSpeedAI
Cztery kroki od rejestracji do gotowego wyniku. Pełne przykłady w Pythonie, Node.js i cURL znajdziesz w sekcji API poniżej.
- 01
Uzyskaj klucz API
Załóż konto WaveSpeedAI i skopiuj klucz API z panelu. Nowe konta otrzymują darmowe kredyty na start — wystarczy na kilkadziesiąt uruchomień w playground, zanim zaczną się opłaty.
- 02
Wyślij predykcję
Wyślij dane wejściowe jako JSON metodą POST na https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. Endpoint od razu zwraca identyfikator predykcji — generowanie jest asynchroniczne, więc nie trzymasz otwartego połączenia na czas inferencji.
- 03
Sprawdzaj ukończenie
Wywołaj GET https://api.wavespeed.ai/api/v3/predictions/{request_id}/result. Przy statusie completed odbierz wyniki; przy failed, cancelled, timeout lub deleted zakończ z błędem; przy każdym innym statusie odpytuj dalej.
- 04
Odczytaj adres wyniku
Gdy status to "completed", odczytaj adres URL z data.outputs[0]. Wskazuje on wygenerowane media w CDN WaveSpeedAI — obraz, wideo, dźwięk lub plik 3D, zależnie od wywołanego wariantu modelu.
Zastosowania
Co możesz zbudować z tymi modelami
Typowe workflowy, do których deweloperzy i twórcy używają tych API.
Przenieś integrację z API Higgsfield w jedno popołudnie
Oba API są asynchroniczne: wysyłasz JSON, dostajesz identyfikator żądania, a potem odpytujesz lub korzystasz z webhooka. W WaveSpeedAI wysyłasz POST na /api/v3/<model> z kluczem API Bearer i odczytujesz wynik predykcji, więc przeniesienie sprowadza się głównie do zmiany bazowego URL, nagłówka uwierzytelniania i ścieżki modelu.
Obraz i wideo w jednym potoku
Generuj obrazy statyczne w Nano Banana Pro, Seedream 5.0 lub GPT Image 2.5, a następnie animuj je w Seedance 2.5, Kling 3.0 lub Wan 3.0 image-to-video — na jednym kluczu i jednym saldzie. Opublikowany katalog API Higgsfield nie wymienia Nano Banana, Seedream ani GPT Image.
Open-weights MiniMax H3 z LoRA
WaveSpeedAI hostuje open-weights MiniMax H3 z tekstem na wideo, obrazem na wideo, referencją na wideo, edycją i rozszerzaniem wideo, endpointami LoRA dla własnych stylów i postaci oraz trybem tekst na obraz.
Długie pojedyncze ujęcia i wideo warstwowe
Seedance 2.5 renderuje pojedyncze ujęcia do 30 sekund z natywnym dźwiękiem; Kling 3.0 i Kling O3 występują na poziomach Standard, Pro i 4K; Wan 3.0 dodaje poziom Prime. Wybieraj dla każdego ujęcia w ramach tej samej integracji.
Agenci i zadania wsadowe
Wywołuj każdy model z SDK Python lub JavaScript, zwykłego HTTP, CLI albo serwera MCP, dzięki czemu agenci kodujący i skrypty wsadowe korzystają z tych samych endpointów i cen co Twoja aplikacja.
Wskazówki
Wskazówki do promptów dla tych modeli
Praktyczne rady, jak uzyskiwać lepsze wyniki z tych modeli — oparte na wzorcach, które sprawdzają się w produkcyjnych pipeline'ach dla modeli wideo.
- 01
Precyzyjnie opisuj ruchy kamery
Używaj konkretnego słownictwa filmowego — orbit, dolly-in, push-in, pan-left, ujęcie z dźwigu, śledzenie z ręki. Ogólne prompty dają statyczną lub przypadkową kamerę; nazwane ruchy kamery bezpośrednio odpowiadają intencji ruchu w danych treningowych modelu i znacząco poprawiają jakość ujęcia.
- 02
Zakotwicz tożsamość postaci obrazami referencyjnymi
Jeśli prompt zależy od konkretnej osoby, postaci lub produktu, wgraj obraz referencyjny razem z promptem. Bez referencji tożsamość dryfuje między klatkami i ujęciami — ta sama postać przy każdym generowaniu wygląda trochę jak inna osoba.
- 03
Opisuj oświetlenie i porę dnia
Wskazówki świetlne, takie jak „golden hour, soft warm directional light” lub „overcast diffused light, slate-grey sky”, poprawiają jakość i spójność znacznie bardziej niż niejasne modyfikatory jakości. Oświetlenie to jedna z najsilniejszych wskazówek, na których opiera się model.
- 04
Używaj negatywnych promptów, by tłumić typowe błędy
Przydatne negatywy dla wideo: „frame flicker, motion blur, watermark, text artifacts, distorted hands, low resolution, jpeg compression”. Negatywne prompty nic nie kosztują i zauważalnie zmniejszają liczbę generacji, które musiałbyś powtarzać.
- 05
Wybierz najkrótszą długość, która oddaje Twój moment
Większość promptów działa najlepiej przy 5–8 sekundach. Dłuższe klipy wzmacniają niespójności czasowe (zmiana kształtu bohatera, dryf otoczenia). Jeśli potrzebujesz sekwencji 20-sekundowej, wygeneruj trzy klipy po 6–8 sekund i zmontuj je — jakość pozostaje wyższa niż przy jednym długim generowaniu.
- 06
Od razu dopasuj proporcje obrazu do platformy
9:16 dla TikToka / Reels / Shorts, 16:9 dla poziomych feedów i YouTube, 1:1 dla siatek postów. Modele trenują nieco inaczej dla każdych proporcji — przycięcie 16:9 do 9:16 po fakcie traci zarówno wierność, jak i kompozycję zamierzoną przez model.
Cennik
Cennik API WaveSpeedAI
Cena jest naliczana za wynik. Końcowa opłata zależy od parametrów ustawionych w playground każdego wariantu (rozdzielczość, czas trwania, liczba wyników, referencje).
API
Wywołaj API WaveSpeedAI
Uzyskaj klucz API na wavespeed.ai/accesskey, a następnie wyślij predykcję przez REST. Playground generuje gotowe do wklejenia przykłady dla dowolnej kombinacji danych wejściowych.
POSThttps://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5,
    "generate_audio": true
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": true
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": True
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)Porównanie
WaveSpeedAI a Higgsfield API
Czym różnią się WaveSpeedAI i Higgsfield API.
WaveSpeedAI a Higgsfield API: models
API Higgsfield wymienia 82 pozycje obrazu i wideo, w tym własne modele Soul i Cinema Studio oraz Seedance, Kling, Wan, MiniMax i Qwen Image. WaveSpeedAI obejmuje te rodziny zewnętrzne i dodaje Nano Banana, Seedream, GPT Image, Veo, dźwięk, 3D i modele językowe: łącznie ponad 1000.
WaveSpeedAI a Higgsfield API: credits
Środki w API Higgsfield wygasają rok po zakupie. Kredyty WaveSpeedAI nigdy nie wygasają i nie ma członkostwa ani subskrypcji: doładowujesz, gdy potrzebujesz, i płacisz za żądanie, z ceną każdego endpointu na stronie modelu i w tabeli cennika na tej stronie. Te same kredyty opłacają także studia w przeglądarce.
WaveSpeedAI a Higgsfield API: open models
Oba wymieniają MiniMax H3. W WaveSpeedAI to model open-weights hostowany przez WaveSpeedAI, z endpointami LoRA, referencja na wideo, edycji, rozszerzania i obrazu obok standardowego tekstu na wideo i obrazu na wideo.
FAQ
Higgsfield API Alternative — najczęściej zadawane pytania
Modele, cennik, migracja — typowe pytania o przejście z Higgsfield API na WaveSpeedAI.
Czy WaveSpeedAI jest alternatywą dla API Higgsfield?
Tak. WaveSpeedAI udostępnia Seedance 2.5 i 2.0, Kling 3.0 i O3, Wan 3.0, MiniMax H3 i Qwen Image 3.0 jako endpointy REST, a także Seedream 5.0, Nano Banana 2 i Pro oraz GPT Image 2.5 i 2 — z jednym kluczem API i rozliczeniem za żądanie.
Jakie modele mogę wywołać, których API Higgsfield nie wymienia?
Opublikowany katalog modeli API Higgsfield nie zawiera Nano Banana, Seedream, GPT Image, Veo ani modeli audio. W WaveSpeedAI Nano Banana 2 i Pro, Seedream 5.0, GPT Image 2.5 i 2, Veo 3.1 oraz głosy ElevenLabs są dostępne pod tym samym kluczem co modele wideo.
Jak przejść z API Higgsfield?
Utwórz klucz w /accesskey, a następnie wyślij POST z danymi wejściowymi jako JSON na https://api.wavespeed.ai/api/v3/<model> z nagłówkiem Authorization: Bearer. W odpowiedzi dostaniesz identyfikator predykcji; odpytuj https://api.wavespeed.ai/api/v3/predictions/<id>/result lub przekaż webhook. Dopasuj każdy model do jego ścieżki WaveSpeedAI z listy endpointów na tej stronie.
Czy MiniMax H3 w WaveSpeedAI to model open-weights?
Tak. Endpointy wavespeed-ai/minimax-h3 uruchamiają open-weights MiniMax H3 w WaveSpeedAI, w tym warianty LoRA dla własnych stylów i postaci, referencję na wideo, edycję i rozszerzanie wideo oraz tryb tekst na obraz.
Czy potrzebuję członkostwa lub subskrypcji i czy kredyty wygasają?
Bez członkostwa i bez subskrypcji. WaveSpeedAI działa w modelu pay as you go: doładowujesz kredyty, gdy ich potrzebujesz, i płacisz za żądanie według ceny widocznej na stronie każdego modelu i w tabeli cennika powyżej. Kredyty nigdy nie wygasają. Kwalifikujące się nowe konta otrzymują darmowe kredyty startowe.
Jak wywołać te API?
Załóż konto WaveSpeedAI, skopiuj klucz API z /accesskey, a następnie wyślij dane wejściowe jako JSON metodą POST na https://api.wavespeed.ai/api/v3/<model>, na przykład https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. Endpoint zwraca identyfikator predykcji. Odpytuj endpoint wyniku lub podaj webhook. Przykłady w Pythonie / Node.js / cURL znajdziesz powyżej.
Ile kosztują te API?
Endpointy na tej stronie zaczynają się od $0.02 za uruchomienie; cena każdego modelu jest w tabeli cennika powyżej i na jego stronie. Dokładny koszt zależy od ustawionych parametrów (rozdzielczość, czas trwania, liczba wyników, referencje), a playground pokazuje go przed wysłaniem.
Zacznij budować w WaveSpeedAI
Darmowe kredyty na start po rejestracji. Jeden klucz API do ponad 1000 modeli AI od wszystkich głównych dostawców.