Higgsfield API Alternative
I modelli che gli sviluppatori cercano nell'API Higgsfield — Seedance 2.5 e 2.0, Kling 3.0 e O3, Wan 3.0, MiniMax H3 open-weights e Qwen Image 3.0 — più Seedream 5.0, Nano Banana 2 e Pro, GPT Image 2.5 e 2, con un'unica chiave API WaveSpeedAI. Paghi a consumo: i crediti non scadono mai e non c'è alcun abbonamento né iscrizione.
Stai valutando l'API Higgsfield? Ogni endpoint qui sotto è attivo oggi su WaveSpeedAI, con un playground, esempi e il prezzo attuale per esecuzione. Ricarica una volta e usa i tuoi crediti quando vuoi — non scadono mai — su questi modelli e su oltre 1.000 altri modelli di immagini, video, audio, 3D e linguaggio.
Panoramica
Informazioni su Higgsfield API Alternative
Cosa puoi richiamare su WaveSpeedAI se stai valutando Higgsfield API.
I modelli che gli sviluppatori cercano nell'API Higgsfield — Seedance 2.5 e 2.0, Kling 3.0 e O3, Wan 3.0, MiniMax H3 open-weights e Qwen Image 3.0 — più Seedream 5.0, Nano Banana 2 e Pro, GPT Image 2.5 e 2, con un'unica chiave API WaveSpeedAI. Paghi a consumo: i crediti non scadono mai e non c'è alcun abbonamento né iscrizione.
Stai valutando l'API Higgsfield? Ogni endpoint qui sotto è attivo oggi su WaveSpeedAI, con un playground, esempi e il prezzo attuale per esecuzione. Ricarica una volta e usa i tuoi crediti quando vuoi — non scadono mai — su questi modelli e su oltre 1.000 altri modelli di immagini, video, audio, 3D e linguaggio.
Gli endpoint qui sotto sono 37 endpoint REST attivi di WaveSpeedAI per questi modelli, che coprono i flussi di lavoro Text-To-Video, Image-To-Video, Image-Tools, Text-To-Image, Image-To-Image. Ognuno ha il suo playground, i suoi prezzi e i suoi esempi, e tutti si richiamano allo stesso modo: POST di un JSON, ricevi un id di predizione, poi fai polling o ricevi un webhook.
Condividono un'unica chiave API, un unico saldo e un'unica integrazione con gli altri oltre 1.000 modelli di WaveSpeedAI, dal text-to-image e text-to-video ad audio, 3D, upscaling, editing e modelli linguistici.
Endpoint
Tutti gli endpoint API WaveSpeedAI
37 endpoint disponibili ora su WaveSpeedAI: scegli la variante più adatta al tuo flusso di lavoro.
Seedance 2.5 Text To Video Turbo
Seedance 2.5 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Text To Video
Seedance 2.5 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
Seedance 2.5 Image To Video Turbo
Seedance 2.5 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Image To Video
Seedance 2.5 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Seedance 2.0 Text To Video Turbo
Seedance 2.0 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.0 Text To Video
Seedance 2.0 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
Seedance 2.0 Image To Video Turbo
Seedance 2.0 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.0 Image To Video
Seedance 2.0 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Kling v3.0 Pro Text To Video
Kling 3.0 Pro delivers top-tier text-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling v3.0 Pro Image To Video
Kling 3.0 Pro delivers top-tier image-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling Video O3 Pro Text To Video
Kling Omni Video O3 is Kuaishou's advanced unified multi-modal video model with MVL (Multi-modal Visual Language) technology. Text-to-Video mode generates cinematic videos from text prompts with subject consistency, natural physics simulation, and precise semantic understanding. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
Kling Video O3 Pro Image To Video
Kling Omni Video O3 Image-to-Video transforms static images into dynamic cinematic videos using MVL (Multi-modal Visual Language) technology. Maintains subject consistency while adding natural motion, physics simulation, and seamless scene dynamics. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
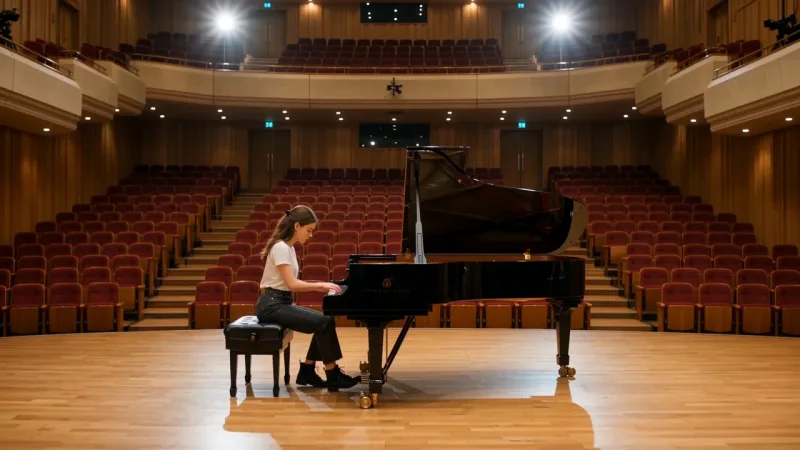
Wan 3.0 Text To Video
Wan 3.0 Text to Video generates cinematic videos from text prompts, with flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality video generation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
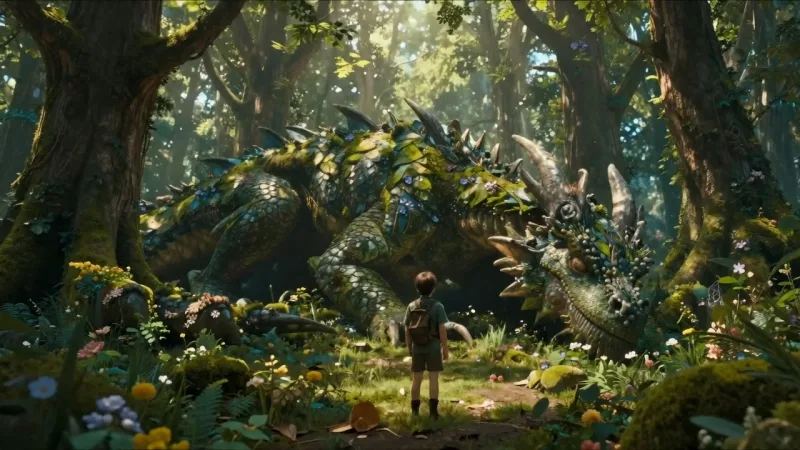
Wan 3.0 Image To Video
Wan 3.0 Image to Video animates a first-frame image into a cinematic video, with optional last-frame guidance, flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality motion and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
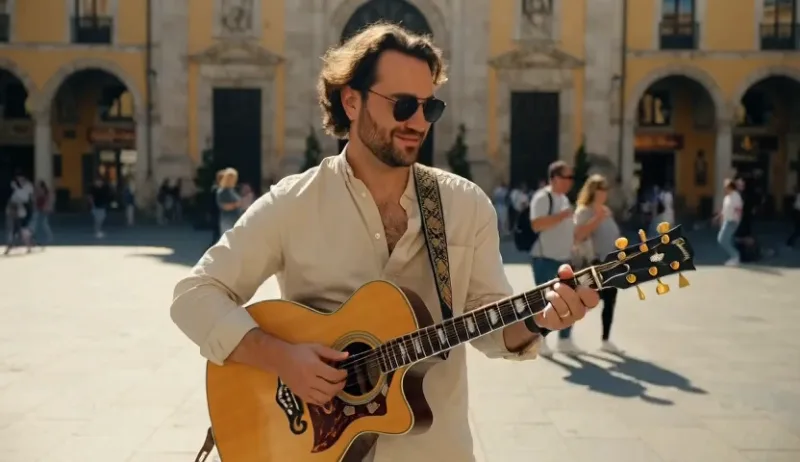
Minimax H3 Text To Video Lora
MiniMax H3 Open Weights Text to Video with custom LoRA support generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
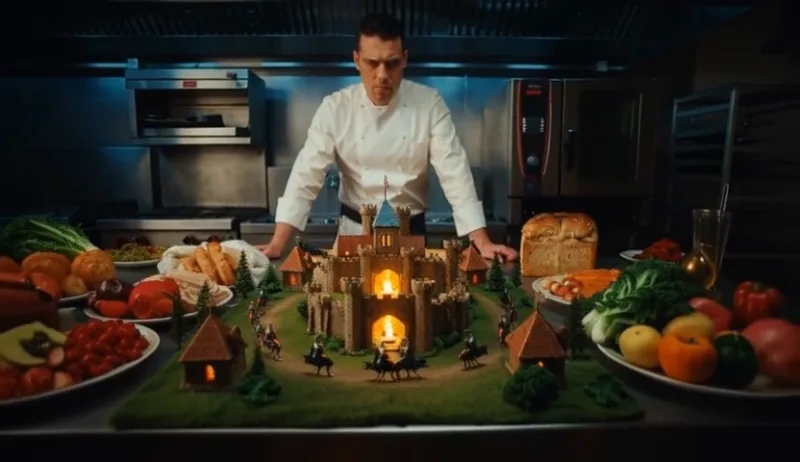
Minimax H3 Text To Video
MiniMax H3 Open Weights Text to Video generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video Lora
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro Layer Decomposition
Seedream V5.0 Pro Layer Decomposition separates a single image into a base image and transparent layers, enabling flexible compositing, image editing, asset extraction, and layered design workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro
Seedream V5.0 Pro Text to Image by ByteDance generates high-quality images from text prompts, with aspect ratio selection, strong prompt following, and 1K / 2K output tiers for flexible image creation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
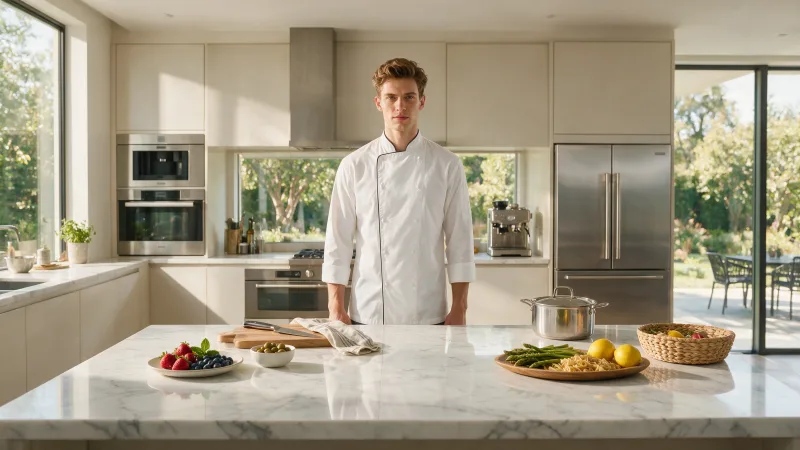
Seedream v5.0 Pro Edit
Seedream V5.0 Pro Edit by ByteDance edits and generates images from single-image or multi-reference inputs, supporting up to 10 reference images, aspect ratio selection, and 1K / 2K output tiers. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
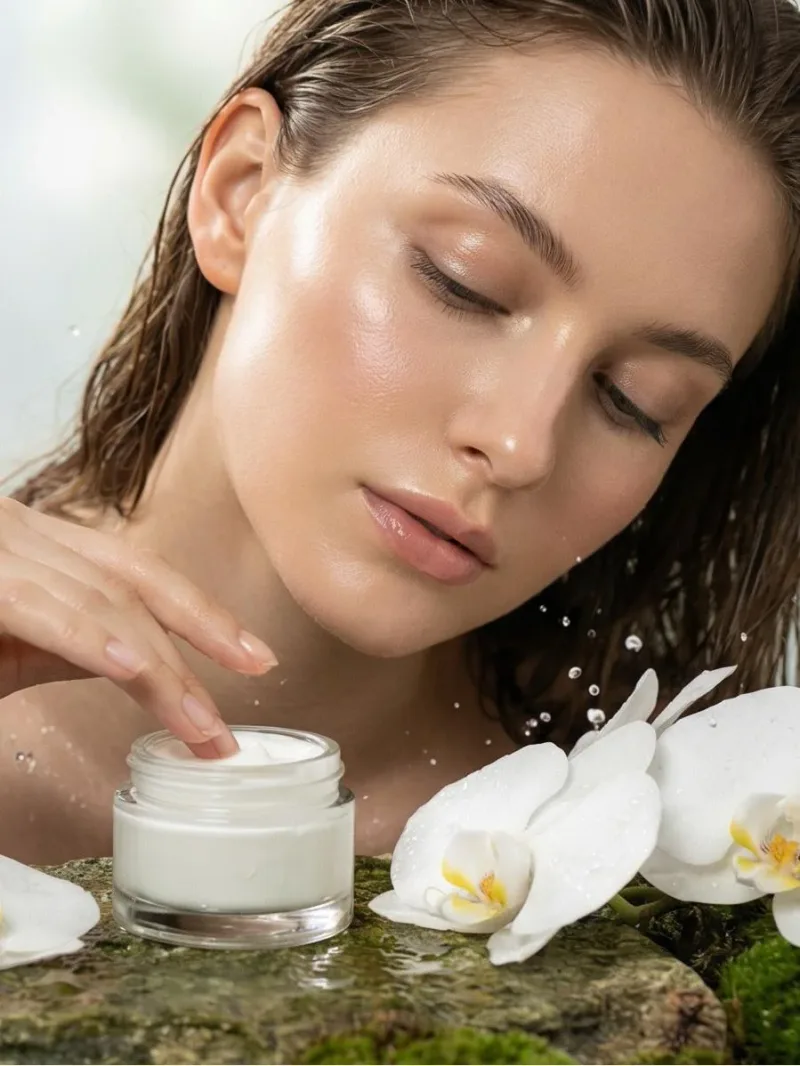
Nano Banana Pro Text To Image Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a next-generation text-to-image model capable of generating multiple high-quality images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
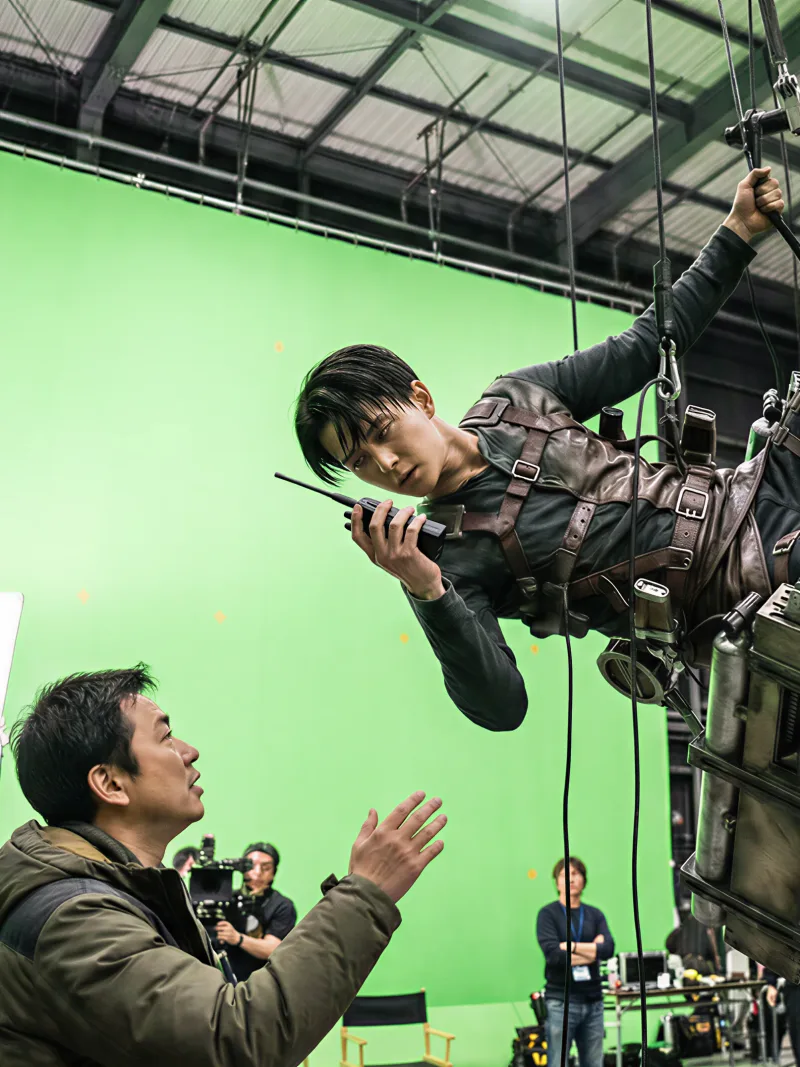
Nano Banana Pro Text To Image Ultra
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
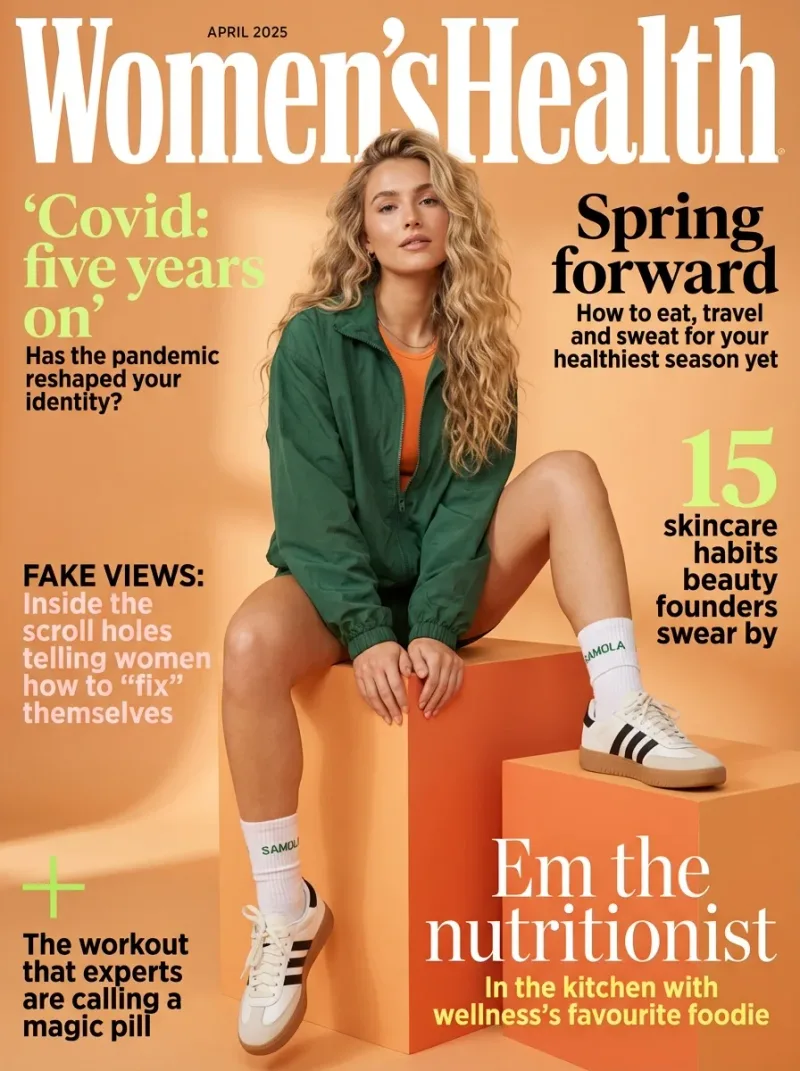
Nano Banana Pro Text To Image
Google's Nano Banana pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res 4K image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) Edit is a next-generation image editing model capable of generating multiple high-quality edited images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Ultra
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with highres output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with 4K-capable output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image Fast
Google Nano Banana 2 Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 option, starting at just $0.045 per image. Delivers fast text-to-image generation with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image
Google Nano Banana 2 (Gemini 3.1 Flash Image) delivers Pro-quality image generation at Flash speed with 512px to 4K resolution support. Features include improved text rendering, character consistency for up to 5 characters, and real-world knowledge integration. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit Fast
Google Nano Banana 2 Edit Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 editing option, starting at just $0.045 per image. Enables fast image editing with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit
Google Nano Banana 2 Edit (Gemini 3.1 Flash Image) enables advanced image editing with 4K-capable output, fast iteration, and precise instruction following. Supports text translation, localization within images, and maintains subject consistency during edits. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Edit
OpenAI's GPT Image 2.5 Sunburst Edit edits one or more reference images from natural-language instructions, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Text To Image
OpenAI's GPT Image 2.5 Sunburst Text-to-Image generates high-quality images from natural-language prompts, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Text To Image
OpenAI's GPT Image 2 Text-to-Image generates high-quality images from natural-language prompts. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2 Edit
OpenAI's GPT Image 2 Edit enables image editing from natural-language instructions with one or more reference images. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Text To Image
Qwen Image 3.0 Text to Image is a high-quality image generation model that creates high-quality images from text prompts, with advanced prompt understanding, strong visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Edit
Qwen Image 3.0 Edit is a high-quality image editing model that transforms existing images with natural-language instructions, delivering advanced instruction understanding, superior visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Esempi
WaveSpeedAI in azione
Output reali generati dall'API WaveSpeedAI. Passa il mouse su un video per l'anteprima, clicca per aprire il visualizzatore a schermo intero.
Guida
Come usare l'API WaveSpeedAI
Quattro passaggi dalla registrazione alla generazione completata. Esempi completi in Python, Node.js e cURL sono nella sezione API qui sotto.
- 01
Ottieni una chiave API
Registrati su WaveSpeedAI e copia la tua chiave API dalla dashboard. I nuovi account includono crediti gratuiti di benvenuto: bastano per usare il playground qualche decina di volte prima che inizi la fatturazione.
- 02
Invia una predizione
Invia con POST il tuo input in formato JSON a https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. L'endpoint restituisce subito un id di predizione: le generazioni sono asincrone, quindi non devi tenere una connessione aperta durante l'inferenza.
- 03
Controlla il completamento
Fai GET su https://api.wavespeed.ai/api/v3/predictions/{request_id}/result. Restituisci gli output con completed; interrompi con un errore con failed, cancelled, timeout o deleted; continua il polling per ogni altro stato.
- 04
Leggi l'URL dell'output
Quando lo stato è "completed", leggi l'URL da data.outputs[0]. L'URL punta al tuo contenuto generato sulla CDN di WaveSpeedAI: immagine, video, audio o file 3D a seconda della variante del modello che hai richiamato.
Casi d'uso
Cosa puoi creare con questi modelli
I flussi di lavoro più comuni per cui sviluppatori e creator usano queste API.
Sposta un'integrazione con l'API Higgsfield in un pomeriggio
Entrambe le API sono asincrone: invii un JSON, ricevi un id della richiesta, poi fai polling o ricevi un webhook. Su WaveSpeedAI invii con POST a /api/v3/<model> con una chiave API Bearer e leggi il risultato della predizione, quindi il porting consiste soprattutto nel cambiare URL di base, header di autenticazione e percorso del modello.
Immagini e video in un'unica pipeline
Genera immagini statiche con Nano Banana Pro, Seedream 5.0 o GPT Image 2.5, poi animale con l'image-to-video di Seedance 2.5, Kling 3.0 o Wan 3.0, con una sola chiave e un solo saldo. Il catalogo pubblicato dell'API Higgsfield non include Nano Banana, Seedream né GPT Image.
MiniMax H3 open-weights con LoRA
WaveSpeedAI ospita MiniMax H3 open-weights con text-to-video, image-to-video, reference-to-video, video edit ed extend, endpoint LoRA per stili e personaggi personalizzati e una modalità text-to-image.
Piani sequenza lunghi e video a livelli
Seedance 2.5 renderizza piani sequenza fino a 30 secondi con audio nativo; Kling 3.0 e Kling O3 sono disponibili nei livelli Standard, Pro e 4K; Wan 3.0 aggiunge un livello Prime. Scegli per ogni inquadratura dalla stessa integrazione.
Agenti e job in batch
Chiama ogni modello dagli SDK Python o JavaScript, con HTTP semplice, dalla CLI o da un server MCP, così gli agenti di coding e gli script batch usano gli stessi endpoint e gli stessi prezzi della tua app.
Consigli
Consigli per scrivere i prompt per questi modelli
Consigli pratici per ottenere output migliori da questi modelli, ricavati dagli schemi che funzionano con i modelli video nelle pipeline di produzione.
- 01
Sii specifico sui movimenti di camera
Cita un vocabolario cinematografico concreto — orbit, dolly-in, push-in, pan-left, crane shot, handheld follow. I prompt generici producono scelte di camera statiche o arbitrarie; i movimenti di camera con un nome si traducono direttamente nell'intento di movimento nei dati di addestramento del modello e migliorano drasticamente la qualità dell'inquadratura.
- 02
Ancora l'identità del personaggio con immagini di riferimento
Se il tuo prompt dipende da una persona, un personaggio o un prodotto specifico, carica un'immagine di riferimento insieme al prompt. Senza riferimento, l'identità deriva tra i frame e tra le inquadrature — lo stesso personaggio finisce per sembrare una persona leggermente diversa a ogni generazione.
- 03
Descrivi illuminazione e ora del giorno
Indicazioni di luce come «golden hour, luce direzionale calda e morbida» o «luce diffusa da cielo coperto, cielo grigio ardesia» migliorano qualità e coerenza molto più di vaghi modificatori di qualità. L'illuminazione è uno dei prior più forti su cui il modello si condiziona.
- 04
Usa i prompt negativi per sopprimere i difetti più comuni
Negativi utili per il video: «frame flicker, motion blur, watermark, text artifacts, distorted hands, low resolution, jpeg compression». I prompt negativi non costano nulla e riducono sensibilmente la quota di generazioni che altrimenti rilanceresti.
- 05
Scegli la durata più breve che cattura il tuo momento
La maggior parte dei prompt funziona meglio a 5-8 secondi. Le clip più lunghe amplificano le incoerenze temporali (soggetto che cambia forma, deriva dell'ambiente). Se ti serve una sequenza di 20 secondi, genera tre clip da 6-8 secondi e montale insieme — la qualità resta più alta che con una sola generazione lunga.
- 06
Adatta subito le proporzioni alla piattaforma
9:16 per TikTok / Reels / Shorts, 16:9 per i feed orizzontali e YouTube, 1:1 per le griglie dei post. I modelli si addestrano in modo leggermente diverso per ogni proporzione — ritagliare un 16:9 in 9:16 a posteriori fa perdere sia la fedeltà sia la composizione che il modello aveva previsto.
Prezzi
Prezzi dell'API WaveSpeedAI
Il prezzo è per output. L'addebito finale dipende dai parametri impostati nel playground di ciascuna variante (risoluzione, durata, numero di output, riferimenti).
API
Richiama l'API WaveSpeedAI
Ottieni una chiave API su wavespeed.ai/accesskey, poi invia una predizione tramite REST. Il playground genera esempi pronti da incollare per qualsiasi combinazione di input.
POSThttps://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5,
    "generate_audio": true
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": true
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": True
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)Confronto
WaveSpeedAI a confronto con Higgsfield API
In cosa differiscono WaveSpeedAI e Higgsfield API.
WaveSpeedAI vs Higgsfield API: models
L'API Higgsfield elenca 82 voci tra immagini e video, inclusi i propri modelli Soul e Cinema Studio più Seedance, Kling, Wan, MiniMax e Qwen Image. WaveSpeedAI copre quelle famiglie di terze parti e aggiunge Nano Banana, Seedream, GPT Image, Veo, audio, 3D e modelli di linguaggio: oltre 1.000 in totale.
WaveSpeedAI vs Higgsfield API: credits
I fondi dell'API Higgsfield scadono un anno dopo l'acquisto. I crediti WaveSpeedAI non scadono mai e non c'è alcun abbonamento né iscrizione: ricarichi quando serve e paghi per richiesta, con il prezzo di ogni endpoint nella pagina del modello e nella tabella dei prezzi di questa pagina. Gli stessi crediti pagano anche gli studio nel browser.
WaveSpeedAI vs Higgsfield API: open models
Entrambi elencano MiniMax H3. Su WaveSpeedAI è il modello open-weights ospitato da WaveSpeedAI, con LoRA, reference-to-video, edit, extend ed endpoint per immagini accanto ai standard text-to-video e image-to-video.
FAQ
Higgsfield API Alternative — Domande frequenti
Modelli, prezzi, migrazione: le domande più comuni sul passaggio da Higgsfield API a WaveSpeedAI.
WaveSpeedAI è un'alternativa all'API Higgsfield?
Sì. WaveSpeedAI offre Seedance 2.5 e 2.0, Kling 3.0 e O3, Wan 3.0, MiniMax H3 e Qwen Image 3.0 come endpoint REST, più Seedream 5.0, Nano Banana 2 e Pro, GPT Image 2.5 e 2, con una sola chiave API e prezzi a richiesta.
Quali modelli posso chiamare che l'API Higgsfield non elenca?
Il catalogo pubblicato dei modelli dell'API Higgsfield non include Nano Banana, Seedream, GPT Image, Veo né modelli audio. Su WaveSpeedAI, Nano Banana 2 e Pro, Seedream 5.0, GPT Image 2.5 e 2, Veo 3.1 e le voci ElevenLabs si trovano dietro la stessa chiave dei modelli video.
Come passo dall'API Higgsfield a WaveSpeedAI?
Crea una chiave su /accesskey, poi invia il tuo input come JSON con POST a https://api.wavespeed.ai/api/v3/<model> con un header Authorization: Bearer. Riceverai un id di predizione; fai polling su https://api.wavespeed.ai/api/v3/predictions/<id>/result oppure passa un webhook. Associa ogni modello al suo percorso WaveSpeedAI dall'elenco degli endpoint in questa pagina.
MiniMax H3 su WaveSpeedAI è il modello open-weights?
Sì. Gli endpoint wavespeed-ai/minimax-h3 eseguono MiniMax H3 open-weights su WaveSpeedAI, incluse varianti LoRA per stili e personaggi personalizzati, reference-to-video, video edit ed extend e una modalità text-to-image.
Serve un abbonamento o un'iscrizione e i crediti scadono?
Nessuna iscrizione e nessun abbonamento. WaveSpeedAI è a consumo: ricarichi i crediti quando ti servono e paghi per richiesta al prezzo indicato nella pagina di ogni modello e nella tabella dei prezzi qui sopra. I crediti non scadono mai. I nuovi account idonei ricevono crediti iniziali gratuiti.
Come richiamo queste API?
Registrati su WaveSpeedAI, copia la tua chiave API da /accesskey, poi invia con POST il tuo input in formato JSON a https://api.wavespeed.ai/api/v3/<model>, ad esempio https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. L'endpoint restituisce un id di predizione. Fai polling sull'endpoint dei risultati oppure passa un webhook. Gli esempi in Python / Node.js / cURL sono qui sopra.
Quanto costano queste API?
Gli endpoint di questa pagina partono da $0.02 per esecuzione; il prezzo di ogni modello è indicato nella tabella dei prezzi qui sopra e nella sua pagina del modello. Il costo esatto dipende dai parametri impostati (risoluzione, durata, numero di output, riferimenti) e il playground lo mostra prima dell'invio.
Inizia a creare su WaveSpeedAI
Crediti gratuiti di benvenuto alla registrazione. Una sola chiave API per oltre 1.000 modelli AI di tutti i principali provider.