L'IA média,
à une requête près
Des API rapides et abordables, payées à la requête, pour Seedance 2.5, Nano Banana Pro, MiniMax H3 et le reste du haut de gamme, plus des studios et des outils en un clic pour toute votre équipe. Rien à régler ni à héberger.
Alternative à Runware
Saisissez un prompt et lancez-le sur les derniers modèles. Ce qui fonctionne ici passe à l'API au même prix.
Pourquoi les équipes quittent Runware
Rapide.
Une inférence ultra-rapide sur chaque modèle. Vos images et vidéos arrivent vite, dans le studio comme via l'API.
Abordable.
Images à partir de $0.024, vidéos à partir de $0.02 par exécution. Ne payez que ce que vous générez, sans abonnement ni frais mensuels.
- Créateurs de modèles
- 44
- Modèles de langage
- 128+
- Studios de modèles
- 14
- Outils et apps prêts à l'emploi
- 36
Des studios pour toute l'équipe
Des générateurs dans le navigateur pour l'image, la vidéo, l'audio et la 3D : designers et marketeurs produisent avec les mêmes modèles et crédits que votre API.
Runware : Un playground web pour tester les modèles en parallèle de son API.
Des outils finis, pas seulement des modèles
Upscaling, suppression d'arrière-plan et de filigrane, face swap, montage vidéo par IA et modèles publicitaires en un clic. Chacun est aussi un simple appel d'API.
Runware : Conçu autour de l'inférence de modèles et de la puissance GPU brute sur laquelle vous construisez.
Sélectionnés avec soin, prêts pour la production
Seedance 2.5, Nano Banana Pro, MiniMax H3, Rodin et d'autres des meilleurs labos, chacun avec son schéma, ses exemples, son prix en direct et son propre playground.
Runware : Des centaines de milliers de modèles hébergés, partenaires, communautaires et importés sous un même schéma d'adressage.
Zéro réglage. Zéro hébergement.
Choisissez un modèle, envoyez un prompt, c'est fait. Les paramètres par défaut sont déjà optimisés, et il n'y a ni VAE, ni conteneurs, ni GPU à surveiller.
Runware : Sur les modèles ouverts, vous contrôlez chaque paramètre et pouvez exécuter vos propres modèles et conteneurs sur ses GPU.
Modèles phares, prêts à appeler
Parcourir tous les modèles
Seedance 2.5
bytedance/seedance-2.5/text-to-video
Texte vers vidéo
$0.324 / exécution
MiniMax H3
minimax/h3/image-to-video
Image vers vidéo
$0.10 / exécution
Grok Imagine 1.5
x-ai/grok-imagine-video-v1.5/image-to-video
Image vers vidéo
$0.14 / exécution
Qwen Image 3.0
alibaba/qwen-image-3.0/text-to-image
Texte vers image
$0.03 / exécution
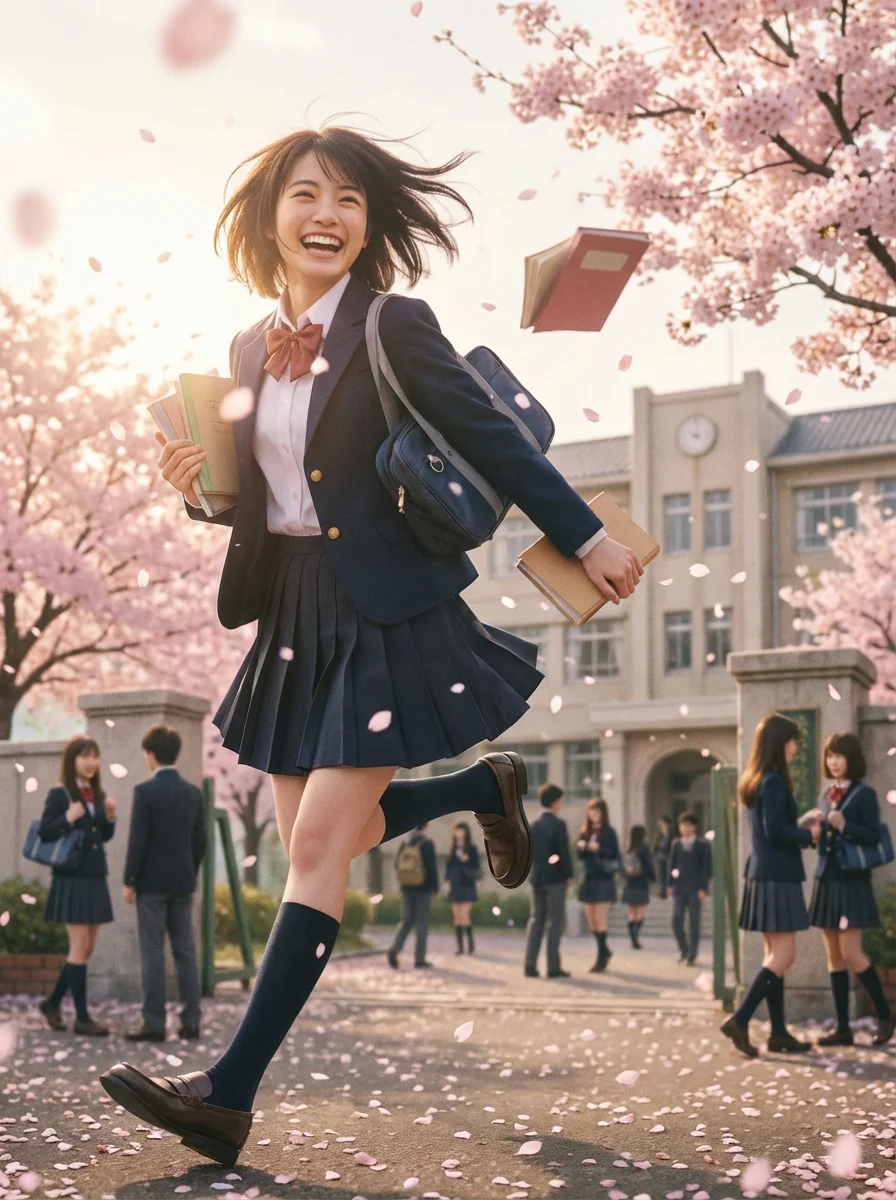
Nano Banana Pro
google/nano-banana-pro/edit
Retouche d'image
$0.126 / exécution
Video Upscaler Pro
wavespeed-ai/video-upscaler-pro
Upscaling
$0.04 / exécution
MiniMax Speech 2.6 HD
minimax/speech-2.6-hd
Synthèse vocale
$0.10 / exécution
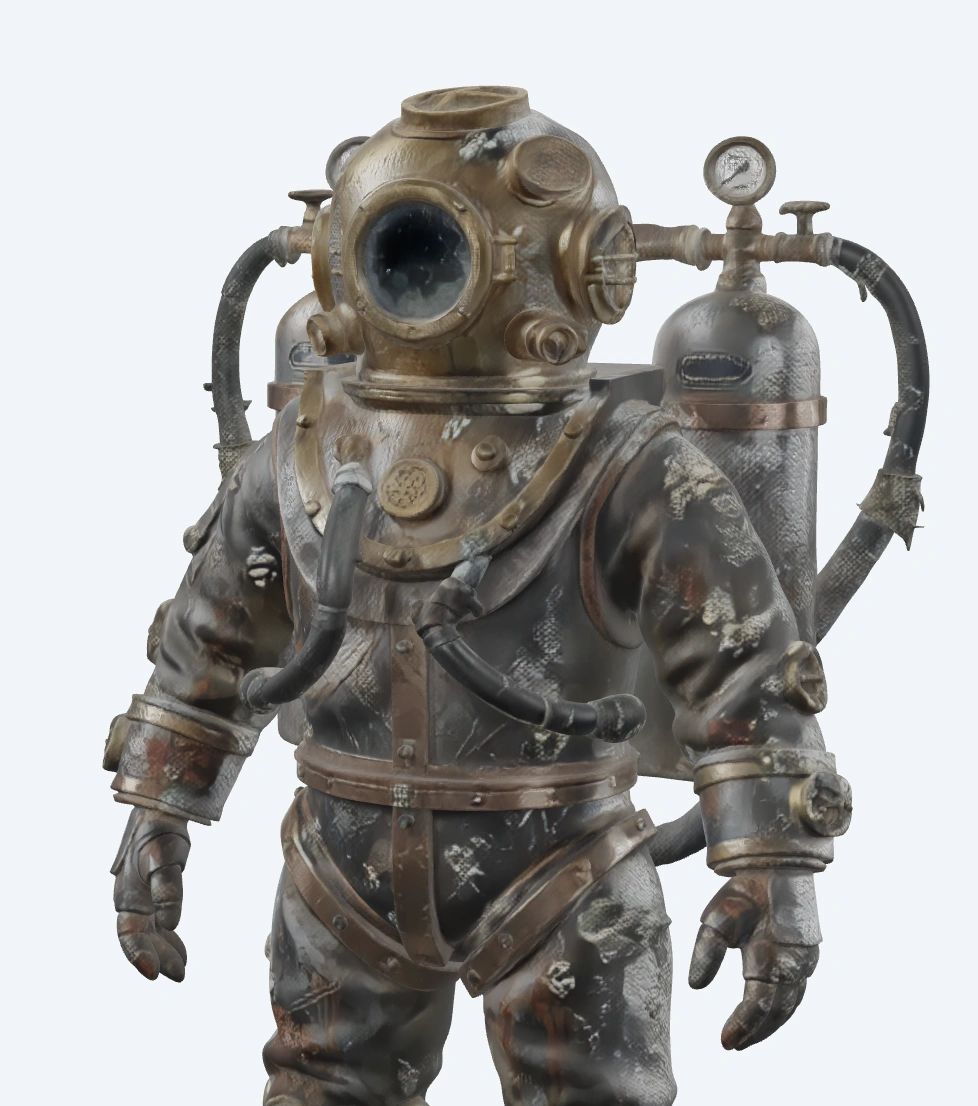
Rodin Gen-2.5
hyper3d/rodin-v2.5/image-to-3d
Image vers 3D
$0.48 / exécution
● Un seul format de requête
Envoyez. Interrogez. Livrez.
Un même flux pour tous les modèles : du JSON en entrée, une prédiction en sortie. Interrogez le résultat ou enregistrez un webhook. SDK Python et JavaScript, ou n'importe quel client HTTP. Apprenez-le une fois.
POSThttps://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video
curl -X POST "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "prompt": "A drone shot over a misty pine forest at sunrise",
  "duration": 5,
  "resolution": "720p",
  "aspect_ratio": "16:9"
}'

# → {"data": {"id": "<prediction id>", ...}}
curl "https://api.wavespeed.ai/api/v3/predictions/<prediction id>/result" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY"
import os, time, requests
headers = {"Authorization": f"Bearer {os.environ['WAVESPEED_API_KEY']}"}
task = requests.post("https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video", headers=headers, json={
"prompt": "A drone shot over a misty pine forest at sunrise",
"duration": 5,
"resolution": "720p",
"aspect_ratio": "16:9"
}).json()["data"]
while True:
result = requests.get(f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result", headers=headers).json()["data"]
if result["status"] == "completed":
print(result["outputs"])
break
if result["status"] == "failed":
raise RuntimeError(result.get("error"))
time.sleep(2)const headers = { Authorization: `Bearer ${process.env.WAVESPEED_API_KEY}`, 'Content-Type': 'application/json' }
const { data: task } = await fetch('https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video', {
method: 'POST',
headers,
body: JSON.stringify({
"prompt": "A drone shot over a misty pine forest at sunrise",
"duration": 5,
"resolution": "720p",
"aspect_ratio": "16:9"
}),
}).then((r) => r.json())
while (true) {
const { data: result } = await fetch(`https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`, { headers }).then((r) => r.json())
if (result.status === 'completed') { console.log(result.outputs); break }
if (result.status === 'failed') throw new Error(result.error)
await new Promise((r) => setTimeout(r, 2000))
}Généré sur WaveSpeedAI
WaveSpeedAI vs Runware
| WaveSpeedAI | Runware | |
|---|---|---|
| API de modèles | Endpoints image, vidéo, audio, 3D et LLM | Endpoints image, vidéo, audio, 3D et LLM |
| Facturation | Paiement à l'usage, prix affiché par exécution, sans frais mensuels | Paiement à l'usage, sans contrat |
| Calcul brut | Non proposé : les modèles sont entièrement gérés | Puissance GPU pour vos propres charges d'inférence |
| Modèles personnalisés | Modèles hébergés et sélectionnés, rien à importer ni à configurer | Modèles hébergés, communautaires et importés sur un même endpoint |
| Essai dans le navigateur | Studios image, vidéo, audio et 3D, plus un playground par modèle | Playground web |
| Intégration | REST : envoi, puis interrogation ou réception d'un webhook | REST ou WebSockets, avec webhooks par tâche |
FAQ
WaveSpeedAI est-il une bonne alternative à Runware ?
Si vous voulez des modèles image, vidéo, audio et 3D prêts à appeler, payés à la requête avec une seule clé API, oui. Et vous pouvez tester chaque modèle dans le navigateur avant d'écrire la moindre ligne de code.
Comment l'utilisation est-elle facturée ?
Chaque modèle affiche un prix par exécution sur sa page. Paiement à la requête, sans frais mensuels ni engagement.
Comment l'intégrer ?
Envoyez du JSON en POST à https://api.wavespeed.ai/api/v3/<model> avec votre clé API, puis interrogez le résultat ou fournissez un webhook. Avec les SDK wavespeed pour Python et JavaScript, cela tient en quelques lignes.
Puis-je essayer avant d'intégrer ?
Bien sûr. Utilisez la zone de prompt ci-dessus ou n'importe quel studio dans le navigateur. Les nouveaux comptes éligibles reçoivent $1 de crédits offerts, et aucune carte n'est requise pour s'inscrire.
Votre première requête n'est qu'à un POST
$1 de crédits offerts pour les nouveaux comptes éligibles. Sans carte bancaire.