Higgsfield API Alternative
Los modelos que los desarrolladores buscan en la API de Higgsfield (Seedance 2.5 y 2.0, Kling 3.0 y O3, Wan 3.0, MiniMax H3 de pesos abiertos y Qwen Image 3.0), además de Seedream 5.0, Nano Banana 2 y Pro, y GPT Image 2.5 y 2, con una sola clave de API de WaveSpeedAI. Pago por uso: los créditos no caducan y no hay membresía ni suscripción.
¿Estás evaluando la API de Higgsfield? Todos los endpoints de más abajo están activos hoy en WaveSpeedAI, con playground, ejemplos y su precio actual por ejecución. Recarga una vez y usa tus créditos cuando quieras (no caducan) en estos modelos y en más de 1.000 modelos de imagen, vídeo, audio, 3D y lenguaje.
Resumen
Acerca de Higgsfield API Alternative
Qué puedes llamar en WaveSpeedAI si estás evaluando Higgsfield API.
Los modelos que los desarrolladores buscan en la API de Higgsfield (Seedance 2.5 y 2.0, Kling 3.0 y O3, Wan 3.0, MiniMax H3 de pesos abiertos y Qwen Image 3.0), además de Seedream 5.0, Nano Banana 2 y Pro, y GPT Image 2.5 y 2, con una sola clave de API de WaveSpeedAI. Pago por uso: los créditos no caducan y no hay membresía ni suscripción.
¿Estás evaluando la API de Higgsfield? Todos los endpoints de más abajo están activos hoy en WaveSpeedAI, con playground, ejemplos y su precio actual por ejecución. Recarga una vez y usa tus créditos cuando quieras (no caducan) en estos modelos y en más de 1.000 modelos de imagen, vídeo, audio, 3D y lenguaje.
Los endpoints de abajo son 37 endpoints REST de WaveSpeedAI en producción para estos modelos, que cubren flujos de Text-To-Video, Image-To-Video, Image-Tools, Text-To-Image, Image-To-Image. Cada uno tiene su propio playground, precios y ejemplos, y todos se llaman de la misma forma: POST con JSON, recibes un id de predicción y haces polling o recibes un webhook.
Comparten una sola clave de API, un solo saldo y una sola integración con los demás más de 1.000 modelos de WaveSpeedAI, desde texto a imagen y texto a vídeo hasta audio, 3D, escalado, edición y modelos de lenguaje.
Endpoints
Todos los endpoints de la API de WaveSpeedAI
37 endpoints disponibles ahora en WaveSpeedAI: elige la variante que se ajuste a tu flujo de trabajo.
Seedance 2.5 Text To Video Turbo
Seedance 2.5 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Text To Video
Seedance 2.5 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
Seedance 2.5 Image To Video Turbo
Seedance 2.5 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
Seedance 2.5 Image To Video
Seedance 2.5 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
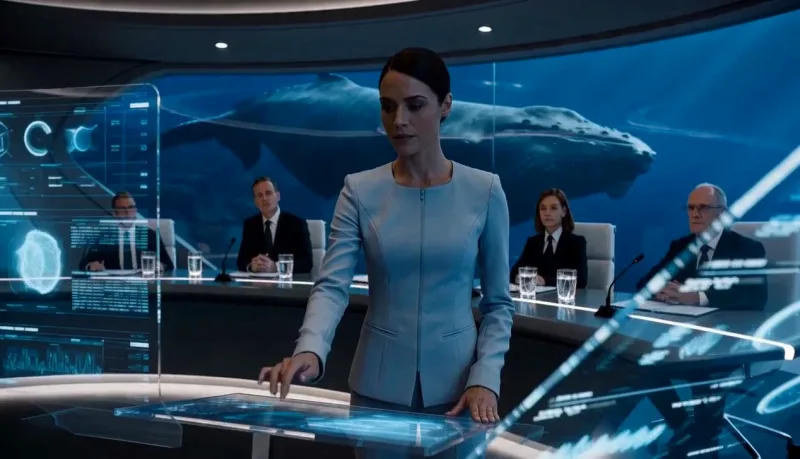
Seedance 2.0 Text To Video Turbo
Seedance 2.0 (Text-to-Video Turbo) generates cinematic 720p/1080p videos from text prompts —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
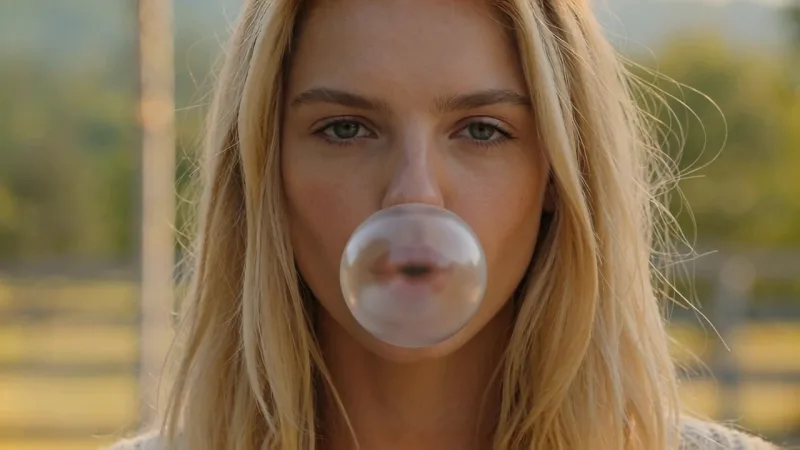
Seedance 2.0 Text To Video
Seedance 2.0 (Text-to-Video) generates Hollywood-grade cinematic videos from text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it leads on instruction adherence, motion quality, and visual aesthetics.
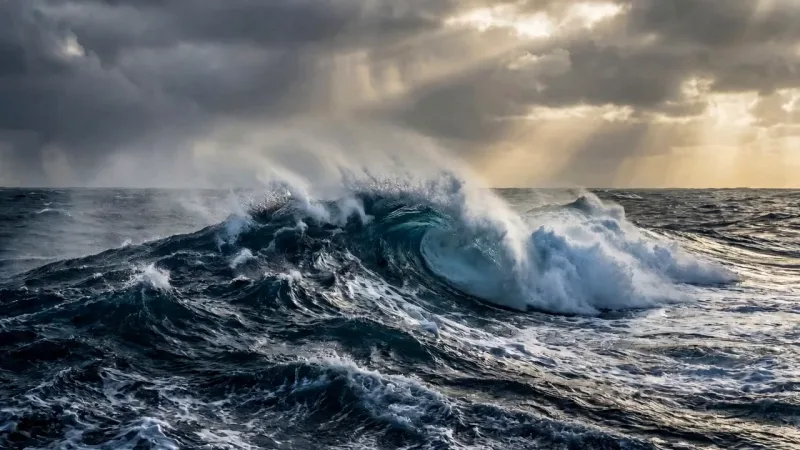
Seedance 2.0 Image To Video Turbo
Seedance 2.0 (Image-to-Video Turbo) generates cinematic 720p/1080p videos from reference images —a faster, more affordable high-resolution tier with native audio-visual synchronization, director-level control, and exceptional motion stability.
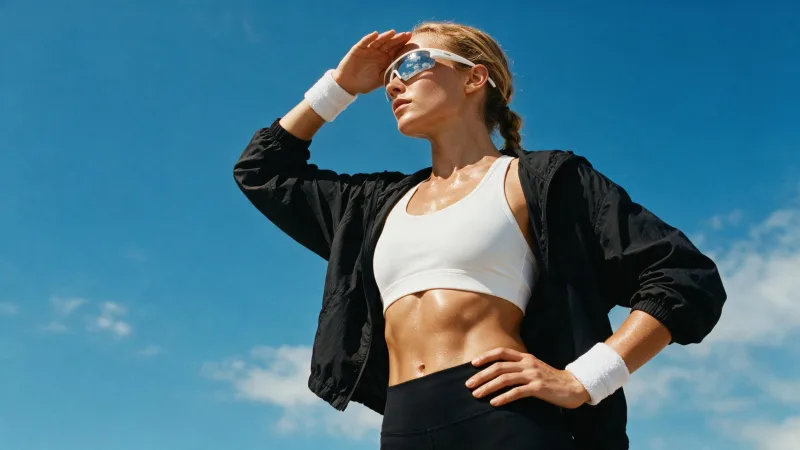
Seedance 2.0 Image To Video
Seedance 2.0 (Image-to-Video) generates Hollywood-grade cinematic videos from reference images and text prompts with native audio-visual synchronization, director-level camera and lighting control, and exceptional motion stability. Built on Seed's unified multimodal architecture, it preserves the input image's subject and composition while adding expressive, physically accurate motion.
Kling v3.0 Pro Text To Video
Kling 3.0 Pro delivers top-tier text-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling v3.0 Pro Image To Video
Kling 3.0 Pro delivers top-tier image-to-video generation with smooth motion, cinematic visuals, accurate prompt adherence, and native audio for ready-to-share clips. Ready-to-use REST inference API, best performance, no cold starts, affordable pricing.
Kling Video O3 Pro Text To Video
Kling Omni Video O3 is Kuaishou's advanced unified multi-modal video model with MVL (Multi-modal Visual Language) technology. Text-to-Video mode generates cinematic videos from text prompts with subject consistency, natural physics simulation, and precise semantic understanding. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
Kling Video O3 Pro Image To Video
Kling Omni Video O3 Image-to-Video transforms static images into dynamic cinematic videos using MVL (Multi-modal Visual Language) technology. Maintains subject consistency while adding natural motion, physics simulation, and seamless scene dynamics. Supports audio generation. Ready-to-use REST API, best performance, no coldstarts, affordable pricing.
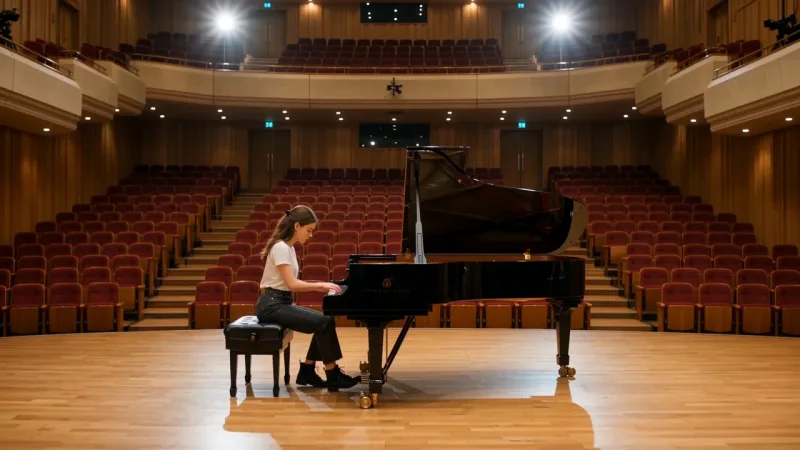
Wan 3.0 Text To Video
Wan 3.0 Text to Video generates cinematic videos from text prompts, with flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality video generation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
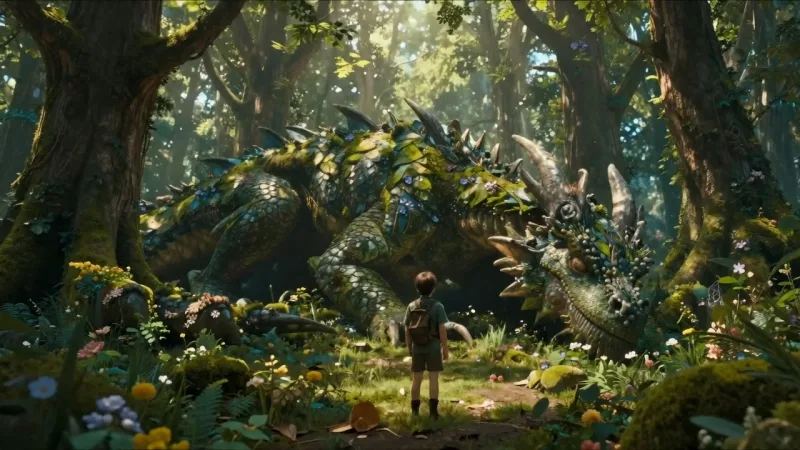
Wan 3.0 Image To Video
Wan 3.0 Image to Video animates a first-frame image into a cinematic video, with optional last-frame guidance, flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality motion and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
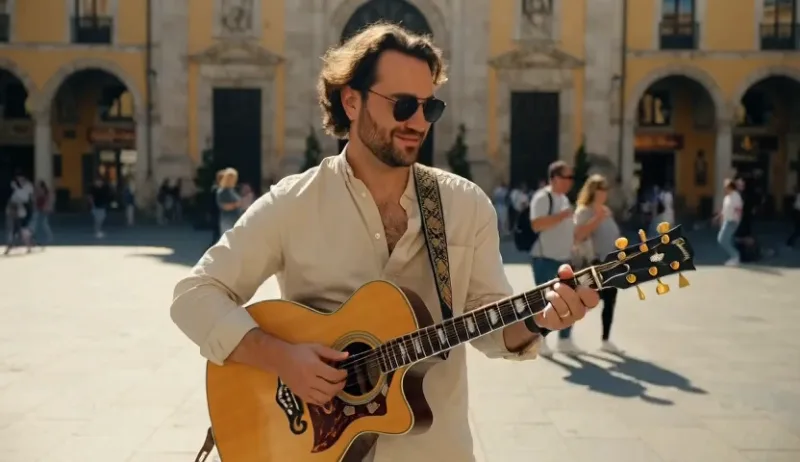
Minimax H3 Text To Video Lora
MiniMax H3 Open Weights Text to Video with custom LoRA support generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
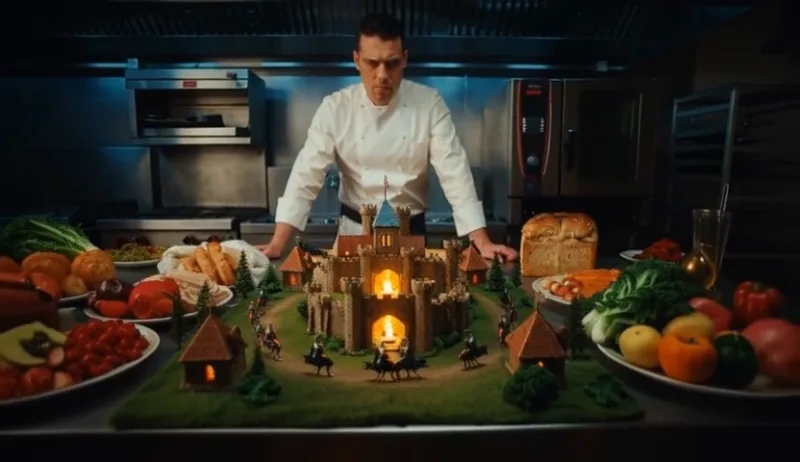
Minimax H3 Text To Video
MiniMax H3 Open Weights Text to Video generates coherent videos from text prompts, with 480P / 540P / 768P output, native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video Lora
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Minimax H3 Image To Video
MiniMax H3 Open Weights Image to Video animates a first-frame image, optionally with last-frame guidance, into coherent 480P / 540P / 768P videos with native stereo audio, 5-15 second duration, flexible aspect ratios, and per-second billing. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro Layer Decomposition
Seedream V5.0 Pro Layer Decomposition separates a single image into a base image and transparent layers, enabling flexible compositing, image editing, asset extraction, and layered design workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Seedream v5.0 Pro
Seedream V5.0 Pro Text to Image by ByteDance generates high-quality images from text prompts, with aspect ratio selection, strong prompt following, and 1K / 2K output tiers for flexible image creation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
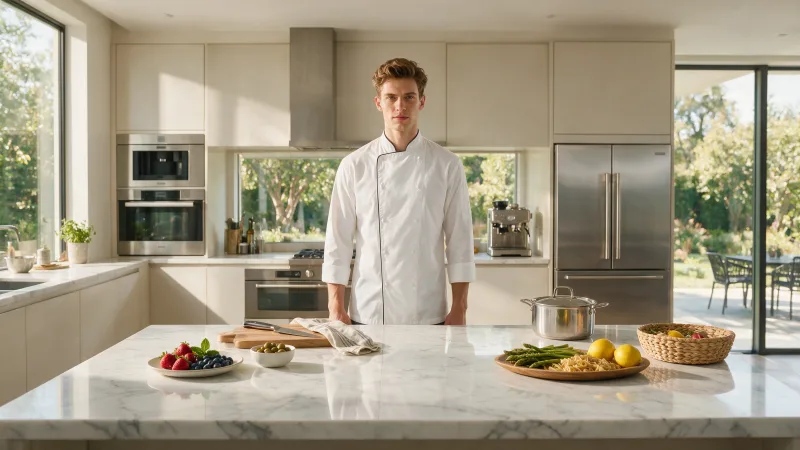
Seedream v5.0 Pro Edit
Seedream V5.0 Pro Edit by ByteDance edits and generates images from single-image or multi-reference inputs, supporting up to 10 reference images, aspect ratio selection, and 1K / 2K output tiers. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
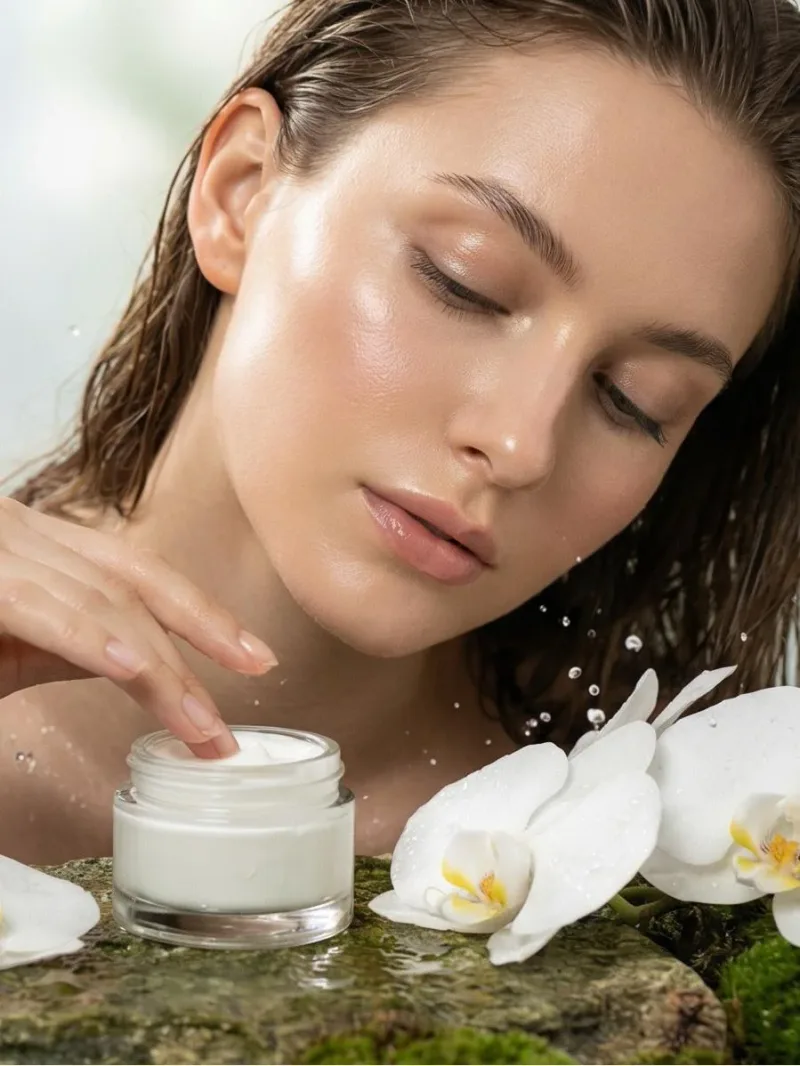
Nano Banana Pro Text To Image Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a next-generation text-to-image model capable of generating multiple high-quality images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
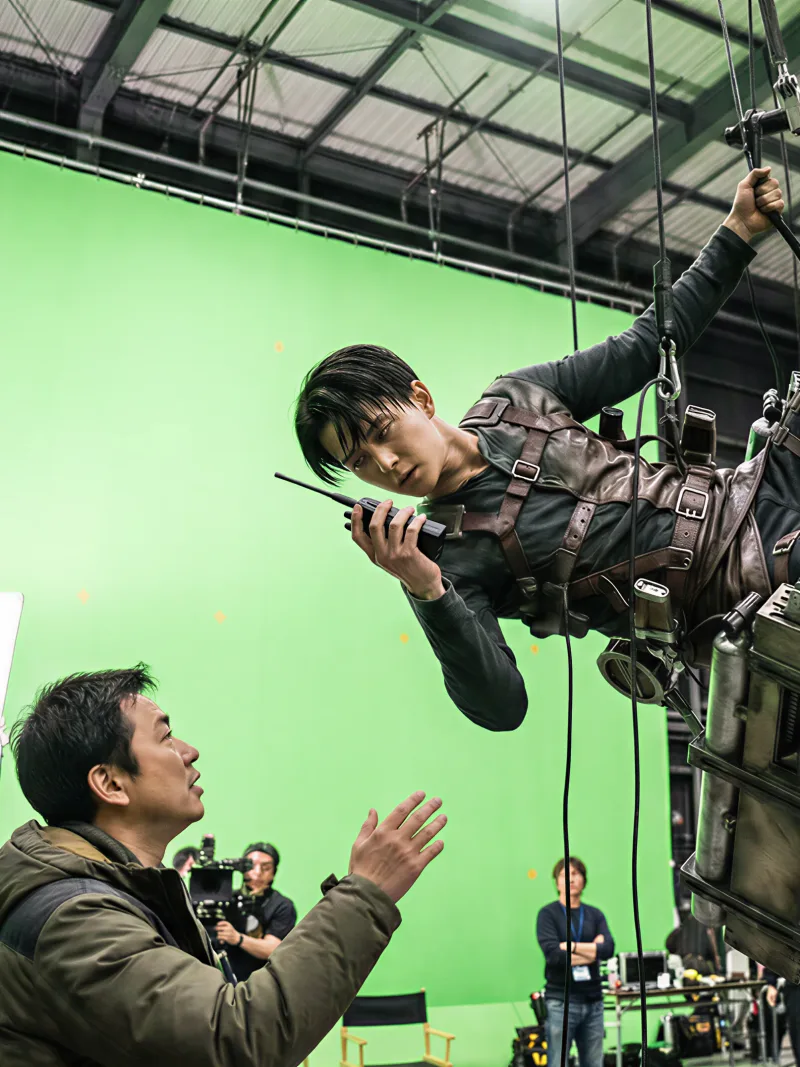
Nano Banana Pro Text To Image Ultra
Google's Nano Banana Pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
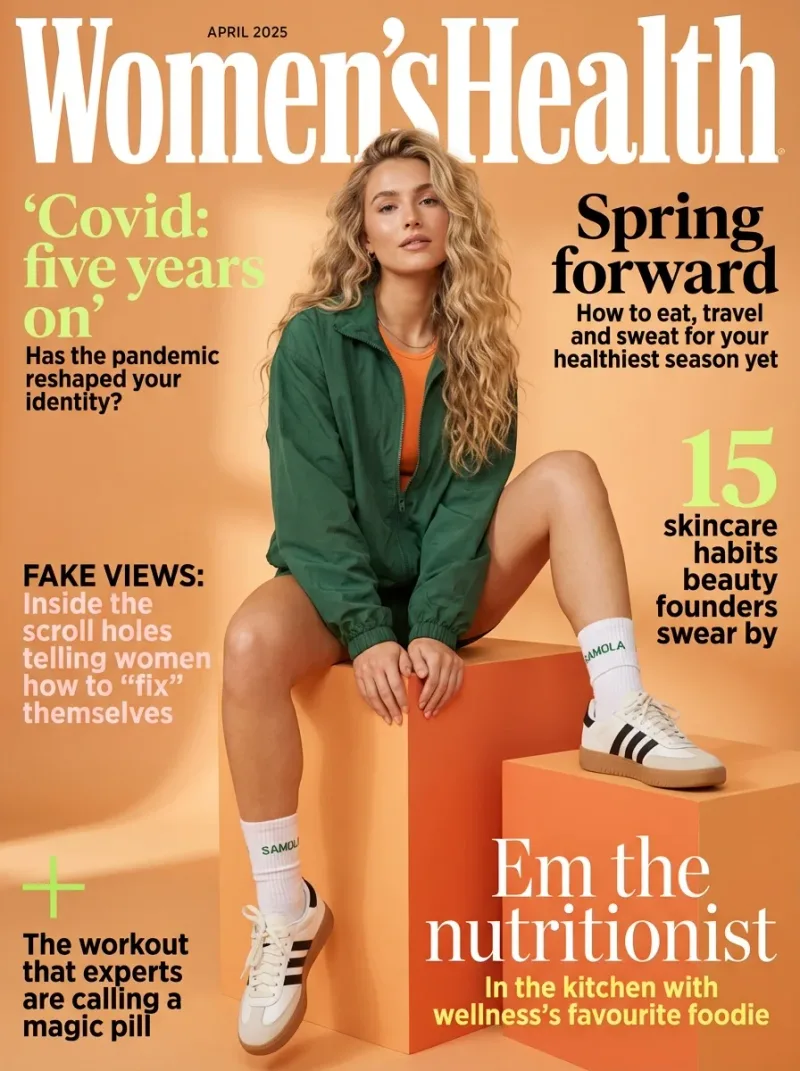
Nano Banana Pro Text To Image
Google's Nano Banana pro (Gemini 3.0 Pro Image) is a cutting-edge text-to-image model enabling high-res 4K image generation optimized for phones. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Multi
Google's Nano Banana Pro (Gemini 3.0 Pro Image) Edit is a next-generation image editing model capable of generating multiple high-quality edited images in a single run. Extremely low cost — only $0.07 per image. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit Ultra
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with highres output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana Pro Edit
Google Nano Banana Pro (Gemini 3.0 Pro Image) Edit enables image editing with 4K-capable output. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image Fast
Google Nano Banana 2 Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 option, starting at just $0.045 per image. Delivers fast text-to-image generation with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Text To Image
Google Nano Banana 2 (Gemini 3.1 Flash Image) delivers Pro-quality image generation at Flash speed with 512px to 4K resolution support. Features include improved text rendering, character consistency for up to 5 characters, and real-world knowledge integration. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit Fast
Google Nano Banana 2 Edit Fast (Gemini 3.1 Flash Image) is the cheapest Nano Banana 2 editing option, starting at just $0.045 per image. Enables fast image editing with 2K default output and 4K support. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Nano Banana 2 Edit
Google Nano Banana 2 Edit (Gemini 3.1 Flash Image) enables advanced image editing with 4K-capable output, fast iteration, and precise instruction following. Supports text translation, localization within images, and maintains subject consistency during edits. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Gpt Image 2.5 Sunburst Edit
OpenAI's GPT Image 2.5 Sunburst Edit edits one or more reference images from natural-language instructions, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
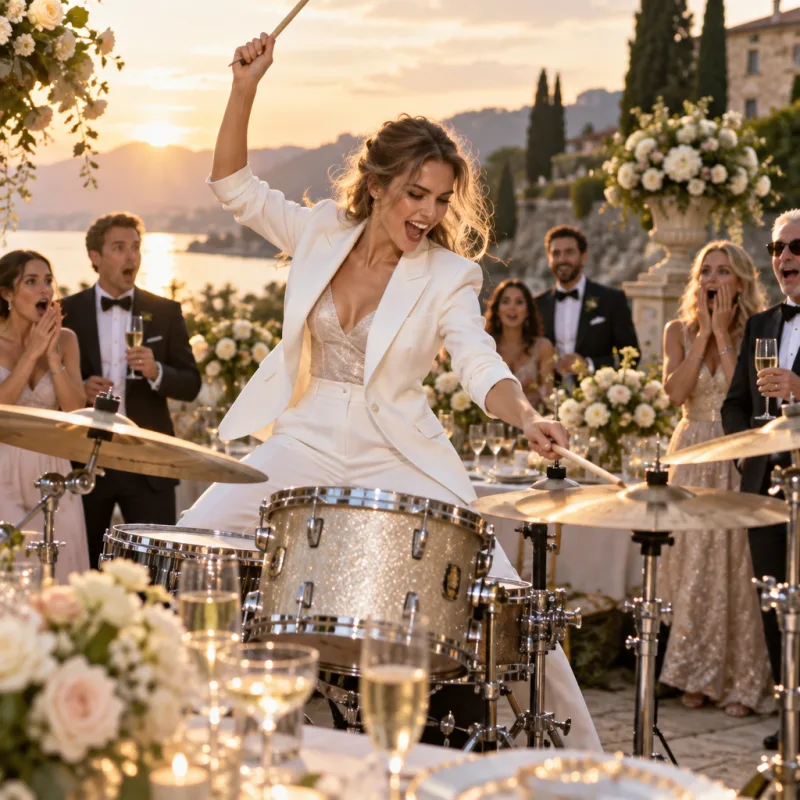
Gpt Image 2.5 Sunburst Text To Image
OpenAI's GPT Image 2.5 Sunburst Text-to-Image generates high-quality images from natural-language prompts, with five quality tiers up to 4K. Sunburst is the precision-focused GPT Image 2.5 tier that spends more time per image for extra fidelity on intricate detail. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
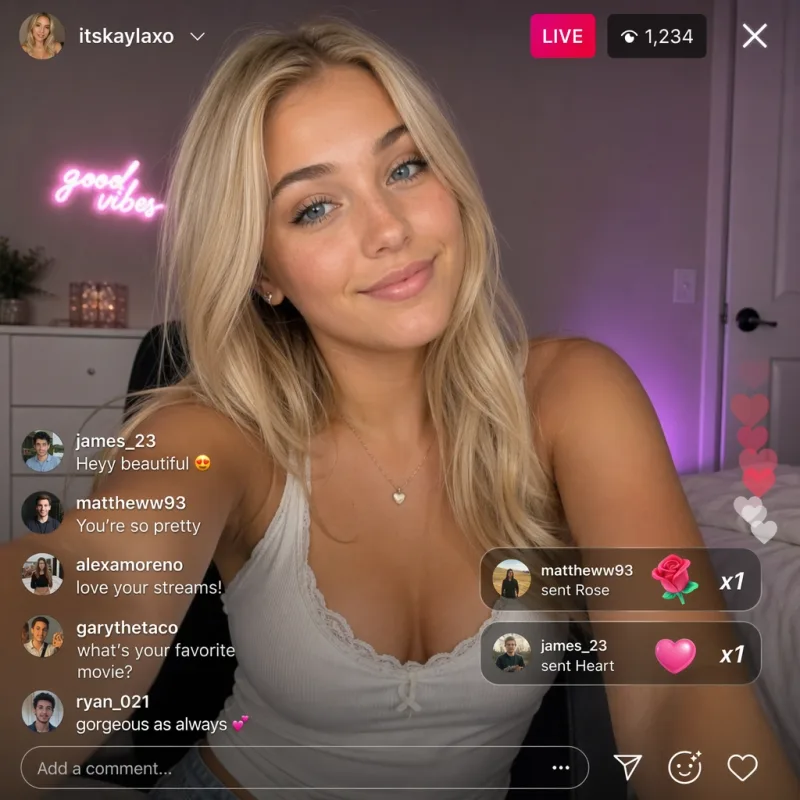
Gpt Image 2 Text To Image
OpenAI's GPT Image 2 Text-to-Image generates high-quality images from natural-language prompts. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
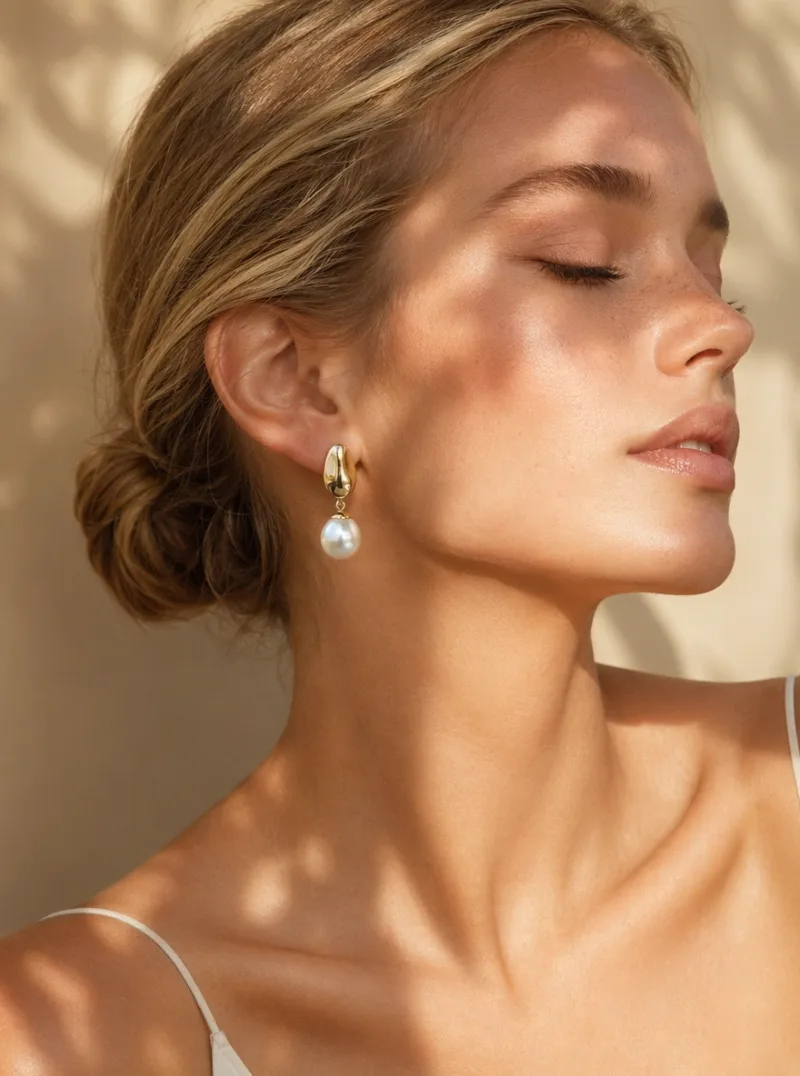
Gpt Image 2 Edit
OpenAI's GPT Image 2 Edit enables image editing from natural-language instructions with one or more reference images. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
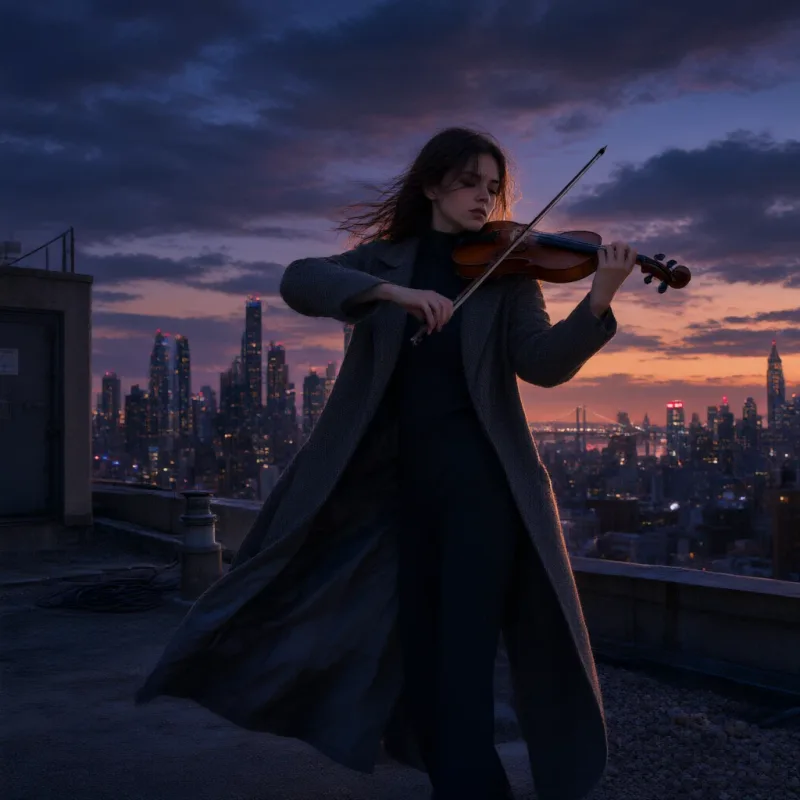
Qwen Image 3.0 Text To Image
Qwen Image 3.0 Text to Image is a high-quality image generation model that creates high-quality images from text prompts, with advanced prompt understanding, strong visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Qwen Image 3.0 Edit
Qwen Image 3.0 Edit is a high-quality image editing model that transforms existing images with natural-language instructions, delivering advanced instruction understanding, superior visual quality, and up to 2K output for creative and production workflows. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Ejemplos
Mira WaveSpeedAI en acción
Resultados reales generados con la API de WaveSpeedAI. Pasa el cursor sobre cualquier vídeo para previsualizarlo y haz clic para abrir el visor a tamaño completo.
Cómo empezar
Cómo usar la API de WaveSpeedAI
Cuatro pasos desde el registro hasta una generación terminada. Encontrarás ejemplos completos en Python, Node.js y cURL en la sección de API más abajo.
- 01
Obtén una clave de API
Regístrate en WaveSpeedAI y copia tu clave de API desde el panel. Las cuentas nuevas incluyen créditos gratuitos para empezar: suficientes para usar el playground unas decenas de veces antes de que empiece la facturación.
- 02
Envía una predicción
Haz POST de tu entrada como JSON a https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. El endpoint devuelve un id de predicción de inmediato: las generaciones son asíncronas, así que no mantienes una conexión abierta durante la inferencia.
- 03
Consulta hasta que termine
Haz GET a https://api.wavespeed.ai/api/v3/predictions/{request_id}/result. Devuelve los resultados con completed; detente con un error en failed, cancelled, timeout o deleted; sigue consultando con cualquier otro estado.
- 04
Lee la URL del resultado
Cuando status sea "completed", lee la URL de data.outputs[0]. La URL apunta a tu contenido generado en la CDN de WaveSpeedAI: imagen, vídeo, audio o archivo 3D según la variante del modelo que hayas llamado.
Casos de uso
Qué puedes crear con estos modelos
Flujos de trabajo habituales para los que desarrolladores y creadores usan estas API.
Migra una integración con la API de Higgsfield en una tarde
Ambas API son asíncronas: envías JSON, recibes un id de solicitud y después consultas el resultado o recibes un webhook. En WaveSpeedAI haces POST a /api/v3/<model> con una clave de API Bearer y lees el resultado de la predicción, así que migrar consiste sobre todo en cambiar la URL base, la cabecera de autenticación y la ruta del modelo.
Imagen y vídeo en un mismo pipeline
Genera imágenes fijas con Nano Banana Pro, Seedream 5.0 o GPT Image 2.5 y anímalas después con imagen a vídeo de Seedance 2.5, Kling 3.0 o Wan 3.0, con una sola clave y un solo saldo. El catálogo publicado de la API de Higgsfield no incluye Nano Banana, Seedream ni GPT Image.
MiniMax H3 de pesos abiertos con LoRA
WaveSpeedAI aloja MiniMax H3 de pesos abiertos con texto a vídeo, imagen a vídeo, referencia a vídeo, edición y extensión de vídeo, endpoints LoRA para estilos y personajes personalizados y un modo de texto a imagen.
Planos únicos largos y vídeo por niveles
Seedance 2.5 renderiza planos únicos de hasta 30 segundos con audio nativo; Kling 3.0 y Kling O3 vienen en niveles Standard, Pro y 4K; Wan 3.0 añade un nivel Prime. Elige para cada plano desde la misma integración.
Agentes y trabajos por lotes
Llama a todos los modelos desde los SDK de Python o JavaScript, HTTP simple, la CLI o un servidor MCP, de modo que los agentes de programación y los scripts por lotes usen los mismos endpoints y precios que tu aplicación.
Consejos
Consejos para escribir prompts en estos modelos
Consejos prácticos para obtener mejores resultados con estos modelos, basados en los patrones que funcionan en modelos de vídeo en flujos de producción.
- 01
Sé específico con los movimientos de cámara
Menciona vocabulario cinematográfico concreto: órbita, travelling de acercamiento, push-in, panorámica a la izquierda, plano grúa, seguimiento con cámara en mano. Los prompts genéricos producen decisiones de cámara estáticas o arbitrarias; los movimientos de cámara con nombre se corresponden directamente con la intención de movimiento en los datos de entrenamiento del modelo y mejoran mucho la calidad del plano.
- 02
Ancla la identidad del personaje con imágenes de referencia
Si tu prompt depende de una persona, un personaje o un producto concretos, sube una imagen de referencia junto con el prompt. Sin referencia, la identidad se desvía entre fotogramas y entre planos: el mismo personaje acaba pareciendo una persona ligeramente distinta en cada generación.
- 03
Describe la iluminación y la hora del día
Indicaciones de iluminación como «hora dorada, luz cálida direccional suave» o «luz difusa de cielo nublado, cielo gris pizarra» mejoran la calidad y la consistencia mucho más que los modificadores de calidad vagos. La iluminación es uno de los priors más fuertes en los que se condiciona el modelo.
- 04
Usa prompts negativos para suprimir los fallos habituales
Negativos útiles para vídeo: «parpadeo de fotogramas, desenfoque de movimiento, marca de agua, artefactos de texto, manos deformadas, baja resolución, compresión jpeg». Los prompts negativos no cuestan nada y reducen de forma notable la tasa de generaciones que de otro modo tendrías que repetir.
- 05
Elige la duración más corta que recoja tu momento
La mayoría de los prompts funcionan mejor con 5-8 segundos. Los clips más largos amplifican las inconsistencias temporales (el sujeto se transforma, el entorno se desvía). Si necesitas una secuencia de 20 segundos, genera tres clips de 6-8 segundos y móntalos: la calidad se mantiene más alta que con una sola generación larga.
- 06
Ajusta la relación de aspecto a la plataforma desde el principio
9:16 para TikTok / Reels / Shorts, 16:9 para feeds horizontales y YouTube, 1:1 para cuadrículas de publicaciones. Los modelos se entrenan de forma ligeramente distinta según la relación de aspecto: recortar un 16:9 a 9:16 después pierde tanto fidelidad como la composición que el modelo pretendía.
Precios
Precios de la API de WaveSpeedAI
El precio es por resultado. El cargo final depende de los parámetros que definas en el playground de cada variante (resolución, duración, número de resultados, referencias).
API
Llama a la API de WaveSpeedAI
Obtén una clave de API en wavespeed.ai/accesskey y envía una predicción por REST. El playground genera ejemplos listos para pegar con cualquier combinación de entradas.
POSThttps://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5,
    "generate_audio": true
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": true
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"aspect_ratio": "16:9",
"resolution": "720p",
"duration": 5,
"generate_audio": True
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)Comparar
WaveSpeedAI frente a Higgsfield API
En qué se diferencian WaveSpeedAI y Higgsfield API.
WaveSpeedAI frente a Higgsfield API: models
La API de Higgsfield lista 82 entradas de imagen y vídeo, incluidos sus propios modelos Soul y Cinema Studio, además de Seedance, Kling, Wan, MiniMax y Qwen Image. WaveSpeedAI cubre esas familias de terceros y añade Nano Banana, Seedream, GPT Image, Veo, audio, 3D y modelos de lenguaje: más de 1.000 en total.
WaveSpeedAI frente a Higgsfield API: credits
Los fondos de la API de Higgsfield caducan un año después de la compra. Los créditos de WaveSpeedAI no caducan y no hay membresía ni suscripción: recarga cuando lo necesites y paga por solicitud, con el precio de cada endpoint en su página de modelo y en la tabla de precios de esta página. Los mismos créditos sirven también para los estudios en el navegador.
WaveSpeedAI frente a Higgsfield API: open models
Ambas incluyen MiniMax H3. En WaveSpeedAI es el modelo de pesos abiertos alojado por WaveSpeedAI, con LoRA, referencia a vídeo, edición, extensión y endpoints de imagen junto a los de texto a vídeo e imagen a vídeo estándar.
Preguntas frecuentes
Higgsfield API Alternative — Preguntas frecuentes
Modelos, precios, migración: preguntas habituales sobre cómo pasar de Higgsfield API a WaveSpeedAI.
¿Es WaveSpeedAI una alternativa a la API de Higgsfield?
Sí. WaveSpeedAI sirve Seedance 2.5 y 2.0, Kling 3.0 y O3, Wan 3.0, MiniMax H3 y Qwen Image 3.0 como endpoints REST, además de Seedream 5.0, Nano Banana 2 y Pro, y GPT Image 2.5 y 2, con una sola clave de API y precios de pago por solicitud.
¿Qué modelos puedo llamar que la API de Higgsfield no incluye?
El catálogo de modelos publicado de la API de Higgsfield no incluye Nano Banana, Seedream, GPT Image, Veo ni modelos de audio. En WaveSpeedAI, Nano Banana 2 y Pro, Seedream 5.0, GPT Image 2.5 y 2, Veo 3.1 y las voces de ElevenLabs están detrás de la misma clave que los modelos de vídeo.
¿Cómo cambio desde la API de Higgsfield?
Crea una clave en /accesskey y envía tu entrada como JSON con POST a https://api.wavespeed.ai/api/v3/<model> con una cabecera Authorization: Bearer. Recibirás un id de predicción; consulta https://api.wavespeed.ai/api/v3/predictions/<id>/result o pasa un webhook. Asigna cada modelo a su ruta de WaveSpeedAI según la lista de endpoints de esta página.
¿MiniMax H3 en WaveSpeedAI es el modelo de pesos abiertos?
Sí. Los endpoints wavespeed-ai/minimax-h3 ejecutan MiniMax H3 de pesos abiertos en WaveSpeedAI, incluidas variantes LoRA para estilos y personajes personalizados, referencia a vídeo, edición y extensión de vídeo y un modo de texto a imagen.
¿Necesito una membresía o suscripción, y caducan los créditos?
No hay membresía ni suscripción. WaveSpeedAI es de pago por uso: recarga créditos cuando los necesites y paga por solicitud al precio que figura en cada página de modelo y en la tabla de precios de arriba. Los créditos no caducan. Las cuentas nuevas que cumplan los requisitos reciben créditos iniciales gratuitos.
¿Cómo llamo a estas API?
Regístrate en WaveSpeedAI, copia tu clave de API desde /accesskey y haz POST de tu entrada como JSON a https://api.wavespeed.ai/api/v3/<model>, por ejemplo https://api.wavespeed.ai/api/v3/bytedance/seedance-2.5/text-to-video. El endpoint devuelve un id de predicción. Consulta el endpoint de resultados o indica un webhook. Arriba tienes ejemplos en Python / Node.js / cURL.
¿Cuánto cuestan estas API?
Los endpoints de esta página empiezan en $0.02 por ejecución; el precio de cada modelo figura en la tabla de precios de arriba y en su página de modelo. El coste exacto depende de los parámetros que definas (resolución, duración, número de resultados, referencias) y el playground lo muestra antes de enviar.
Empieza a crear en WaveSpeedAI
Créditos gratuitos al registrarte. Una sola clave de API para más de 1.000 modelos de IA de todos los grandes proveedores.