Wan 3.0 API
阿里巴巴 Wan 3.0——单次生成最长可达 30 秒的电影感视频,上限是 Wan 2.7 的两倍。提供文生视频、支持首尾帧引导的图生视频,以及同时接受图像、视频和音频参考的参考生视频。输出 480p / 720p / 1080p,可选生成音频,并支持提示词扩写,以获得更高质量的运动和场景连贯性。
同一系列共三个端点:根据提示词生成的文生视频、为首帧图像添加动态并可选尾帧引导的图生视频,以及由多模态参考驱动的参考生视频。每个变体都支持 2–30 秒的时长(默认 5 秒)、480p / 720p / 1080p 输出、五种画幅比例(16:9、9:16、1:1、4:3、3:4)、可选的音频开关和提示词扩写控制。
概览
关于 Wan 3.0 API
Wan 3.0 能做什么、它在 Alibaba 模型阵容中的定位,以及团队选择它的原因。
Wan 3.0 是 Alibaba 推出的视频生成模型,可通过 WaveSpeedAI REST API 使用。阿里巴巴 Wan 3.0——单次生成最长可达 30 秒的电影感视频,上限是 Wan 2.7 的两倍。提供文生视频、支持首尾帧引导的图生视频,以及同时接受图像、视频和音频参考的参考生视频。输出 480p / 720p / 1080p,可选生成音频,并支持提示词扩写,以获得更高质量的运动和场景连贯性。
同一系列共三个端点:根据提示词生成的文生视频、为首帧图像添加动态并可选尾帧引导的图生视频,以及由多模态参考驱动的参考生视频。每个变体都支持 2–30 秒的时长(默认 5 秒)、480p / 720p / 1080p 输出、五种画幅比例(16:9、9:16、1:1、4:3、3:4)、可选的音频开关和提示词扩写控制。
WaveSpeedAI 上的 Wan 3.0 系列提供 10 个 REST 端点,涵盖 Video-Extend, Video-To-Video, Reference-To-Video, Image-To-Video, Text-To-Video 个工作流。每个变体都有各自的定价、参数选项和示例输出——请选择与你的输入模态和生产约束相匹配的那一个,或使用同一个 API 密钥调用多个变体,组合成多步骤流水线。
使用与 WaveSpeedAI 上其他 1,000 多个 AI 模型相同的 API 密钥、账单账户和速率限制来运行 Wan 3.0。无需单独对接供应商,无需各家 SDK,也无需应对各家不同的速率限制——一次集成即可覆盖从文生图、文生视频到音频合成、3D 生成、放大和编辑的全部能力。
规格
Wan 3.0 API 的能力与发布状态
开发者在选择 API 之前会搜索的模型细节:可用性、预期输出时长、参考素材支持情况,以及当前可用的在线替代方案。
最长时长
30 秒
每个变体都接受一次生成 2–30 秒,默认 5 秒。
分辨率
480p / 720p / 1080p
文生视频、图生视频和参考生视频均提供相同的三个档位。
端点
3 个变体
文生视频、图生视频(首帧 + 尾帧)、参考生视频(图像、视频、音频参考)。
画幅比例
5 种选择
每个变体均支持 16:9、9:16、1:1、4:3 和 3:4。
端点
全部 Wan 3.0 API 端点
WaveSpeedAI 现已提供 10 个 Wan 3.0 端点——请选择适合你工作流的变体。
Wan 3.0 Video Extend
Wan 3.0 Video Extend continues an existing video with a newly generated segment, preserving the source video and its original audio while supporting optional audio generation for the extension. It supports 480P / 720P / 1080P output, optional last-frame guidance, and prompt control for the next action and camera movement. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Video Edit
Wan 3.0 Video Edit edits existing videos with text prompts and optional reference images or audio, supporting prompt-guided scene changes, visual refinements, and multimodal video editing. Inputs longer than 15 seconds are trimmed to the first 15 seconds, with output aspect ratio automatically matched to the input video. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Reference To Video
Wan 3.0 Reference to Video creates coherent videos from prompts and multimodal references, including images, videos, and audio, with flexible 2-30 second duration and aspect ratio control for subject consistency, motion guidance, timing control, and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Image To Video
Wan 3.0 Image to Video animates a first-frame image into a cinematic video, with optional last-frame guidance, flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality motion and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
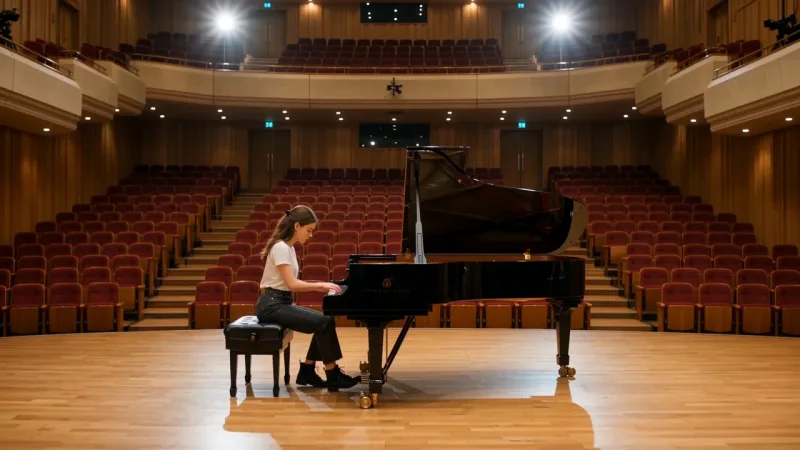
Wan 3.0 Text To Video
Wan 3.0 Text to Video generates cinematic videos from text prompts, with flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality video generation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
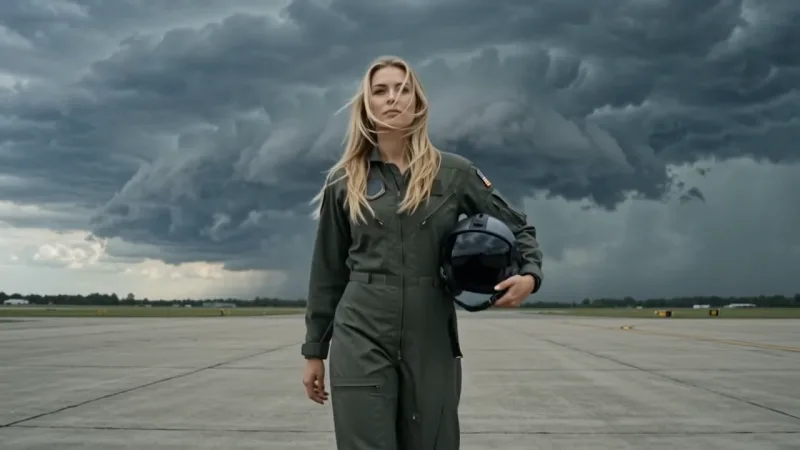
Wan 3.0 Prime Video Extend
Wan 3.0 Prime Video Extend continues existing videos by generating a new 2-30 second segment from the final frame and appending it to the retained source video. It preserves existing source audio, supports optional audio generation for the new segment, retains up to the last 120 seconds of input, and outputs at 480P / 720P / 1080P. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
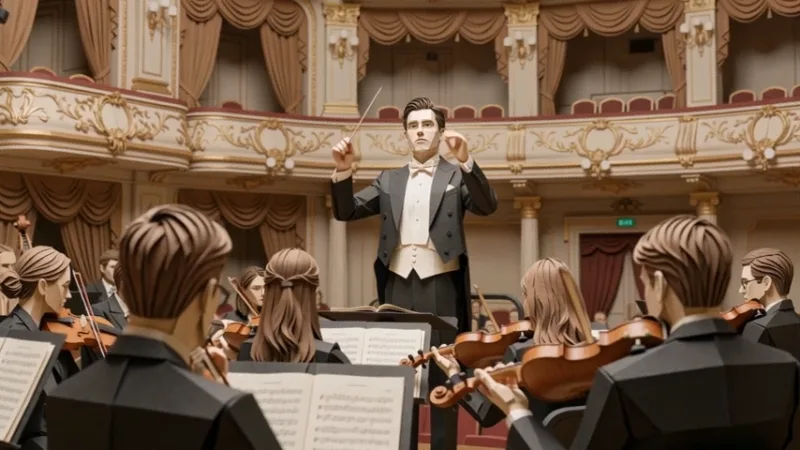
Wan 3.0 Prime Video Edit
Wan 3.0 Prime Video Edit edits existing videos with text prompts and optional reference images or audio, supporting prompt-guided scene changes, visual refinements, and multimodal video editing. Inputs longer than 15 seconds are trimmed to the first 15 seconds, with output aspect ratio automatically matched to the input video. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
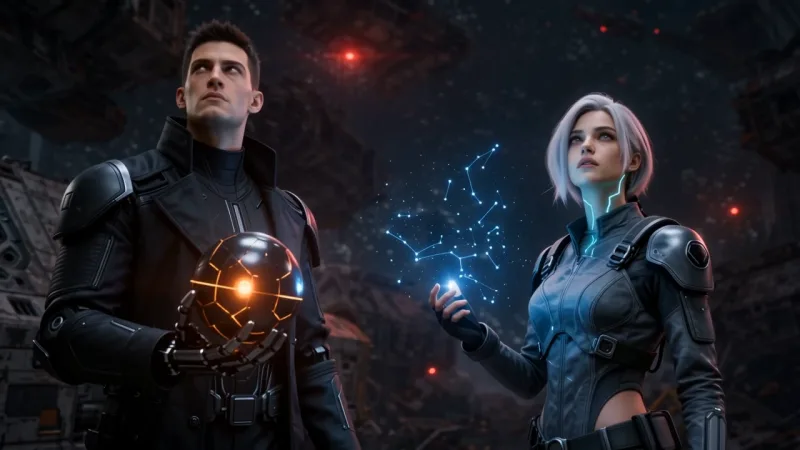
Wan 3.0 Prime Reference To Video
Wan 3.0 Prime Reference to Video is an accelerated variant that creates coherent videos from prompts and multimodal references, including images, videos, and audio, with flexible 2-30 second duration and aspect ratio control for subject consistency, motion guidance, timing control, and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Prime Text To Video
Wan 3.0 Prime Text to Video is an accelerated variant that generates cinematic videos from text prompts, with flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality video generation. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
Wan 3.0 Prime Image To Video
Wan 3.0 Prime Image to Video is an accelerated variant that animates a first-frame image into a cinematic video, with optional last-frame guidance, flexible 2-30 second duration, aspect ratio control, optional audio, and deep-thinking controls for high-quality motion and scene continuity. Ready-to-use REST inference API, best performance, no coldstarts, affordable pricing.
示例
看看 Wan 3.0 的实际效果
由 Wan 3.0 API 生成的真实输出。悬停在任意视频上即可预览,点击可打开全尺寸查看器。
使用方法
如何使用 Wan 3.0 API
从注册到完成一次生成,只需四步。完整的 Python、Node.js 和 cURL 示例见下方的 API 部分。
- 01
获取 API 密钥
注册 WaveSpeedAI 账号,并从控制台复制你的 API 密钥。新账号附带免费体验额度——足够在开始计费前把 Playground 运行几十次。
- 02
提交预测
把你的输入以 JSON 形式 POST 到 https://api.wavespeed.ai/api/v3/alibaba/wan-3.0/text-to-video。端点会立即返回预测 ID——生成是异步的,因此推理期间你无需保持连接。
- 03
轮询完成状态
GET https://api.wavespeed.ai/api/v3/predictions/{request_id}/result。状态为 completed 时返回输出;状态为 failed、cancelled、timeout 或 deleted 时以错误终止;其他任何状态都继续轮询。
- 04
读取输出 URL
状态变为 "completed" 后,从 data.outputs[0] 读取 URL。该 URL 指向 WaveSpeedAI CDN 上你生成的媒体——具体是图片、视频、音频还是 3D 文件,取决于你调用的 Wan 3.0 变体。
应用场景
用 Wan 3.0 可以构建什么
开发者和创作者使用 Wan 3.0 API 的常见工作流。
最长 30 秒的单次生成镜头
每个 Wan 3.0 变体都接受 2–30 秒的时长。由于片段由一次生成得出,连续的运镜或一镜到底的镜头语言可以贯穿全程,而不是由较短片段拼接而成。Wan 2.7 最长只有 15 秒。
带提示词扩写的文生视频
alibaba/wan-3.0/text-to-video 把提示词变成电影感片段。目录定位:画幅比例控制、可选音频和提示词扩写,实现高质量视频生成。当一切尚未确定、仅凭描述来构建镜头时,请选择它。
带首尾帧的图生视频
alibaba/wan-3.0/image-to-video 为首帧图像添加动态,并可通过 last_image 字段提供尾帧引导。当开头和结尾的构图都已确认、只需生成两者之间的运动时很有用。
同时使用图像、视频和音频参考的参考生视频
alibaba/wan-3.0/reference-to-video 在同一次请求中接受 reference_images、reference_videos 和 reference_audios——用于主体一致性、运动引导、节奏控制和场景连贯性。音频参考通道是它区别于 Wan 系列中其他仅支持图像参考的变体之处。
480p 出草稿,1080p 交付
三个变体都提供 480p、720p 和 1080p。Wan 2.7 从 720p 起步,所以 3.0 新增了真正廉价的草稿档位——先用 480p 迭代提示词和节奏,再以 1080p 重新运行确定后的提示词用于交付。
竖屏、方形和宽屏画幅
每个变体都提供五种画幅比例(16:9、9:16、1:1、4:3、3:4),因此同一条提示词可以重新运行,分别生成横屏主视觉版本、9:16 社交版本和 1:1 信息流版本,无需后期裁剪。
技巧
Wan 3.0 提示词技巧
让 Wan 3.0 输出更好结果的实用建议——总结自生产流水线中各类视频模型都适用的做法。
- 01
明确说明运镜方式
使用具体的摄影术语——orbit、dolly-in、push-in、pan-left、crane shot、handheld follow。笼统的提示词会产生静止或随意的镜头选择;命名的运镜方式能直接对应到模型训练数据中的运动意图,大幅提升镜头质量。
- 02
用参考图像锚定角色身份
如果提示词依赖特定的人物、角色或产品,请在提示词之外上传参考图像。没有参考时,身份会在帧与帧之间、镜头与镜头之间漂移——同一个角色每次生成看起来都像略有不同的人。
- 03
描述光线和时间
「黄金时刻,柔和温暖的定向光」或「阴天漫射光,石板灰的天空」这类光线提示,比含糊的画质修饰词更能提升质量和一致性。光线是模型所依据的最强先验之一。
- 04
用负面提示词抑制常见的失败模式
视频常用的负面提示词:「帧闪烁、运动模糊、水印、文字伪影、变形的手、低分辨率、JPEG 压缩」。负面提示词不花一分钱,却能明显降低您原本需要重新抽取的生成比例。
- 05
选择能涵盖该节拍的最短时长
大多数提示词在 5-8 秒时效果最好。更长的片段会放大时间上的不一致(主体变形、环境漂移)。如果需要 20 秒的序列,请生成三段 6-8 秒的片段再剪辑在一起——质量比一次长生成更高。
- 06
预先让画幅比例匹配平台
TikTok / Reels / Shorts 用 9:16,横屏信息流和 YouTube 用 16:9,帖子宫格用 1:1。模型对每种画幅比例的训练略有不同——事后把 16:9 裁成 9:16,会同时损失保真度和模型原本设计的构图。
定价
Wan 3.0 API 定价
按输出计费。最终费用会随你在各变体 Playground 中设置的参数(分辨率、时长、输出数量、参考素材)而变化。
| 端点 | 类型 | 起步价 |
|---|---|---|
| alibaba/ | video-extend | $0.10 |
| alibaba/ | video-to-video | $0.10 |
| alibaba/ | reference-to-video | 立减 5%$0.30$0.285 |
| alibaba/ | image-to-video | 立减 5%$0.10$0.095 |
| alibaba/ | text-to-video | 立减 5%$0.10$0.095 |
| alibaba/ | video-extend | $0.15 |
| alibaba/ | video-to-video | $0.15 |
| alibaba/ | reference-to-video | 立减 5%$0.45$0.4275 |
| alibaba/ | text-to-video | 立减 5%$0.15$0.1425 |
| alibaba/ | image-to-video | 立减 5%$0.15$0.1425 |
API
调用 Wan 3.0 API
在 wavespeed.ai/accesskey 注册并获取 API 密钥,然后通过 REST 提交预测。Playground 可以为任意输入组合生成可直接粘贴的示例代码。
POSThttps://api.wavespeed.ai/api/v3/alibaba/wan-3.0/text-to-video
# 1. Submit the prediction.
SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  -X POST "https://api.wavespeed.ai/api/v3/alibaba/wan-3.0/text-to-video" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $WAVESPEED_API_KEY" \
  -d '{
    "prompt": "A cinematic shot of a city at sunset, soft golden light",
    "resolution": "720p",
    "aspect_ratio": "16:9",
    "duration": 5,
    "enable_prompt_expansion": false,
    "generate_audio": true
}')

TASK=$(printf '%s' "$SUBMIT_RESPONSE" | jq 'if has("data") then .data else . end')
PREDICTION_ID=$(printf '%s' "$TASK" | jq -r '.id')
if [ -z "$PREDICTION_ID" ] || [ "$PREDICTION_ID" = "null" ]; then
  printf 'Submission response did not contain a prediction id
' >&2
  exit 1
fi
RESULT_URL="https://api.wavespeed.ai/api/v3/predictions/$PREDICTION_ID/result"

# 2. Poll until the prediction finishes.
while true; do
  RESPONSE=$(curl --silent --show-error --fail-with-body "$RESULT_URL" \
    -H "Authorization: Bearer $WAVESPEED_API_KEY")
  RESULT=$(printf '%s' "$RESPONSE" | jq 'if has("data") then .data else . end')
  STATUS=$(printf '%s' "$RESULT" | jq -r '.status')
  case "$STATUS" in
    completed) printf '%s\n' "$RESULT" | jq '.outputs'; break ;;
    failed|cancelled|timeout|deleted) printf '%s\n' "$RESULT" | jq . >&2; exit 1 ;;
    *) sleep 2 ;;
  esac
done
const submitUrl = "https://api.wavespeed.ai/api/v3/alibaba/wan-3.0/text-to-video";
const apiKey = process.env.WAVESPEED_API_KEY;
if (!apiKey) throw new Error('Set WAVESPEED_API_KEY');
async function requestJson(url, options = {}) {
const response = await fetch(url, options);
if (!response.ok) throw new Error(await response.text());
return response.json();
}
// 1. Submit the prediction.
const body = await requestJson(submitUrl, {
method: "POST",
headers: {
"Authorization": `Bearer ${apiKey}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"resolution": "720p",
"aspect_ratio": "16:9",
"duration": 5,
"enable_prompt_expansion": false,
"generate_audio": true
}),
});
const task = body.data ?? body;
const resultUrl = `https://api.wavespeed.ai/api/v3/predictions/${task.id}/result`;
// 2. Poll until the prediction finishes.
while (true) {
const resultBody = await requestJson(resultUrl, {
headers: { "Authorization": `Bearer ${apiKey}` },
});
const result = resultBody.data ?? resultBody;
if (result.status === "completed") {
console.log(result.outputs);
break;
}
if (["failed", "cancelled", "timeout", "deleted"].includes(result.status)) throw new Error(JSON.stringify(result));
await new Promise(resolve => setTimeout(resolve, 2000));
}import json
import os
import time
from urllib.request import Request, urlopen
api_key = os.environ["WAVESPEED_API_KEY"]
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
payload = {
"prompt": "A cinematic shot of a city at sunset, soft golden light",
"resolution": "720p",
"aspect_ratio": "16:9",
"duration": 5,
"enable_prompt_expansion": False,
"generate_audio": True
}
def request_json(url, data=None):
request = Request(url, data=data, headers=headers, method="POST" if data else "GET")
with urlopen(request) as response:
return json.load(response)
# 1. Submit the prediction.
body = request_json("https://api.wavespeed.ai/api/v3/alibaba/wan-3.0/text-to-video", json.dumps(payload).encode())
task = body.get("data", body)
result_url = f"https://api.wavespeed.ai/api/v3/predictions/{task['id']}/result"
# 2. Poll until the prediction finishes.
while True:
result_body = request_json(result_url)
result = result_body.get("data", result_body)
status = result.get("status")
if status == "completed":
print(result.get("outputs", []))
break
if status in {"failed", "cancelled", "timeout", "deleted"}:
raise RuntimeError(result)
time.sleep(2)对比
Wan 3.0 与其他方案对比
在 WaveSpeedAI 上,何时应选择 Wan 3.0 而不是同类模型。
Wan 3.0 对比 Wan 2.7
Wan 3.0 将时长上限翻倍——从 15 秒到 30 秒——并新增 480p 档位,以及 2.7 没有开放的 generate_audio 和 enable_prompt_expansion 控制。Wan 2.7 仍然是覆盖面更广的系列:它提供 video-edit、video-extend、image-edit 和 text-to-image 变体,而 3.0 的三个端点并未涵盖这些。
Wan 3.0 对比 Seedance 2.0
Seedance 2.0 可达 4K,而 Wan 3.0 最高为 1080p,但 Seedance 最长只有 15 秒。这是分辨率与镜头长度之间的取舍:需要在 4K 下依然出色的短片选 Seedance,需要长时间连续镜头选 Wan 3.0。
Wan 3.0 对比 Happy Horse 1.1
同样来自阿里巴巴的 Happy Horse 1.1 支持 720p/1080p,最长 15 秒,定位于流畅的运镜。Wan 3.0 在时长上占优,并新增 480p 草稿档位;Happy Horse 提供 video-extend,而 Wan 3.0 没有。
常见问题
Wan 3.0 API — 常见问题
定价、许可、集成——关于在 WaveSpeedAI 上运行 Wan 3.0 的常见问题。
Wan 3.0 视频最长可以多长?
2 到 30 秒,每次请求单独设置,默认 5 秒。整段视频在一次生成中完成,而不是拼接而成,因此连续的运镜可以贯穿整个时长。
Wan 3.0 和 Wan 2.7 有什么区别?
Wan 3.0 将最长时长从 15 秒提高到 30 秒,在 720p 之下新增 480p 输出档位,并开放了明确的 generate_audio 和 enable_prompt_expansion 控制。Wan 2.7 涵盖更多任务类型——它新增了 video-edit、video-extend、image-edit 和 text-to-image 端点,这些是 Wan 3.0 所没有的。
Wan 3.0 可以随视频一起生成音频吗?
可以。每个变体都提供可选的音频开关。参考生视频变体除图像和视频参考外,还接受音频参考,可用于节奏控制和场景连贯性。
应该使用哪个 Wan 3.0 端点?
仅凭描述构建镜头时用文生视频;开头画面已确认时用图生视频(可选提供尾帧以固定结尾构图);需要以现有的图像、视频或音频引导身份、运动或节奏时用参考生视频。
Wan 3.0 API 是什么?
Wan 3.0 是 Alibaba 的视频生成模型,在 WaveSpeedAI 上以 REST API 形式提供。阿里巴巴 Wan 3.0——单次生成最长可达 30 秒的电影感视频,上限是 Wan 2.7 的两倍。提供文生视频、支持首尾帧引导的图生视频,以及同时接受图像、视频和音频参考的参考生视频。输出 480p / 720p / 1080p,可选生成音频,并支持提示词扩写,以获得更高质量的运动和场景连贯性。你可以通过编程方式调用它,也可以在上方链接的 Playground 中试用。
如何调用 Wan 3.0 API?
注册 WaveSpeedAI 账号,从 /accesskey 复制你的 API 密钥,然后把输入以 JSON 形式 POST 到 https://api.wavespeed.ai/api/v3/alibaba/wan-3.0/text-to-video。端点会返回预测 ID。从大约每 2 秒一次开始轮询结果端点,长耗时任务可适当拉长间隔,并在任何终止状态时停止。上方有面向生产环境的 Python / Node.js / cURL 示例。
Wan 3.0 API 的费用是多少?
Wan 3.0 $0.095 起。实际费用会随你设置的参数(分辨率、时长、输出数量、参考素材)而变化。Playground 中“生成”按钮旁的实时费用预览会显示你当前输入对应的准确价格。
有哪些 Wan 3.0 变体可用?
WaveSpeedAI 托管了 10 个已上线的 Wan 3.0 端点:alibaba/wan-3.0/video-extend, alibaba/wan-3.0/video-edit, alibaba/wan-3.0/reference-to-video, alibaba/wan-3.0/image-to-video, alibaba/wan-3.0/text-to-video, alibaba/wan-3.0-prime/video-extend, alibaba/wan-3.0-prime/video-edit, alibaba/wan-3.0-prime/reference-to-video等。每个变体都有自己的 Playground 页面和定价。
Wan 3.0 的输出可以商用吗?
商用权利遵循 Alibaba 的模型许可。大多数 Alibaba 模型允许商用输出;具体许可摘要请查看各模型的 Playground 页面,平台层面的条件请参阅 WaveSpeedAI 的服务条款。
为什么要在 WaveSpeedAI 上使用 Wan 3.0,而不是直接对接?
一个 API 密钥、一个账单账户,即可使用 Wan 3.0 以及来自其他提供方的 1,000 多个 AI 模型。无需逐家配置 SDK,无需应对各自独立的速率限制,也无需为每家重写集成代码。价格通常与 Alibaba 直接提供的 API 持平或更低。
提供方
关于 Alibaba
Wan 3.0 及 WaveSpeedAI 上 Alibaba 更多模型背后的团队。
阿里巴巴通义实验室推出了 Wan 系列视频模型和 Qwen 系列大语言模型。Wan 以开放权重发布、变体覆盖广泛(文生视频、图生视频、参考生视频、视频编辑、视频延长、图像编辑、文生图)而著称,并在运动稳定性和跨多语言提示词的提示词遵循方面表现稳定。
在 WaveSpeedAI 上用 Wan 3.0 开始构建
注册即送免费体验额度。一个 API 密钥,即可使用来自 Alibaba 及其他所有提供方的 1,000 多个 AI 模型。